5 个维度看懂 DeepSeek AI 的能力边界
deepseek ai是深度求索 2023 年在杭州成立后推出的国产大模型,涵盖公司、开源 V3/R1 模型与网页版及 API 服务三个层面。其 V3 采用混合专家架构,总参数达 6710 亿,训练成本仅约 558 万美元。R1 推理模型运行价格比 OpenAI 的 ChatGPT-o1 便宜约 95%,并在数学与代码基准上对标顶级闭源模型。
核心要点
- DeepSeek 2023年成立于杭州,2025年1月推出免费应用
- V3采用MoE架构,总参数6710亿,仅激活部分专家省算力
- R1运行价格比ChatGPT-o1便宜约95%,适合中小团队
- 训练成本约558万美元,用FP8低精度训练省显存
- 开源权重可免费下载,本地部署保护数据隐私
关键速览
- DeepSeek 2023 年成立于杭州,2025 年 1 月推出免费应用。
- DeepSeek-V3 采用混合专家架构,总参数 6710 亿。
- R1 推理模型在数学与代码基准上对标顶级闭源模型。
- 训练成本约 558 万美元,远低于行业常见数亿规模。
- 开源权重可本地部署,适合对数据隐私敏感的企业。
DeepSeek AI 到底是什么?
DeepSeek AI 指三个不同层面:一是深度求索公司,一家 2023 年在中国杭州成立的 AI 研究机构;二是它开源的 V3、R1 等大语言模型,模型权重公开,任何人可下载部署;三是面向用户的网页版与 API 服务。这三层对应三种使用路径:研究成果、可自托管的模型文件、开箱即用的线上服务。
它被称作国产大模型挑战者,核心原因是成本
Britannica 2025 年报道称,推理模型 DeepSeek-R1 的运行价格比OpenAI的ChatGPT-o1 便宜约 95%。开放权重加极低成本,让中小团队也能把旗舰级模型下载到自有服务器本地运行。
DeepSeek AI 是如何工作的?
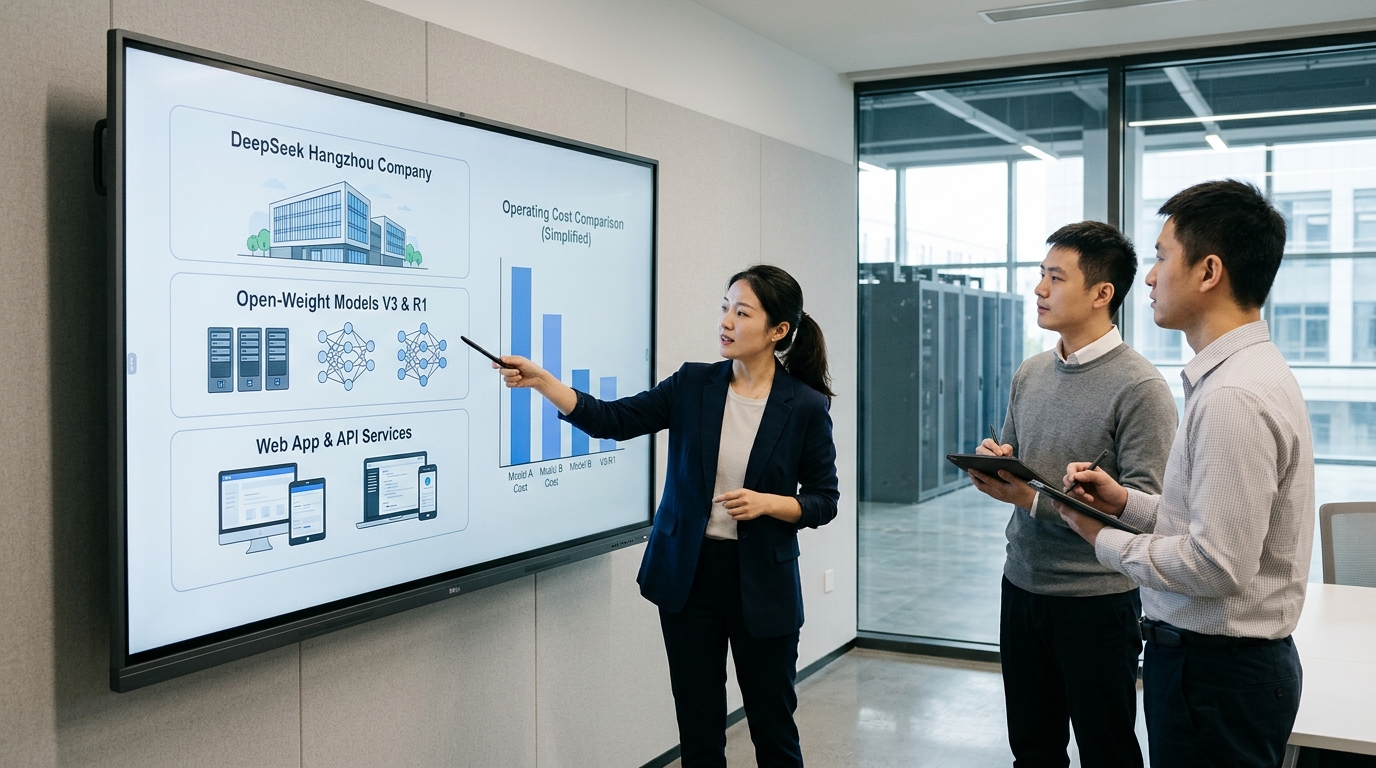
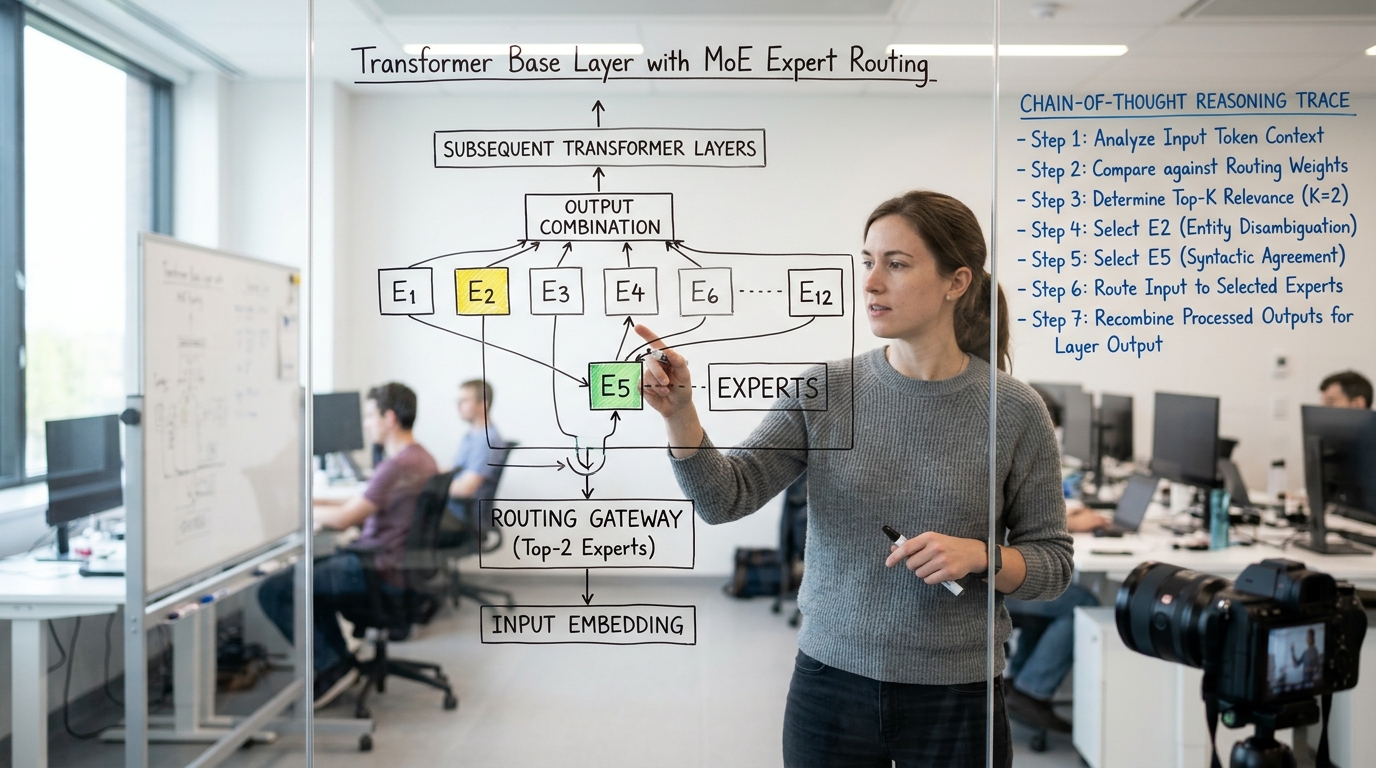
DeepSeek AI 的底层是 Transformer 架构,再叠加 MoE(混合专家,指模型内部拆成多个子网络)。它每次只唤醒其中一小部分专家处理你的问题,而非调动全部 6710 亿参数。这样既保住大模型的理解力,又把计算开销压下来。
以 2025 年 1 月发布的 DeepSeek-R1 为例
它会先写出一步步的链式思考,再给结论,推理过程直接可见,便于核查它是否走错方向。只激活部分专家而非全部参数,正是它能把运行价格压到比 ChatGPT-o1 低约 95% 的关键。
DeepSeek 的训练成本为何能压到数百万美元?
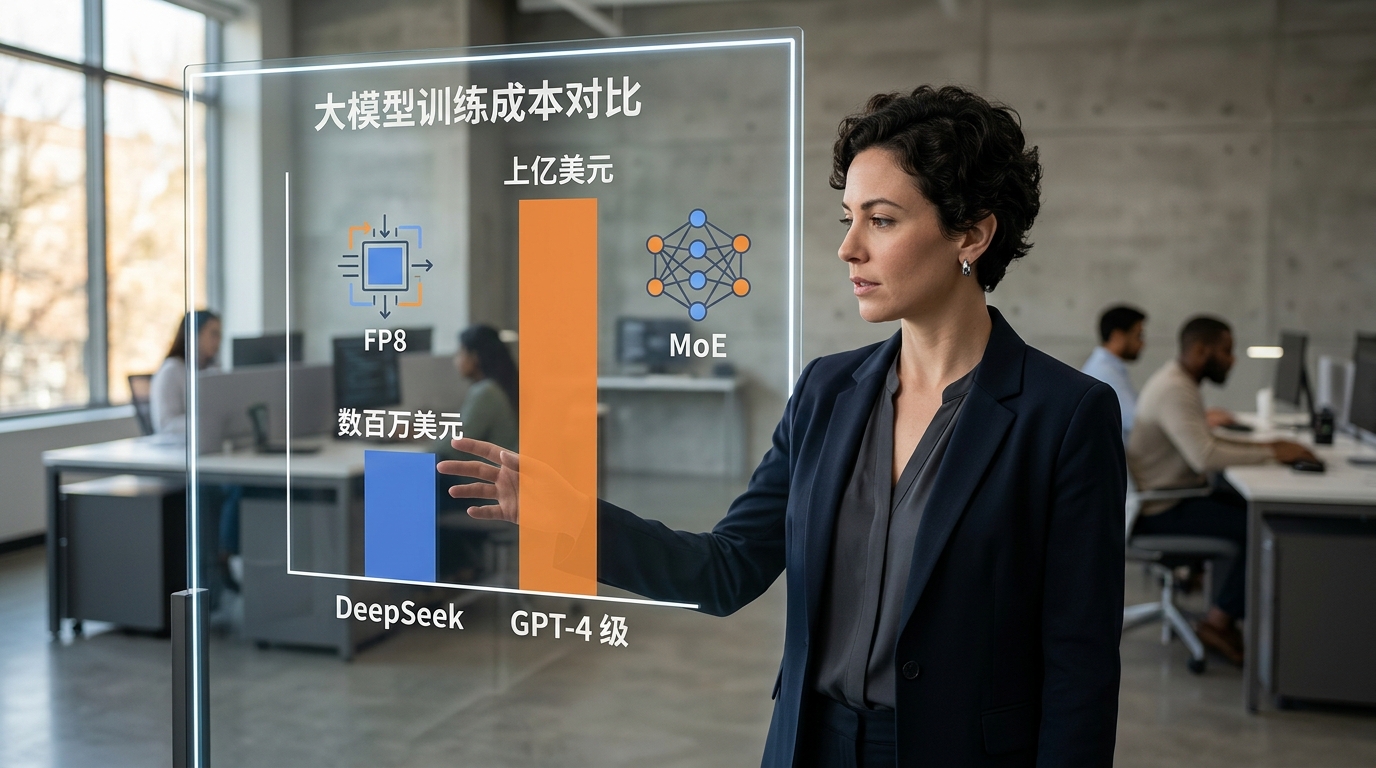
DeepSeek AI 把训练成本压到约 558 万美元,靠三招:MoE 稀疏激活省算力、FP8 低精度训练省显存、开源权重省分发费。相比之下 GPT-4 级模型训练动辄上亿美元,而 R1 的运行成本也比 OpenAI 的 ChatGPT-o1 便宜约 95%(Britannica,2025)。
- FP8 低精度:用 8 位浮点数算权重,显存占用减半,训练更快。
- MoE 稀疏激活:每次只唤醒部分专家,算力不随总参数线性涨。
- 开源权重:权重公开免授权费,社区替厂商分摊部署成本。
对中小团队而言,这意味着可以把 DeepSeek AI 下载到自有服务器本地部署,不必为天价 API 持续买单。
DeepSeek 和 ChatGPT、Claude 相比,谁更强?
没有谁全面胜出,三者各有主场。DeepSeek AI 在中文理解和 API 成本上领先,R1 运行成本比 ChatGPT-o1 便宜约 95%(Britannica,2025);但一旦任务涉及图像、语音等多模态输入,或需要第三方插件生态,它就落后于 ChatGPT 和 Claude。换句话说,成本和中文是它的优势项,多模态和生态是它的短板项。
| 维度 | DeepSeek | ChatGPT | Claude |
|---|---|---|---|
| 中文理解 | 强 | 中 | 中 |
| API 成本 | 最低 | 高 | 较高 |
| 多模态 | 弱 | 强 | 中 |
| 插件生态 | 弱 | 强 | 中 |
选型建议:中文任务加成本敏感选 DeepSeek,图像语音需求选 ChatGPT。
DeepSeek AI 实际能做什么,哪些做得不够好?
DeepSeek AI 擅长中文写作、代码生成和数学推理,R1 模型的推理链能拆解复杂题目;但它会出现幻觉(编造不存在的事实),长文档越往后分析越容易丢细节。桌面端 use 可在后台编辑本地文件、处理长任务(DeepSeek,2026)。
具体到代码场景,DeepSeek Coder(2023 年起)写 Python 很稳
短板同样具体:超长上下文会衰减,多轮对话里早期指令常被遗忘。对应的实操办法是把重要约束在每轮都重复一遍,别指望它记住十轮前说过的话。
企业用 DeepSeek 该怎么规避数据隐私与合规风险?
关键原则是敏感数据不走网页端。企业用 DeepSeek AI 处理客户信息或源代码时,应选本地私有化部署,模型权重开源(V3、R1 均为开放权重,Britannica,2025),可下载到自有服务器,数据不出内网。
| 使用方式 | 数据存储位置 | 适用场景 |
|---|---|---|
| 网页端 | 官方服务器 | 非敏感、临时问答 |
| 官方 API | 官方服务器 | 一般业务 |
| 本地私有化 | 企业自有服务器 | 敏感数据、合规场景 |
常见误区是以为 API 比网页端更安全,其实如上表所示,两者数据都上传到官方服务器。唯有私有化部署能让数据留在内网,满足数据本地化合规要求。
总结与选型建议
预算紧、中文为主、能自建服务器的团队首选 DeepSeek AI;要多模态和成熟插件生态的团队,选它反而吃亏。R1 推理成本比 ChatGPT-o1 便宜约 95%(Britannica,2025),这是它最硬的选型理由。
- 适合:中文内容、代码生成、数学推理场景,且能把开放权重模型下载到内网私有化部署的团队。
- 不适合:重度依赖图像输入、第三方插件或长文档全程无丢失的业务。
落地三步:先用免费网页版试跑真实任务;敏感数据改走本地部署;长任务用桌面端 use 在后台处理(DeepSeek,2026)。