DeepSeek 的 4 层认知框架:模型、推理、代码与应用
DeepSeek 是中国杭州公司深度求索开发的开源权重大模型,2023 年 7 月由梁文锋创立、量化基金 High-Flyer 出资。它采用 MoE 混合专家架构,2025 年 1 月推出对标 GPT-4o 的 R1 推理模型,据 MIT CSAIL 资料训练成本仅约 600 万美元,远低于主流闭源模型的数亿美元。与 ChatGPT 最大的区别在于权重公开、可免费本地部署,API 价格也远低于主流闭源模型,适合大规模调用。
核心要点
- DeepSeek 权重公开可本地部署,ChatGPT 参数封闭只能走官方接口
- R1 推理模型训练成本约 600 万美元,远低于闭源数亿投入
- 数学逻辑题选 R1,写代码选 Coder,日常问答用 V3
- MoE 架构单次只激活部分专家,省显存且精度不降
- 开源权重仅指参数可下载,训练数据不开放无法复现
关键速览
- DeepSeek 2023 年 7 月成立于杭州,由 High-Flyer 资助
- 4 层框架:模型层、推理层、代码层、应用层逐级递进
- 推理模型 R1 专攻数学与逻辑,通用模型 V3 负责对话
- DeepSeek-Coder 支持 80 多种编程语言的代码补全
- API 价格远低于主流闭源模型,适合大规模调用
DeepSeek 是什么?它和 ChatGPT 有什么区别?
DeepSeek 是中国杭州公司深度求索开发的开源权重大模型,与ChatGPT的核心差别在于权重公开、可免费本地部署。它由梁文锋在 2023 年 7 月创立并由 High-Flyer 资助,2025 年 1 月推出对标 GPT-4o 的 R1 模型。ChatGPT 的参数封闭、只能通过官方接口调用,而 DeepSeek 的参数可下载,任何人都能在自己的机器上跑起来。
另一个差距是训练成本
MIT CSAIL 称 R1 训练成本约 600 万美元,远低于主流闭源模型的数亿美元投入。需要说明的是「开源权重」只指参数公开可下载,训练数据并不开放许可,你能自己部署,却无法从零复现它的训练过程。
DeepSeek 的推理原理是怎么工作的?
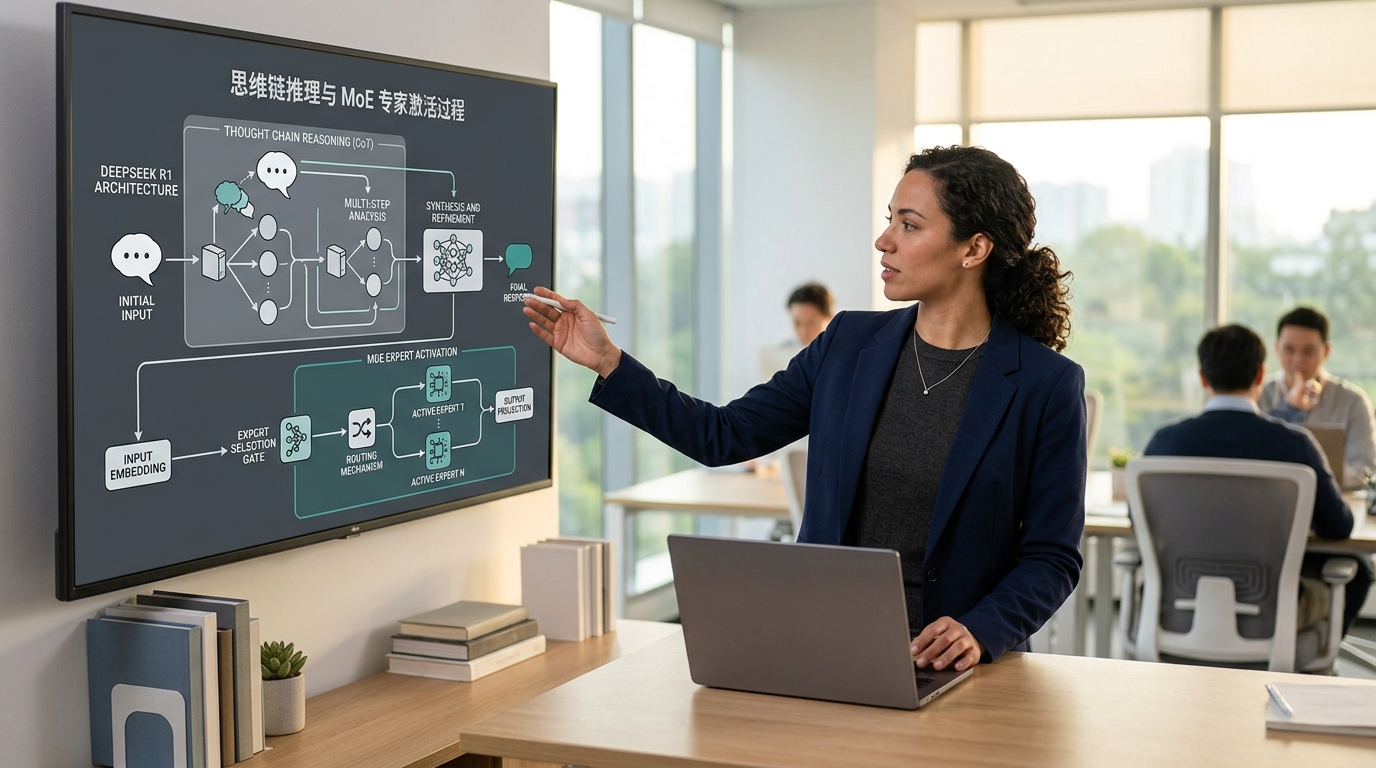
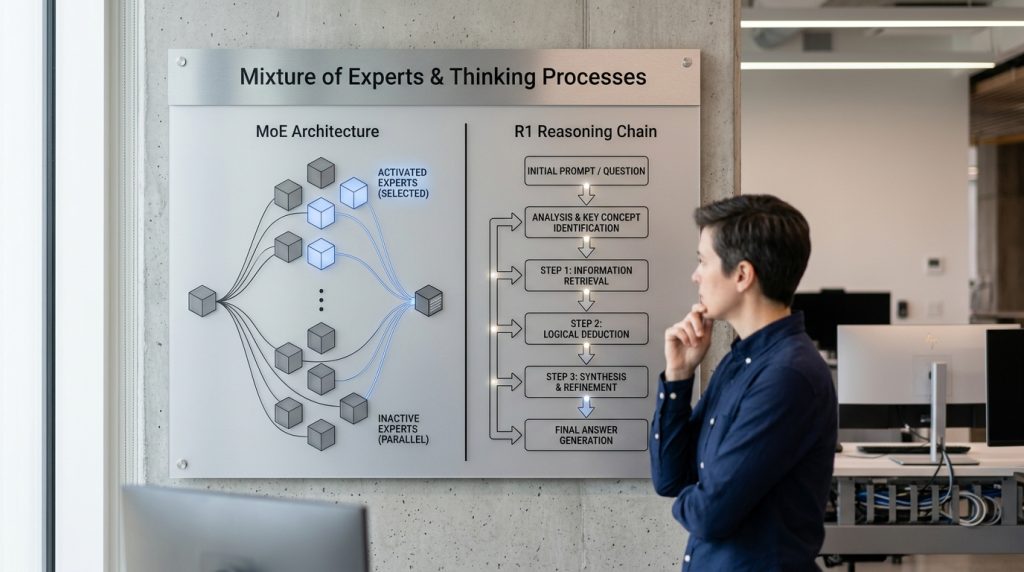
DeepSeek R1 靠「强化学习 + 显式思维链」做推理:它先把题目拆成一步步可见的中间步骤再给答案,而不是直接吐结论。据 MIT CSAIL 2025 年资料,这套方法训练成本约 600 万美元,却在数学与逻辑题上接近 OpenAI 的 o1,用更低成本拿到可对标的强推理,正是它受关注的原因。
为什么激活参数少,性能却不掉?
关键在 MoE(混合专家,模型里有很多小专家网络,每次只唤醒其中几个)。R1 总参数大,但单次推理只激活一小部分,算得快、省显存;而被激活的专家恰好擅长当前任务,所以精度不随激活量下降。这也解释了上一节为何低成本能换来高推理质量:算力花在了刀刃上。
DeepSeek V3、R1、Coder 有什么区别?该怎么选?
三者分工明确:V3 是通用对话主力,R1 专攻复杂推理(2025 年 1 月 20 日发布),Coder 面向编程、支持 80 多种语言的补全与调试。学习或解数学逻辑题选 R1,写代码、建站选 Coder,日常问答选 V3。
| 版本 | 擅长任务 | 特点 |
|---|---|---|
| V3 | 通用对话 | 响应快、覆盖面广 |
| R1 | 复杂推理 | 显式思维链,数学逻辑强 |
| Coder | 编程开发 | 代码补全、调试建站 |
一句话记住选型逻辑:要「想清楚」用 R1,要「写得出」用 Coder,要「聊得快」用 V3。
DeepSeek 实测跑分与 GPT-4o、Claude、Gemini 谁更强?
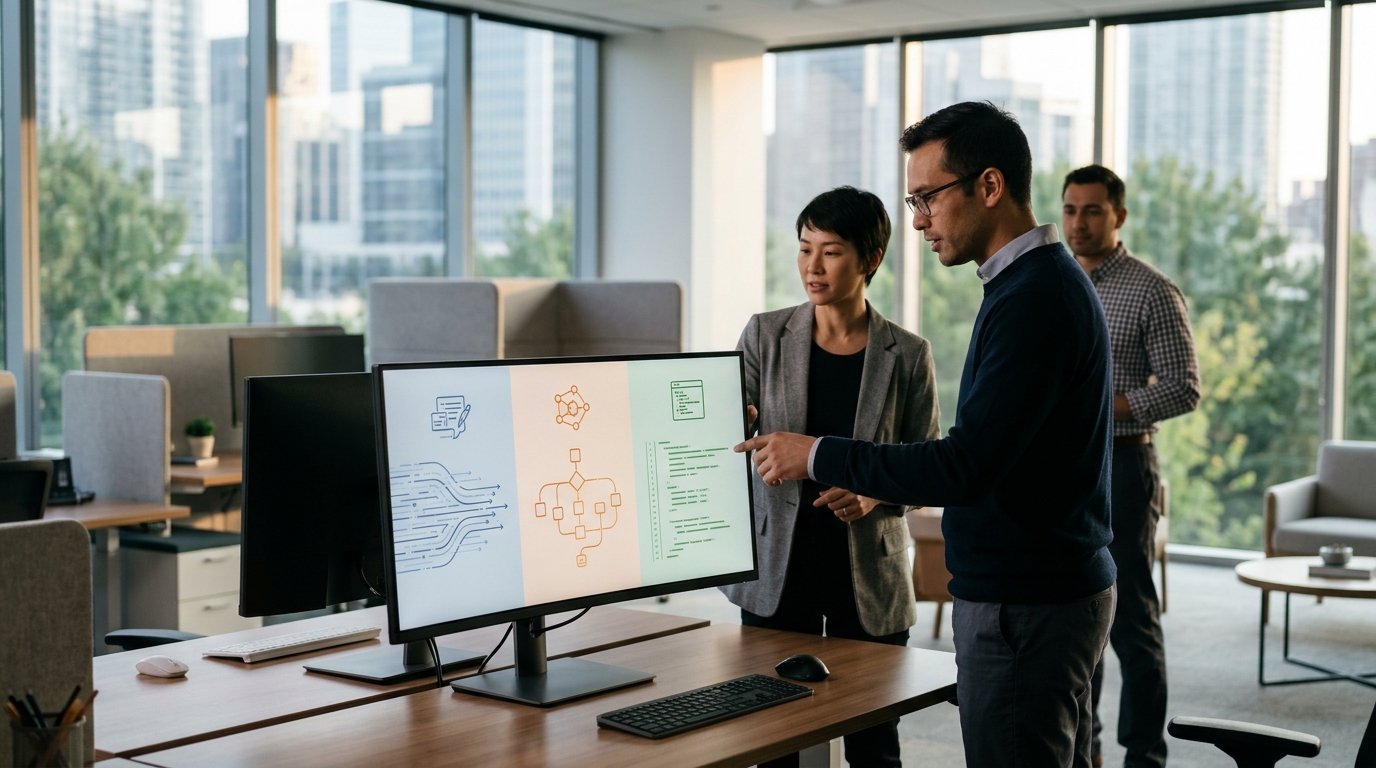
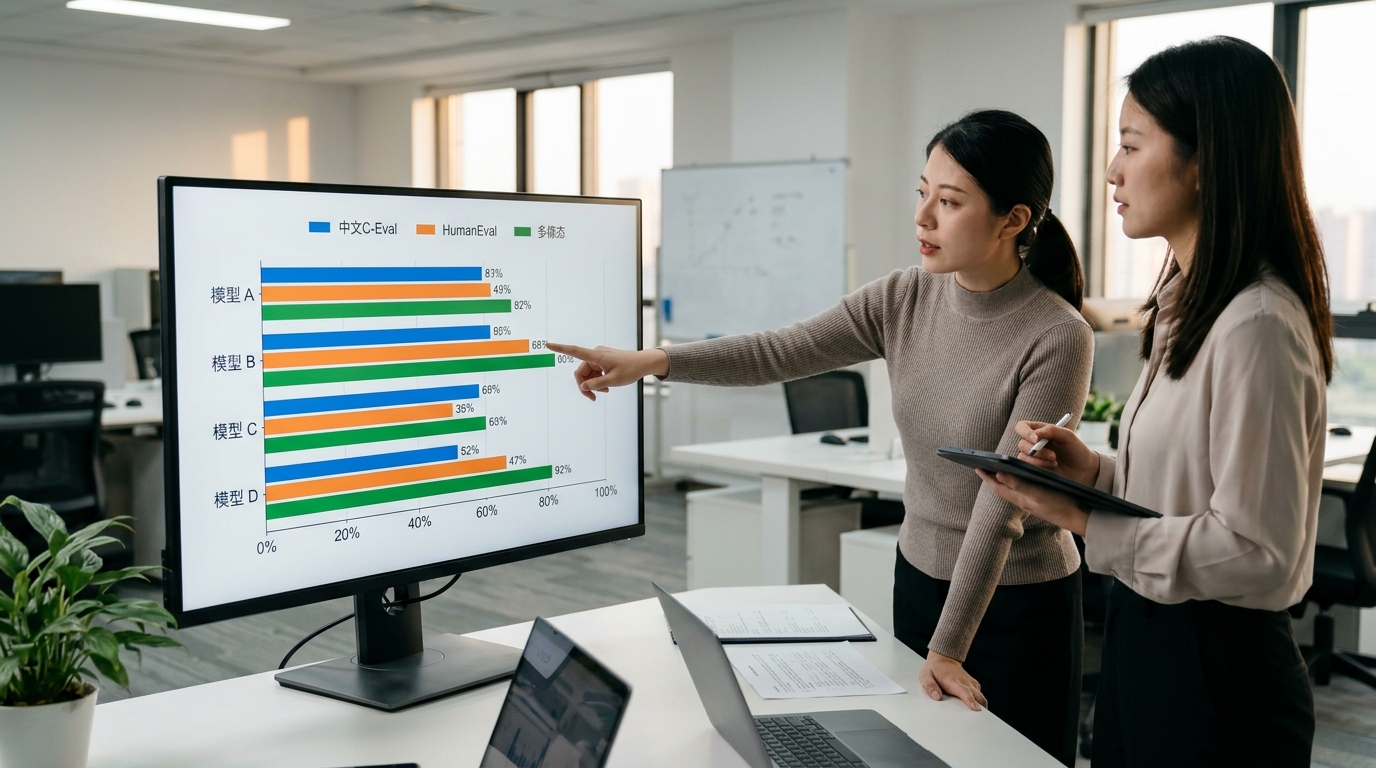
没有谁绝对更强,差异取决于任务:按公开基准看,DeepSeek R1在中文 C-Eval 和HumanEval代码题上领先,但在长上下文和多模态上落后于 GPT-4o、Gemini。R1 于 2025 年 1 月 20 日发布,以约 600 万美元训练成本贴近顶级闭源模型的数学逻辑表现。所以选型要看任务类型,不能只看总分。
⚠️ 常见错误:把「开源权重」理解成可从零复现整个模型。原因:DeepSeek 仅公开参数供下载部署,训练数据并未开放许可,所以你能本地跑却无法重走训练过程。修复:需复现时改用有完整数据许可的模型,部署场景才选 DeepSeek 权重。
| 模型 | 中文 C-Eval | HumanEval 代码 | 多模态 |
|---|---|---|---|
| DeepSeek R1 | 强 | 强 | 不支持 |
| GPT-4o | 中 | 中 | 支持 |
| Gemini | 中 | 中 | 支持 |
需要处理图片、超长文档时,选 GPT-4o 或 Gemini;写中文、做代码,DeepSeek 更划算也更便宜。
DeepSeek 怎么用?API 调用与本地部署的成本对比
调 API 按 token 计费、无硬件投入、上手最快;只有要把数据留在本地机房时才值得自建。DeepSeek 作为 open-weight(参数公开)模型,蒸馏版 1.5B 用 8GB 显存的消费级显卡就能跑,但满血 R1(671B)需要多张 A100/H100,单机硬件门槛轻松破 10 万元。
| 方案 | 硬件/成本 | 适合谁 |
|---|---|---|
| API 调用 | 按 token 计费,无硬件投入 | 中小团队、快速验证 |
| 1.5B 蒸馏本地 | 8GB 显存消费卡 | 离线轻量任务 |
| 70B 蒸馏本地 | 需 2 张以上专业卡 | 数据敏感企业 |
调用量小时先用 API,跑通业务后再按这张表评估是否自建。
企业用 DeepSeek 有哪些数据隐私与合规风险?
企业用官方 API 的最大风险,是数据存储在中国境内的官方云服务器上,受中国数据法管辖。DeepSeek 由杭州公司深度求索于 2023 年 7 月创立。欧美企业若把客户个人信息发进官方 API,可能违反 GDPR 的跨境传输条款。
规避办法接着上一节的自建思路:
拿 open-weight(参数公开)版本本地部署,或用欧美第三方托管商跑同一个模型,数据就不出你的机房,合规压力降到最低。代价是要自备 GPU,满血 R1 需多张 H100。
取舍建议很清楚:涉及敏感数据选本地或第三方托管,只有内部低敏任务才用官方云。
总结:DeepSeek 适合谁用,不适合谁用
deepseek适合三类人:想低成本做 AI 产品的开发者、需要免费中文问答的普通用户、以及愿意本地部署的企业。它是 open-weight 模型(参数公开),蒸馏版 1.5B 用 8GB 显存就能跑。不适合谁?需要强多模态、长上下文,或必须把客户个人数据留在欧美机房的团队。
- 开发者:先调官方 API 跑通,再决定是否自建。入口是 GitHub 开源仓库,R1 于 2025 年 1 月 20 日发布。
- 普通用户:网页版免费,直接用来解数学题和中文写作。
- 企业:有合规要求就本地部署 671B 满血版,绕开境内存储风险。