5分钟读懂DeepSeek的模型、推理与部署方式
deepseek是总部位于中国杭州、由量化对冲基金 High-Flyer 资助的 AI 公司,专注开发开权重大语言模型(模型参数公开、任何人可下载运行)。它与 ChatGPT 的本质区别在于权重开源、采用 MoE 混合专家架构、API 按 token 低价计费。主力模型 DeepSeek-V3 总参数达 6710 亿,每次推理仅激活约 370 亿;据 MIT CSAIL 2025 年 1 月指出,DeepSeek-R1 训练成本仅约 600 万美元,远低于同级闭源模型数亿美元量级。
核心要点
- DeepSeek-V3总参数6710亿,MoE架构每次仅激活约370亿参数
- DeepSeek-R1训练成本约600万美元,远低于闭源模型数亿美元
- R1先分步推理再作答,专攻数学证明与复杂代码调试
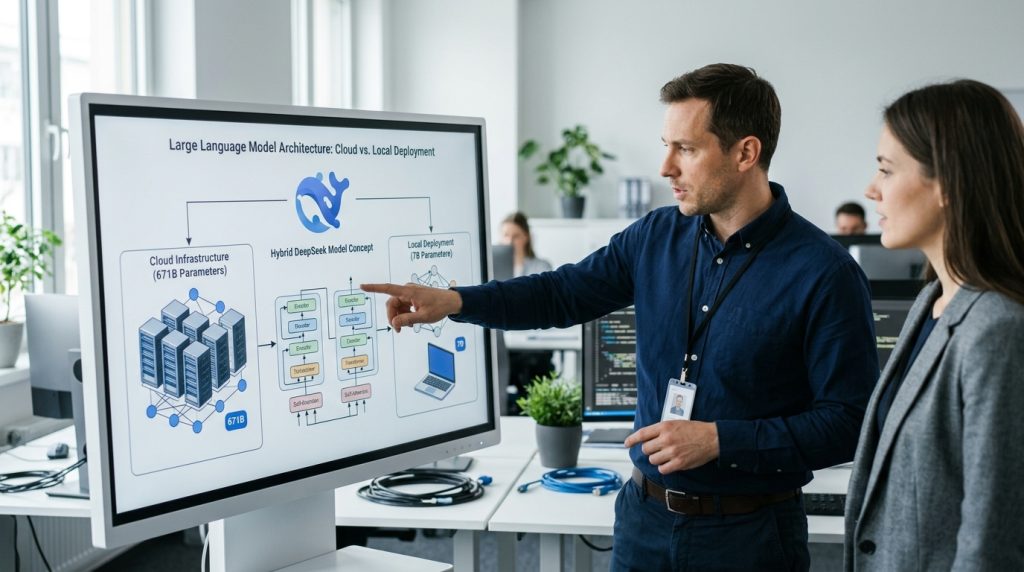
- 满血671B本地部署需8张80GB显卡,起步几十万元
- 蒸馏版最低7B,单张消费级显卡即可运行,权重免费可商用
关键速览
- DeepSeek-V3 主力模型参数达 6710 亿,采用 MoE 架构,每次推理只激活约 370 亿参数。
- 推理模型 DeepSeek-R1 会先分步推理再作答,专攻数学证明、复杂代码调试等多步思考任务。
- 所有模型开权重,可免费下载,多采用 MIT 类宽松协议商用部署。
- 满血 671B 本地部署需约 8 张 80GB 显卡起步,起步成本几十万元。
- 蒸馏小模型最低 7B 版本,单张消费级显卡即可运行。
DeepSeek是什么?它和ChatGPT有什么本质区别?
DeepSeek是总部位于中国杭州的AI公司,由量化对冲基金High-Flyer资助,专注开发开权重大语言模型(权重即模型参数,可公开下载使用)。它和ChatGPT的本质区别在三点:权重开源可下载、采用MoE混合专家架构、API按token低价计费,而OpenAI走的是闭源收费、只能租用API的路线。
最具冲击力的是成本
MIT CSAIL在2025年1月指出,DeepSeek-R1训练成本仅约600万美元,远低于同级闭源模型数亿美元的量级。这意味着开发者可自行下载671B参数的DeepSeek-V3部署到自有服务器,而不是像用ChatGPT那样只能租用云端API。
DeepSeek是怎么用极低成本训练出对标GPT-4的模型的?
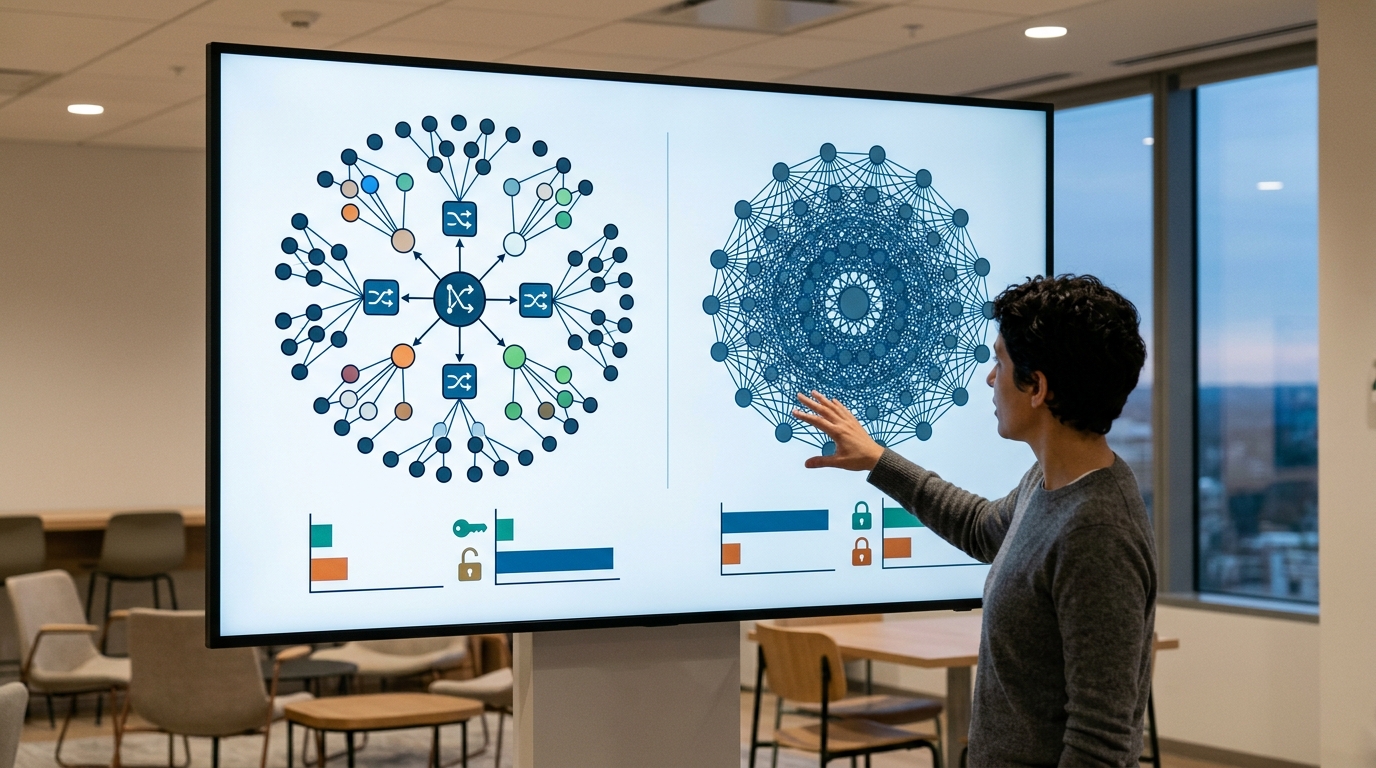
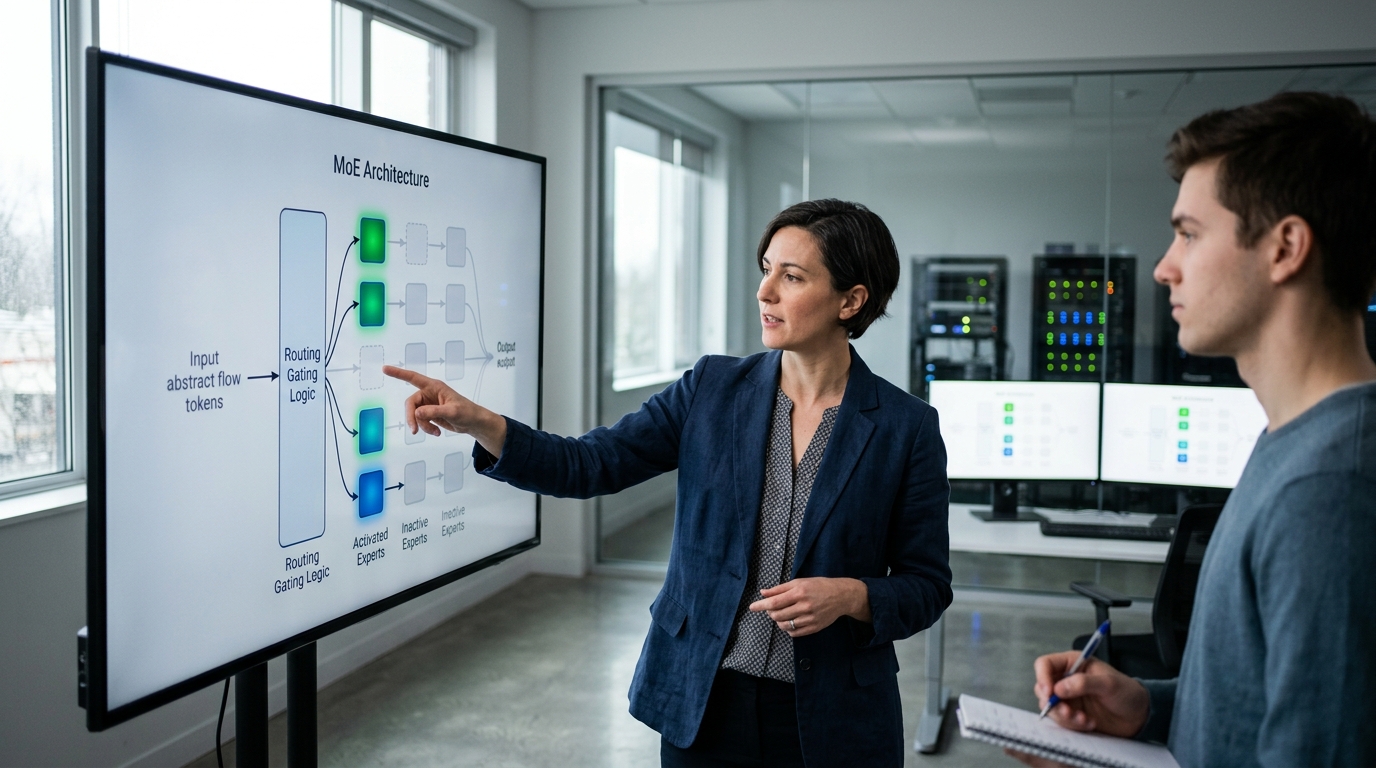
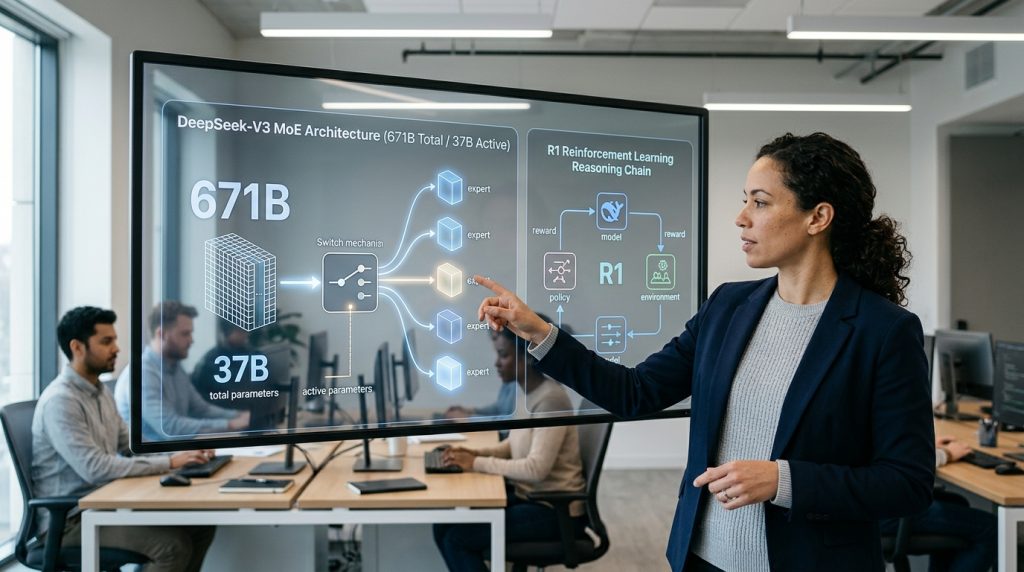
DeepSeek靠工程优化而非堆算力做到这一点。DeepSeek-V3总参数671B,但靠MoE混合专家架构,每次推理只激活约370亿参数而非全部6710亿,从而大幅降低训练与推理的算力消耗。MIT CSAIL在2025年1月指出其训练成本仅约600万美元,远低于GPT-4数亿美元量级。
MoE的原理像一个专家团队:
问题进来,只唤醒最懂这个领域的几位专家,其余休眠。每次只调动不到6%的参数,省下的算力就直接变成省下的电费和GPU租金。
DeepSeek有哪些主要模型?分别适合什么任务?
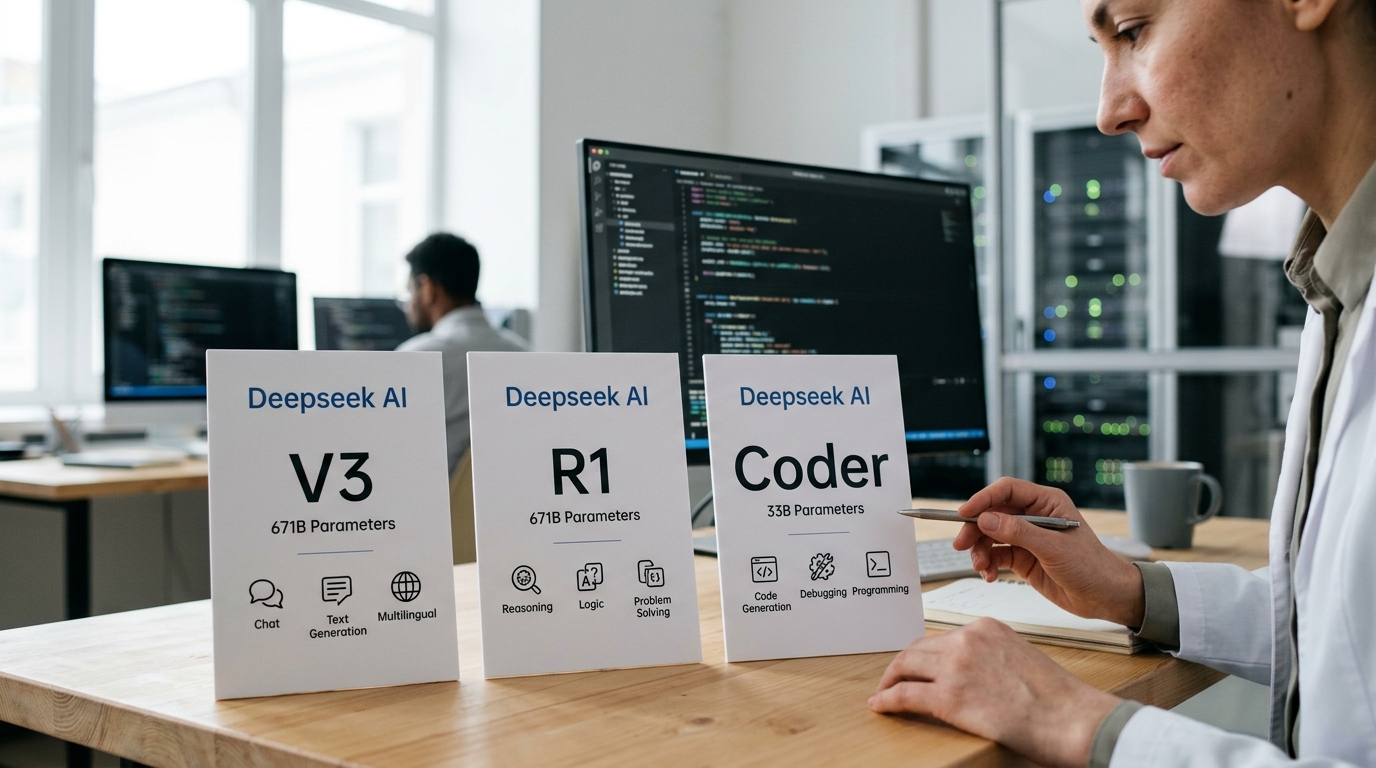
DeepSeek目前有三条主线,各对应不同任务:V3做通用对话、R1做推理、Coder做代码。V3总参数671B(6710亿),适合日常问答与长文处理;2025年1月20日发布的R1擅长数学和逻辑推理;Coder专攻编程。
- DeepSeek-V3:通用对话与长文摘要,671B参数,不适合只需简单翻译的轻量任务(算力浪费)。
- DeepSeek-R1:会”分步思考”(先推理再答),适合数学证明、复杂代码调试;但推理链拉长了响应时间,不适合要秒回的客服场景。
- DeepSeek-Coder:2023年11月发布,专做代码补全与生成。
DeepSeek和ChatGPT、Claude、Gemini相比,谁更强?
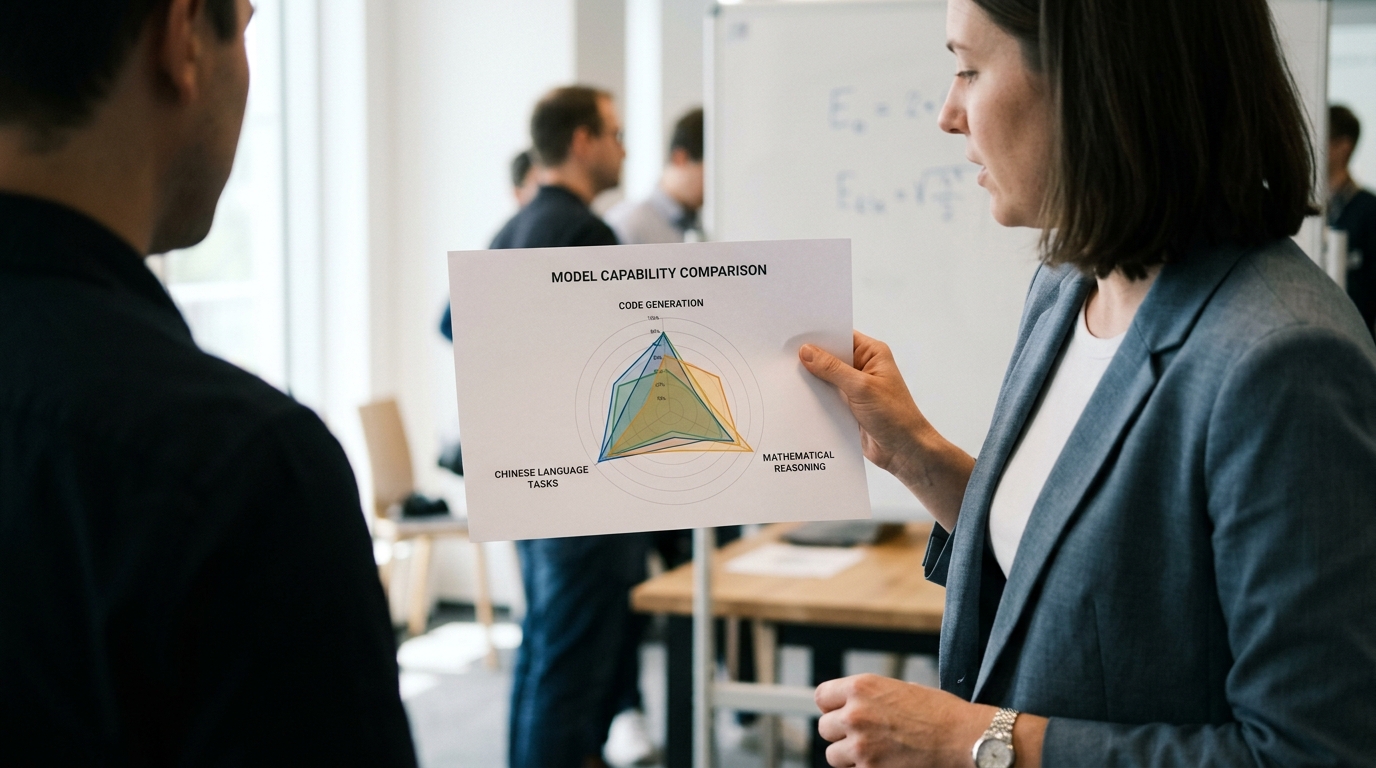
没有谁全面最强,强弱随任务而变,四者各赢在不同场景。数学推理和中文长文上,2025年1月20日发布的deepseek-R1表现突出;代码生成和重构Claude更稳,Gemini则在长上下文处理上更省心。换句话说,DeepSeek赢在推理透明度和中文成本,Claude赢在代码可靠性,这是一道按主力任务来选的题。
⚠️ 常见错误: 简单翻译或需秒回的客服场景却调用 DeepSeek-R1。原因 R1 会先走分步推理链再作答,响应时间明显拉长,且激活算力浪费。修复:轻量任务用 V3 或蒸馏版 7B,仅数学证明、复杂代码调试才用 R1。
| 任务 | 胜出观察 |
|---|---|
| 代码生成 | Claude调试、重构更可靠 |
| 数学推理 | DeepSeek-R1链式思考透明 |
| 中文长文 | DeepSeek语感与成本占优 |
选型建议:按主力任务选模型,别迷信单一排名。
企业用DeepSeek安全吗?数据隐私与合规风险怎么看?
安全与否要分场景判断。DeepSeek是总部位于中国杭州的AI公司,云API数据存储在中国境内,受中国数据法规约束。因此处理非敏感数据可放心用云API;但涉及个人隐私、医疗、金融或受GDPR管辖的数据,应改用本地部署的开权重模型,让数据不出内网。
具体取舍看数据类型:
内部文档摘要、代码补全、营销文案等低敏任务,用云API没问题;但客户身份信息、合同、病历一旦传出境外,可能违反欧盟GDPR或行业合规要求。好在DeepSeek模型权重公开可下载,企业能把R1或V3部署在自有服务器上,彻底避开跨境传输问题,这正是闭源的ChatGPT做不到的。
DeepSeek怎么本地部署或接入API?硬件和成本要多少?
有两条路:接API最省心,本地部署最可控。DeepSeek提供网页、移动应用和API三种访问方式(2025)。小团队直接调云API;只有需要数据不出内网时,才下载开源权重自建。
本地跑671B参数的V3
需约8张80GB高端GPU起步,显存要求数百GB,起步成本几十万元。想省钱可用蒸馏小模型(把大模型知识压进小模型),最低7B版本单张消费级显卡即可跑。
按token(文本最小计费单位)计费的云API
省去了硬件采购与运维。日调用量低于百万token的团队,用API更划算;只有高频、敏感场景才值得承担自建的硬件和维护成本。
总结:什么样的团队该现在用DeepSeek?
预算紧、任务以中文长文或数学推理为主、且数据不敏感的团队,现在就该用deepseek。MIT CSAIL在2025年1月指出其R1训练成本仅约600万美元,低价的按token计费API把试错门槛压到最低。
- 小团队/非敏感数据:直接调云API,最省事。
- 受GDPR管辖或处理金融医疗数据:下载开权重本地部署,数据不出内网。
- 代码调试优先:Claude更稳,可混用。
下一步:先用网页版免费测中文和推理任务,验证效果后再决定接API还是自建。