DeepSeek AI 能做什么?5类场景与使用边界
DeepSeek 是一家位于中国杭州的 AI 研究公司,成立于 2023 年。这家公司开发的 deepseek ai 大模型能写代码、答问题、分析长文档、做数学推理,但它不是万能工具,有些任务它做得好,有些则力不从心。本文回答五个关键问题:它擅长哪 5 类场景?代码和推理哪个更强?免费版和付费版差在哪?哪些任务它做不好?以及在 deepseek 看来,什么时候该换别的工具。
核心要点
- DeepSeek 由杭州 AI 公司于 2023 年创立,主打开源低成本
- 五类场景:写代码、文档分析、数学推理、翻译、内容创作
- 写代码选 V3,数学逻辑推理选 R1,按任务分工选型
- R1 以 MIT 许可开放权重,企业可本地部署并自行微调
- 实时信息、敏感话题、超长上下文需人工复核
关键速览
- DeepSeek 由杭州一家 AI 公司于 2023 年创立
- 5 类核心场景:写代码、文档分析、数学推理、翻译、内容创作
- R1 推理模型在数学与编程基准测试上接近顶级闭源模型
- 模型权重开源,开发者可本地部署、二次开发
- 使用边界:实时信息、敏感话题、超长上下文需人工复核
DeepSeek AI 是什么?它解决了哪些问题?
DeepSeek AI 是中国杭州一家成立于 2023 年的 AI 研究公司推出的开源大模型,它解决的核心问题是闭源模型的两大痛点,训练成本高、内部不透明。它以低成本训练和强推理能力起家:V3 训练成本被 IBM 引述为 550 万美元,远低于主流闭源模型,开发者和企业因此能以更低门槛获得可商用的强模型。
更关键的是,R1 以 MIT 许可证在Hugging Face开放权重,企业可本地部署、自行微调,不必把数据交给 API 黑箱处理。这也是「贵」和「黑箱」之外的第三层价值:可控。2026 年 DeepSeek 官方旗舰已更新为 V4.1-Flash,在原有文本能力上补齐了原生多模态视觉理解。
DeepSeek 的 V2、V3、R1 各版本有什么区别?
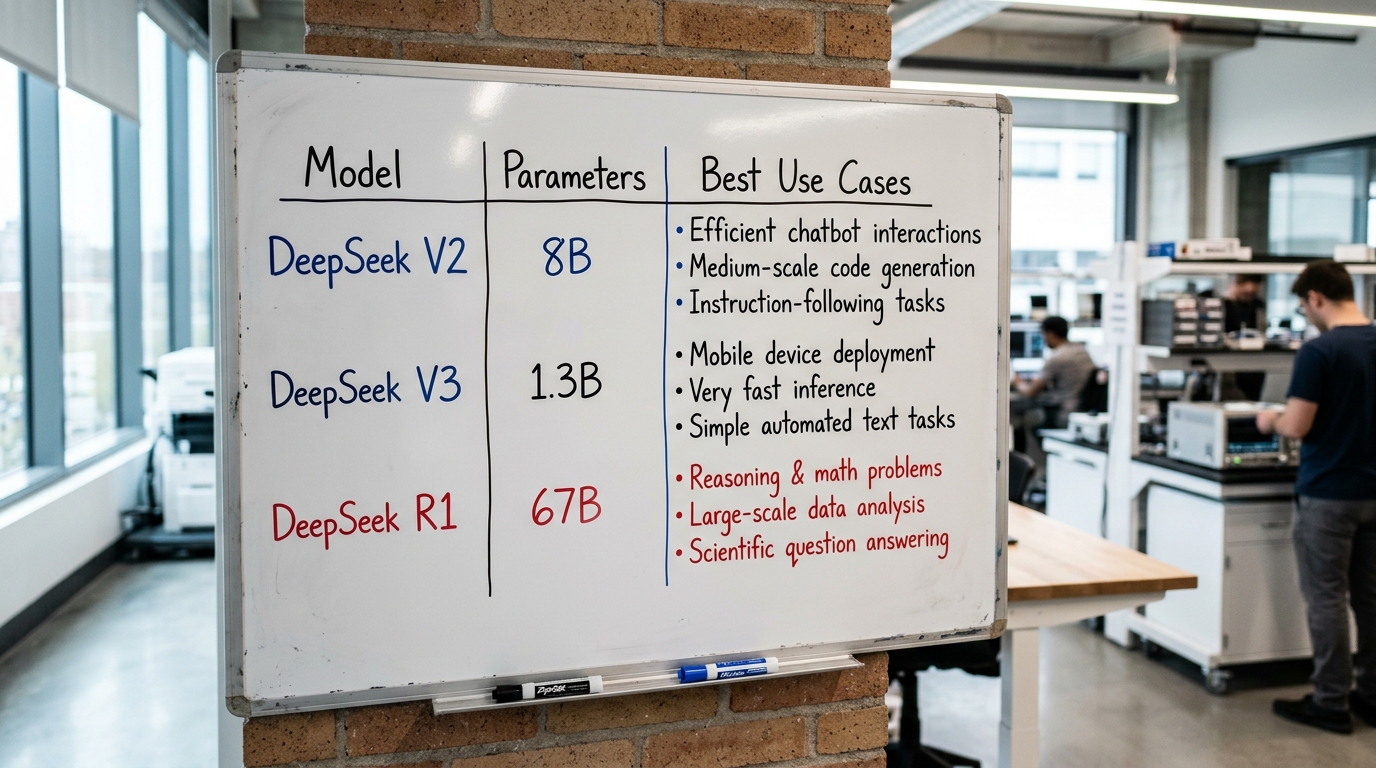
三个版本各有分工:V2 靠 MoE 稀疏激活省算力,V3 用 671B 总参数做通用对话与代码,R1 靠强化学习练出推理链专攻数学逻辑。选型很简单,聊天和写代码找 V3,考研数学、算法证明这类要”想一步说一步”的任务找 R1。
- V2:MoE 架构(混合专家,每次只激活部分参数)首次大规模落地,大幅压低推理成本。
- V3:671B 总参数,适合通用对话、代码生成与长文处理,IBM 记录的训练成本为 550 万美元。
- R1:开源权重、MIT 许可,强化学习训出逐步推理,适合复杂数学与逻辑题。
DeepSeek 的模型原理是怎么工作的?
DeepSeek AI 靠两招压低成本:MoE 稀疏激活和 R1 的强化学习推理。IBM 引述的 V3 训练成本为 550 万美元,关键就在于每次只调用模型的一小部分参数,而不是全部激活。
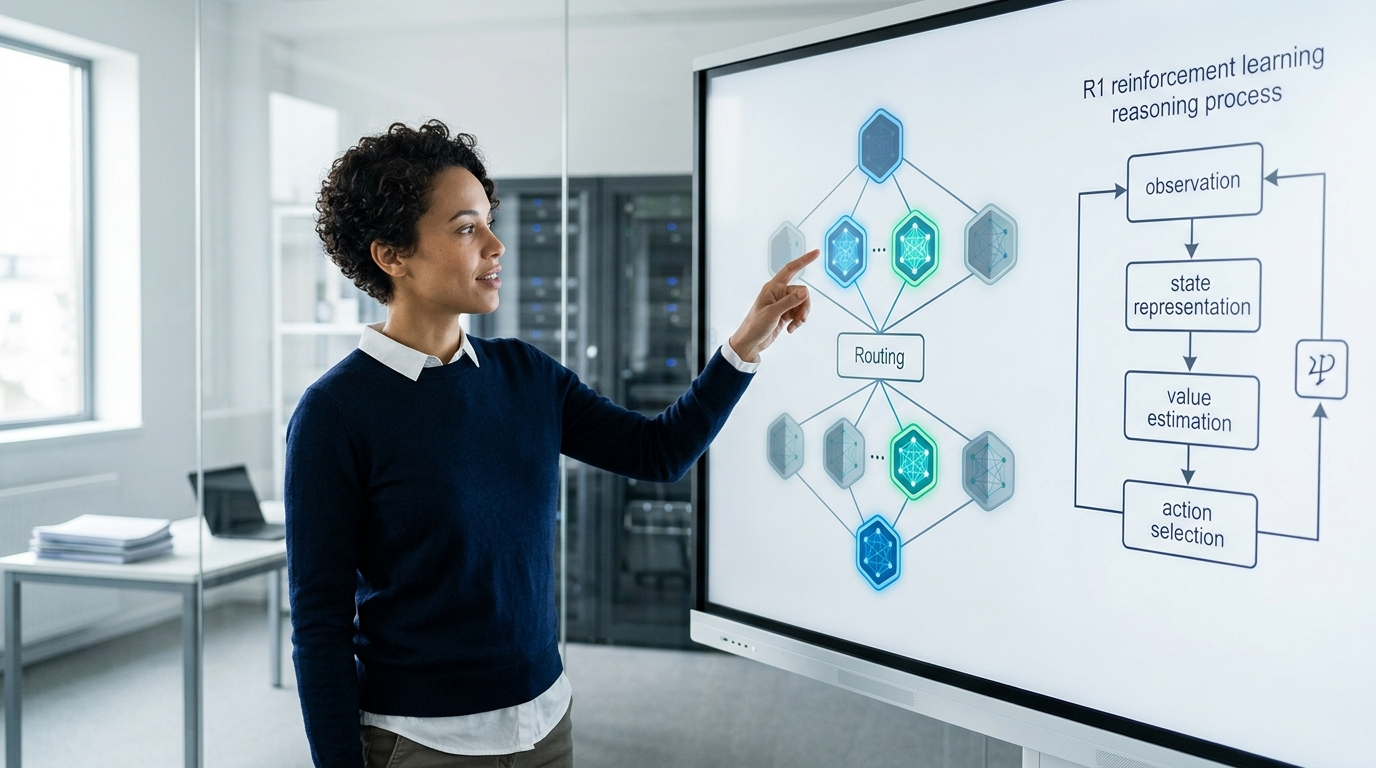
MoE(混合专家,Mixture of Experts)就像一间大办公室里坐着很多专家
V3 总参数虽有 671B,但回答一个问题时只唤醒其中相关的几位专家来干活,算力省了、响应也更快。
R1 则走另一条路:
它用强化学习(RL,模型靠奖惩自己学习)自主生成思维链,把解题步骤一步步写出来,像学生打草稿。没人手把手教它每一步,它靠试错练出推理习惯,所以数学和逻辑题特别强。这也解释了上一节为何把 R1 划给”想一步说一步”的任务。
DeepSeek 和ChatGPT-4、Claude、Llama 哪个更划算?
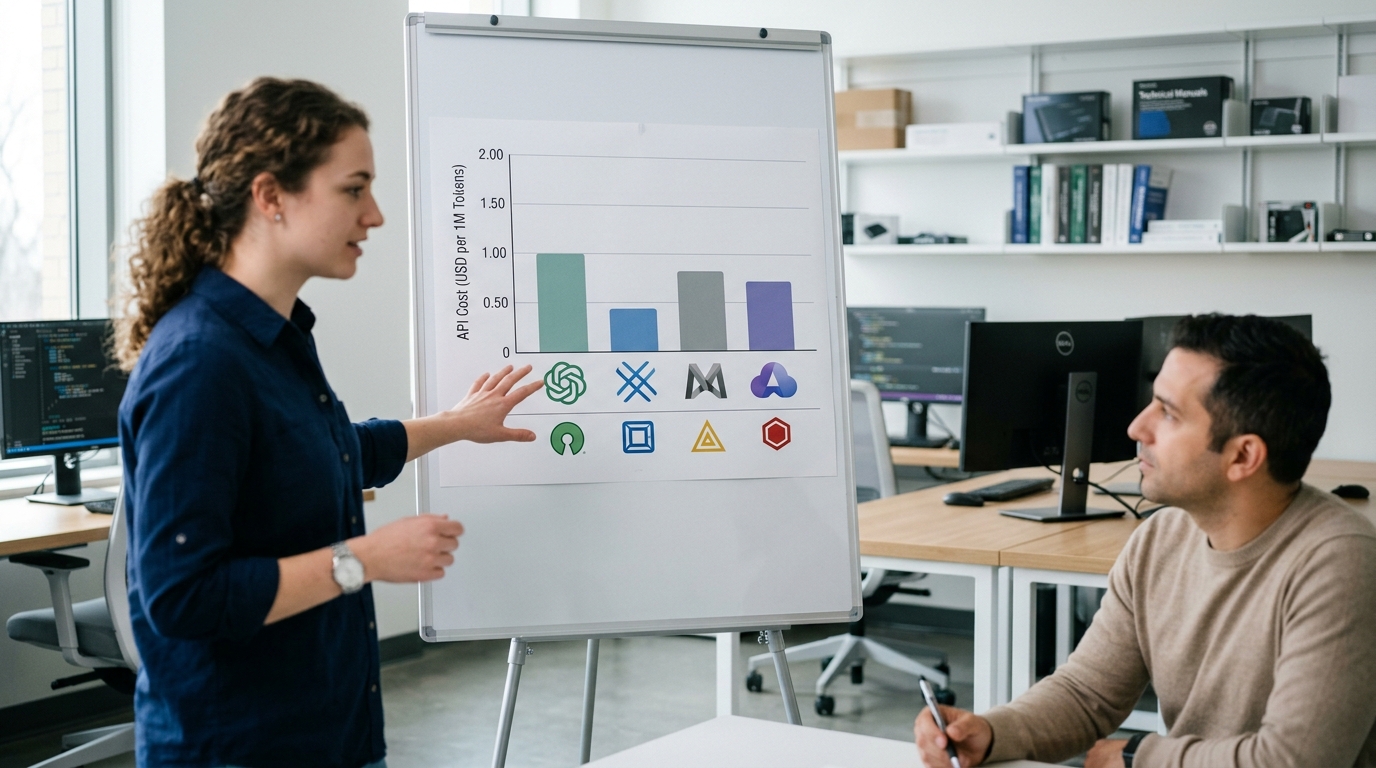
划算与否取决于你怎么用:成本敏感、要搬进自家服务器就选 DeepSeek AI,跨境传输敏感数据、要现成合规审计就选 Claude。DeepSeek-R1 以 MIT 开源许可发布,可自部署、零授权费;而 Claude 虽闭源、按量计费,但在数据留存和合规审计上更成熟,适合金融、医疗等受监管行业。开源协议(允许商用改动的授权条款)是两者的分水岭,它直接决定你能否把模型搬进自家机房。
⚠️ 常见错误: 写代码或聊天任务用 R1,数学逻辑题却用 V3。原因:R1 靠强化学习练出逐步推理链,专攻数学与算法证明;V3 是 671B 通用模型,擅长对话与代码生成。修复:按任务分工,写代码选 V3,要”想一步说一步”的推理选 R1。
| 模型 | 开源协议 | 可自部署 | 合规审计 |
|---|---|---|---|
| DeepSeek-R1 | MIT(开源) | 可 | 需自建 |
| ChatGPT-4 | 闭源 | 否 | 中 |
| Claude | 闭源 | 否 | 强 |
| Llama | 社区许可 | 可 | 需自建 |
实操建议:预算有限且要私有化,走 MIT 协议的 DeepSeek;跨境传输敏感数据,优先 Claude。
哪些工作场景该选 DeepSeek AI?
成本敏感、需要私有化部署、或跑数学推理,就选 DeepSeek AI。R1 以 MIT 许可开源,可自部署、零授权费,V3 训练成本仅 550 万美元。换句话说:高频调用量越大,自部署省的钱越多。
- 代码补全:团队日调用超 10 万次,用 V3 自部署摊薄单次成本——这是闭源 API 按量计费的性价比临界点。
- 中文长文档处理:合同、财报解析,中文语料优势明显。
- 私有化部署:数据不出内网时,开源权重是硬需求。
- 数学推理:R1 的强化学习推理链专攻逻辑解题。
反过来,若只是偶尔少量调用、又要现成合规审计,闭源 API 省去自建运维反而更省心。
DeepSeek 的数据隐私、合规与境外使用有哪些风险?
主要风险在数据驻留:用 DeepSeek 云端 API,数据默认发往中国境内服务器处理,这触发了多国的合规限制。美国国会研究报告(2025)指出 DeepSeek 是一家位于中国杭州、2023 年成立的公司,这意味着处理欧盟客户或医疗数据时,云端调用可能违反 GDPR 的数据驻留(data residency,即数据必须存在指定国家)要求。
规避办法很直接:
R1 以 MIT 许可开源,可本地部署,让数据不出自己机房;代价是你得自备 GPU 和运维团队。按这条分界线,受监管行业走私有化,纯内部工具才用云端 API。
总结与选型建议
预算紧、要自部署、跑数学推理,选deepseek ai ;强合规、受监管行业,选 Claude 这类闭源方案。R1 以 MIT 许可开源、零授权费,IBM 引述的 V3 训练成本为 550 万美元,这让高频调用场景的自部署特别划算。
三步选清单,照着走:
- 看预算:日调用量大、想省授权费,用 R1/V3 自部署;低频试水,先用官方 V4.1-Flash 云端 API。
- 看合规:处理欧盟或医疗数据,避开云端 API(数据默认发往中国境内),改走本地部署或闭源合规方案。
- 看任务:聊天写代码用 V3,数学逻辑解题用 R1。
下一步:先用免费聊天 App 试模型质量,再决定是否接 API 或拉开源权重自建。