5个关键问题看懂 DeepSeek 的模型与应用
DeepSeek是中国杭州一家 AI 实验室开发的开源大语言模型系列,由梁文锋于 2023 年创立,首个模型在同年 11 月发布。旗舰模型 DeepSeek-V3 参数达 6710 亿,采用混合专家(MoE)架构,官方公布训练成本仅约 557.6 万美元,远低于同级模型。2025 年 1 月发布的 R1 推理模型对标 OpenAI o1,且以 MIT 许可开放权重,可免费商用与本地部署。
核心要点
- DeepSeek-R1 采用 MIT 许可开源,可免费商用与本地部署
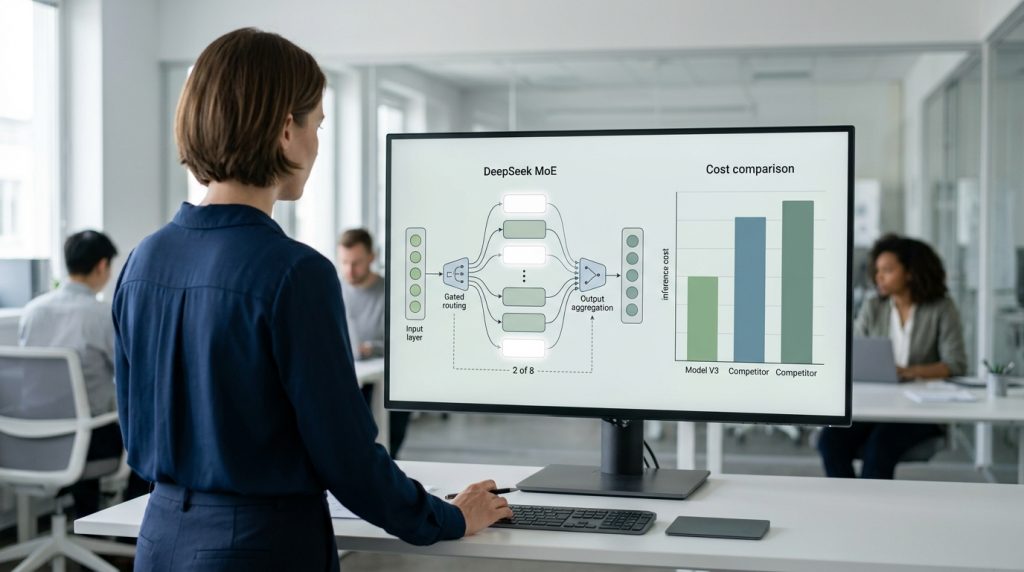
- V3 用 MoE 架构,6710 亿参数,训练成本仅约 557.6 万美元
- 数据不出内网,适合金融、医疗等高合规行业自托管
- R1 靠 GRPO 强化学习生成思维链,数学与代码任务更强
- NIST 评估指出,最强美国模型仍优于最强 DeepSeek 模型
关键速览
- DeepSeek 由量化基金幻方(High-Flyer)背景团队于 2023 年创立
- DeepSeek-V3 参数达 6710 亿,采用混合专家(MoE)架构
- V3 官方公布训练成本约 557.6 万美元,远低于同级模型
- DeepSeek-R1 主打推理,性能对标 OpenAI o1
- 模型权重开源,采用 MIT 许可,可免费商用
DeepSeek是什么?和ChatGPT这类聊天工具有何不同?
DeepSeek 是中国杭州一家 AI 研究实验室开发的开源大语言模型系列。这家公司成立于 2023 年,创始人是梁文锋,首个模型在 2023 年 11 月发布。它和ChatGPT最大的区别在于:R1 模型以开源许可证免费开放权重,任何人都能下载、部署、二次开发。
ChatGPT 是闭源产品
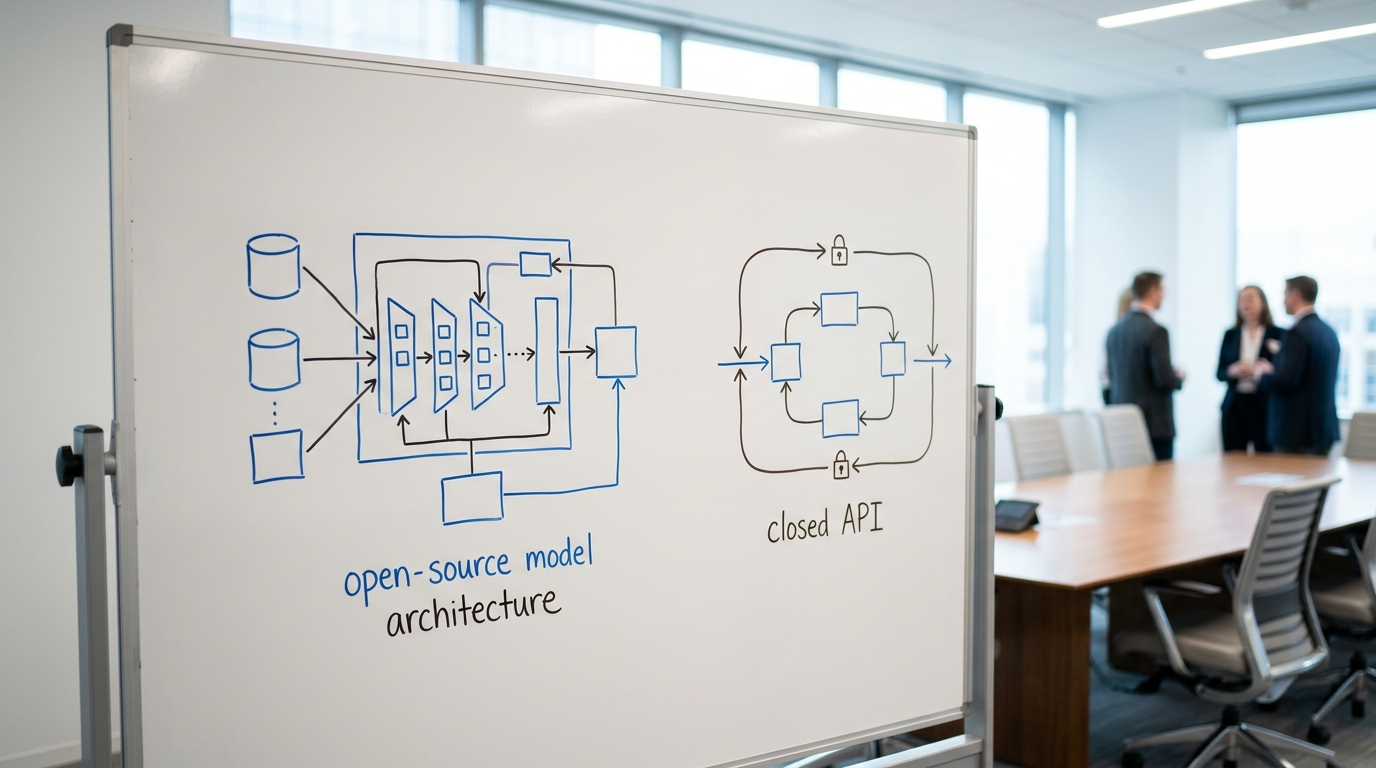
你只能通过 OpenAI 的接口调用,看不到模型内部,也无法自己部署。DeepSeek 把权重公开,意味着企业可以把模型跑在自己的服务器上,数据不出内网。这一点对金融、医疗这类合规要求高的行业价值很大。
三个核心差异一目了然:
| 维度 | DeepSeek | ChatGPT |
|---|---|---|
| 开源程度 | R1 开放权重,可本地部署 | 闭源,仅 API 访问 |
| 使用成本 | 开源版可免费自托管 | 按 token 付费,无免费权重 |
| 专精方向 | 推理模型(R1)为主打 | 通用对话 + 多模态 |
DeepSeek-R1 在 2025 年 1 月 20 日发布,随后冲上美国 iOS App Store 免费应用下载榜前列,还引发了美股科技板块波动。不过要客观看待:美国国家标准与技术研究院(NIST)在 2025 年的 CAISI 评估中指出,最强的美国模型在几乎所有基准上仍优于最强的 DeepSeek 模型。开源不等于性能第一,选型要看具体任务。
DeepSeek的工作原理是什么?R1模型如何通过推理生成回答?
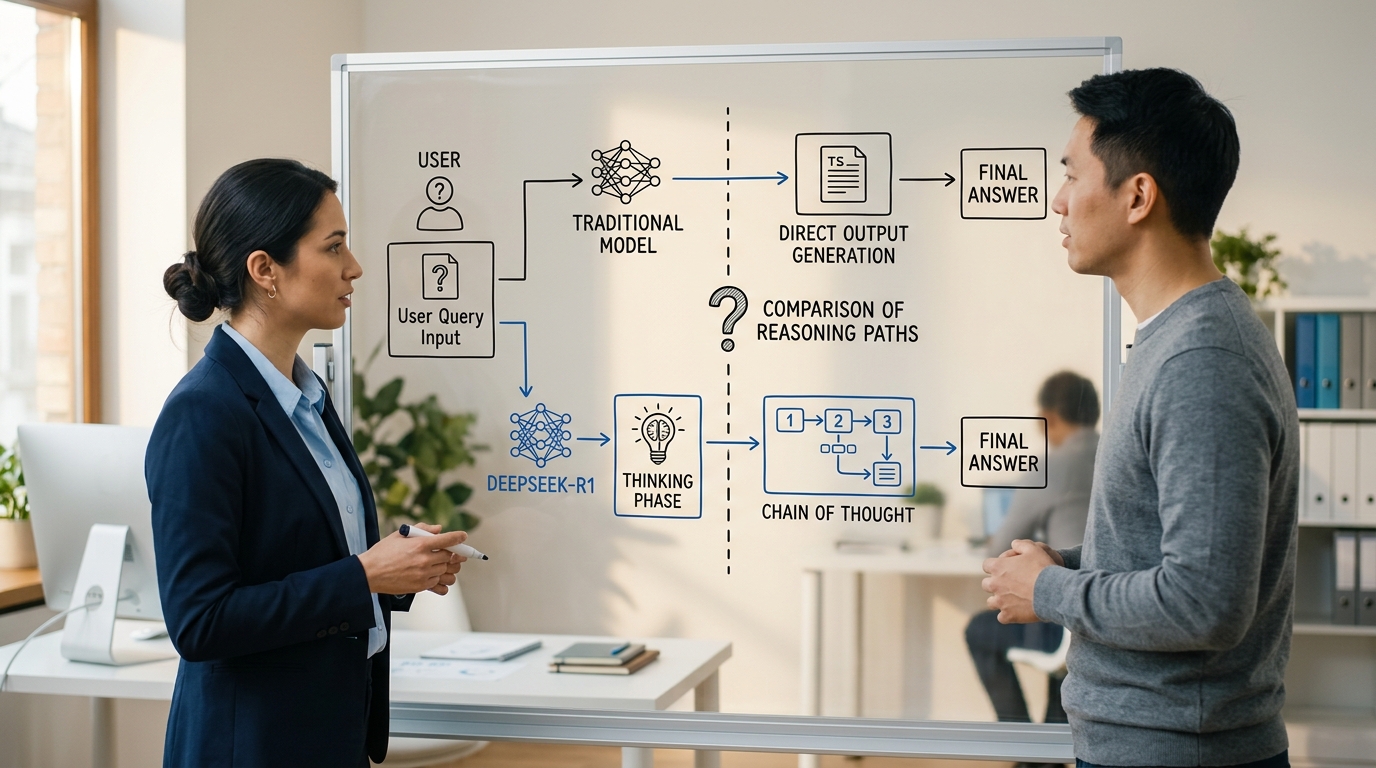
DeepSeek-R1 靠强化学习训练出”先思考再回答”的能力。它在给出最终答案前,会先输出一段可见的推理过程,术语叫”思维链”(chain-of-thought,即把解题步骤一步步写出来)。R1 于 2025 年 1 月 20 日发布,几天内就冲上美国 iOS 应用商店免费榜前列。
为什么 R1 会先写思考过程,而不是直接给答案?
因为它的训练方式不同。传统大模型靠预测下一个词直接生成答案,遇到多步数学题容易中途出错。R1 用一种叫 GRPO 的强化学习方法,让模型自己尝试多条解题路径,答对的路径被奖励,答错的被惩罚。久而久之,它学会用更长的推理链换取更高的正确率。
这种机制为什么让它数学和逻辑更强?
把复杂问题拆成小步骤,每一步的出错概率就更低。这和人做应用题打草稿是一个道理,写出中间步骤,比心算更不容易翻车。R1 在数学、代码这类有明确对错的任务上因此表现突出。不过 NIST 在 2025 年的 CAISI 评估指出,最强的美国模型在几乎所有基准上仍优于最强的 DeepSeek 模型,说明它并非全面领先。
DeepSeek有哪些模型版本?V3、R1、Coder分别适合什么场景?
DeepSeek 主要有三条产品线:V3 做通用对话,R1 做复杂推理,Coder 专攻编程。选型逻辑很简单,问题需要”边想边算”就选 R1,只要快速答话或润色文案就用 V3,写代码、改 bug 则用 Coder。R1 于 2025 年 1 月 20 日发布,很快登上美国 iOS App Store 免费榜。
三者的核心差别在”思维链”(把解题步骤写出来再答)
V3 直接给答案,速度快、每次调用消耗的 token 少,成本低。R1 会先输出推理过程,token 用量往往是 V3 的数倍,费用也更高,但数学题、逻辑题的正确率明显占优。Coder 在代码补全和调试上训练更专,处理长文件时上下文窗口更能派上用场。
| 版本 | 擅长任务 | 推理链 | 调用成本(相对) |
|---|---|---|---|
| V3 | 日常对话、翻译、文案 | 无 | 低 |
| R1 | 数学、逻辑、多步推理 | 有 | 高 |
| Coder | 代码生成、调试、补全 | 轻量 | 中 |
实操建议:别用 R1 做简单翻译,那等于花贵价买慢速。反过来,让 V3 解奥数题容易出错。DeepSeek 的选型思路是”任务复杂度匹配模型档位”。下一节会把 DeepSeek 与 ChatGPT、Claude、Gemini 放在一起横向对比。
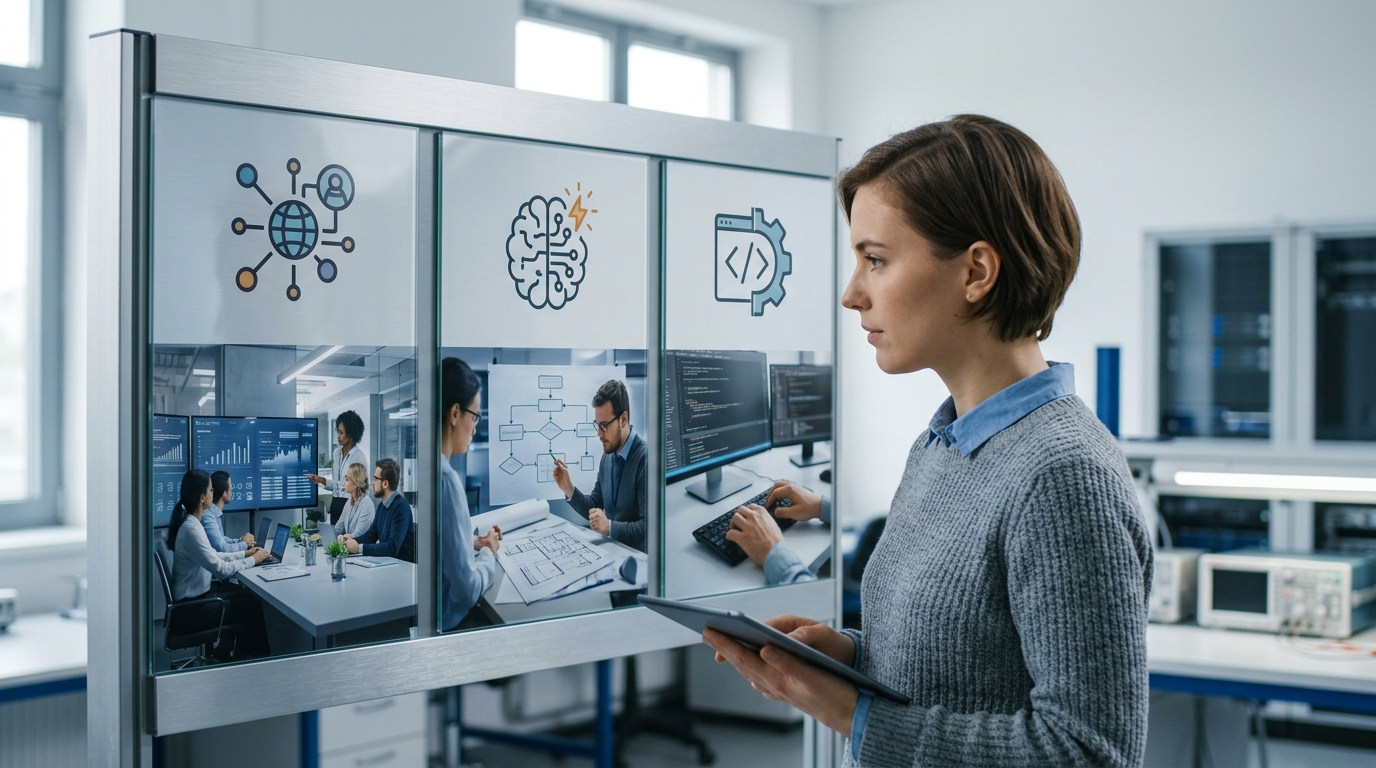
DeepSeek和ChatGPT、Claude、Gemini横向对比谁更强?
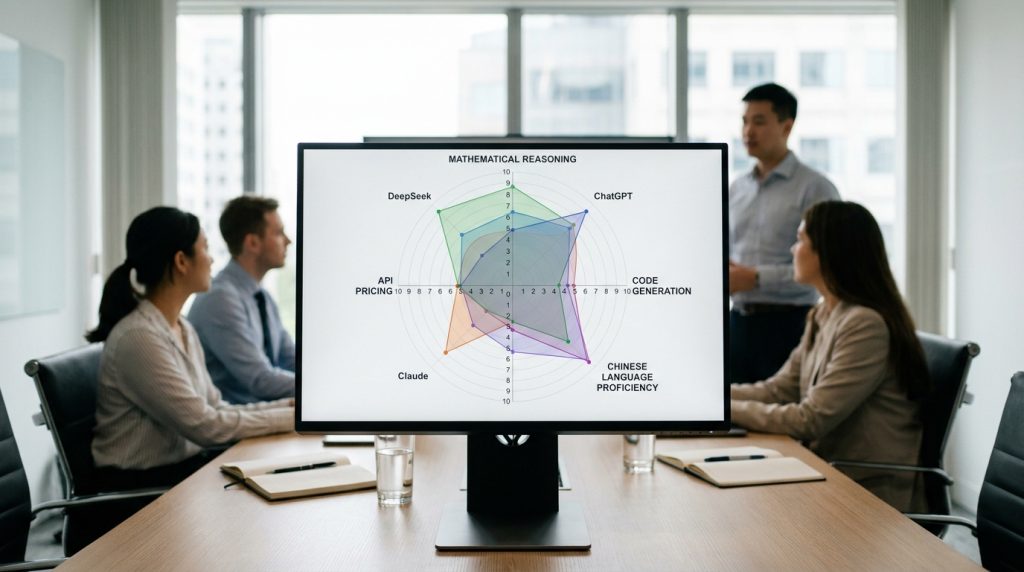
没有绝对的赢家,按维度看:DeepSeek 在中文理解和 API 成本上领先,ChatGPT 生态最全,Claude 长文本处理最稳,Gemini 上下文窗口最大。但要注意,美国国家标准与技术研究院(NIST)下属 CAISI 在 2025 年的评估中指出,最佳美国模型在几乎所有基准上优于最佳 DeepSeek 模型。所以选型要看具体任务,别只看单一榜单。
⚠️ 常见错误:所有任务都默认用 R1 推理模型,导致成本和延迟飙升。原因 R1 会先输出思维链,token 用量往往是 V3 的数倍,费用同步上涨。修复:润色、快速问答用 V3,只在数学、逻辑、代码等需”边想边算”的任务上启用 R1。
| 维度 | DeepSeek | ChatGPT | Claude | Gemini |
|---|---|---|---|---|
| 复杂推理 | R1 强 | o 系列领先 | 次之 | 中等 |
| 代码生成 | Coder 专精 | 综合最强 | 重构最稳 | 中等 |
| 中文理解 | 领先 | 次之 | 中等 | 中等 |
| API 定价 | 最低 | 较高 | 较高 | 中等 |
| 长上下文 | 短板 | 较强 | 很强 | 最大窗口 |
DeepSeek 的核心优势是”性价比”。R1 以开源许可证免费开放,API 每百万 token 价格远低于闭源竞品,做大批量中文任务时成本差距明显。
短板也真实存在。长上下文(一次能读的文字量)和插件、企业连接器等生态工具,DeepSeek 落后于 Gemini 和 ChatGPT。要处理超长文档或需要现成第三方集成,先选后两者。
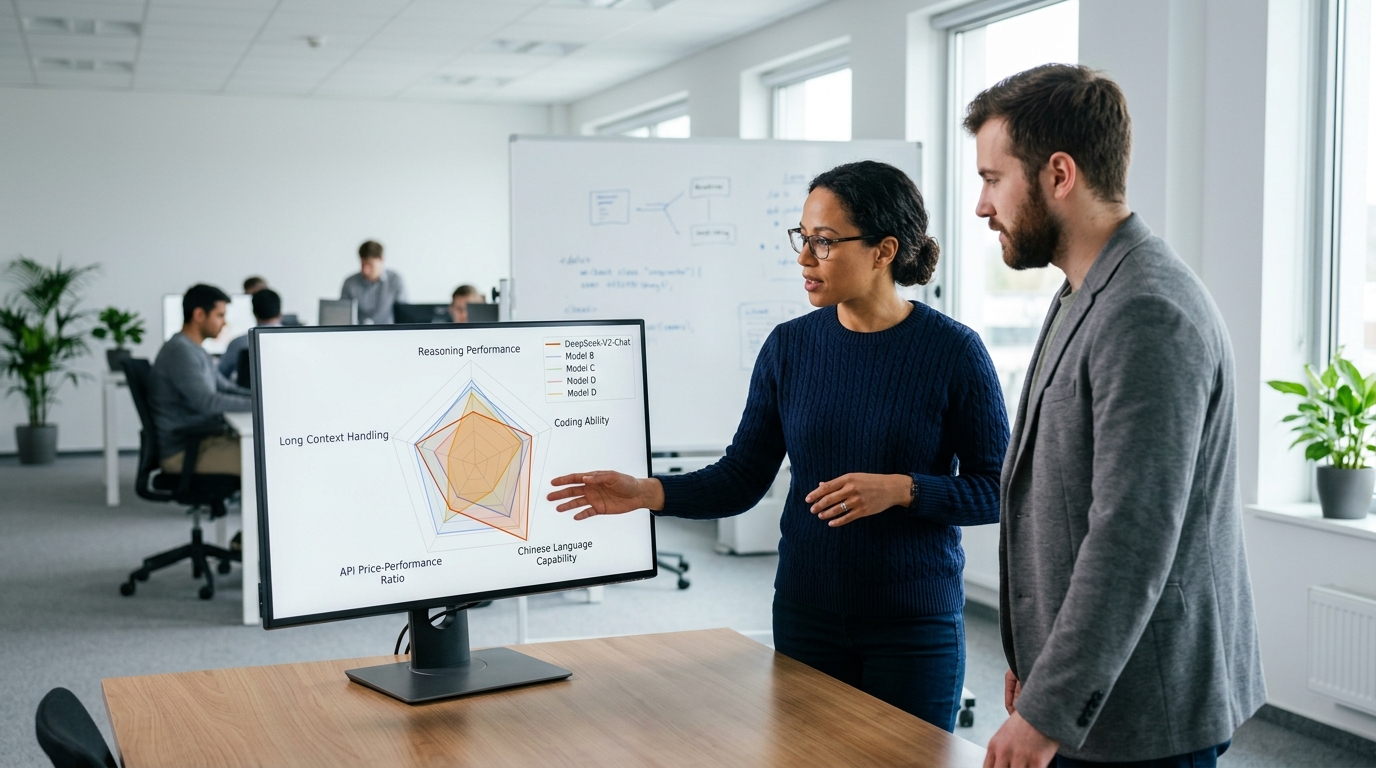
DeepSeek适合哪些应用场景?文本、代码与复杂推理的实测表现如何?
DeepSeek 最擅长三类任务:中文文案、代码生成和数学逻辑推理。中文场景选 V3,写代码用 Coder,做证明题或多步推理选 R1。但它在英文创意写作和实时信息上表现较弱,这两点要靠别的工具补。
中文文案与翻译好在哪,翻车边界在哪?
中文是 DeepSeek 的主场。输入”把这段产品说明改写成小红书风格,带 emoji”,V3 能给出符合平台语气的文案,成语和网络用语用得自然。翻车边界在专业术语翻译,比如把英文法律合同译成中文时,它偶尔会漏掉”甲方义务”这类固定表达的准确对应,需要人工核对。
代码生成与调试实测表现如何?
Coder 处理常见框架很稳。输入”用 Python 写一个爬取表格并存 Excel 的脚本”,它能一次给出可运行代码,还会加注释。但让它调试一段涉及多线程锁竞争的复杂 bug 时,它有时会给出看似合理却治标不治本的方案。经验做法是:把完整报错日志贴进去,而不是只描述现象。
数学证明与逻辑推理靠谱吗?
R1 的思维链在这里价值最大。它能一步步展开几何证明或概率计算。但要注意,NIST 下属 CAISI 在 2025 年的评估指出,最佳美国模型在几乎所有基准上优于最佳 DeepSeek 模型。所以高风险场景,答案务必二次验证。
用DeepSeek要注意哪些数据隐私与合规风险?
用 DeepSeek 官方在线服务,你的对话数据会存储在中国境内的服务器上。这意味着受欧盟 GDPR(通用数据保护条例,即欧盟对个人数据的严格法律)或医疗、金融行业合规要求约束的企业,直接调用官方 App 或网页版存在跨境数据传输风险。敏感数据场景,别用在线版。
官方服务和本地部署的隐私差异在哪?
差异是数据”出不出门”。调用官方 API 时,你的提示词(prompt)和返回结果都会经过 DeepSeek 的云端处理;而本地部署把开源权重下载到自己的服务器,数据全程不离开企业内网。由于 R1 模型以开源许可证免费开放权重,企业可以完全离线运行,这是它相比闭源模型的一大合规优势。
企业敏感数据该怎么取舍?
按数据敏感度分三档处理:
- 公开或低敏数据:直接用官方 API,成本最低。
- 中敏数据(客户信息):走海外云厂商托管的 DeepSeek 权重,数据留在你选定的合规区域。
- 高敏数据(病历、交易记录):本地私有化部署,配合内网隔离。
值得警惕的是,2025 年美国国家标准与技术研究院(NIST)的 CAISI 评估还指出,最佳美国模型在几乎所有基准上优于最佳 DeepSeek 模型,性能和合规都要一起权衡,不能只看免费。
DeepSeek怎么用?API调用与本地部署的真实成本核算
用 DeepSeek 有两条路:调官方 API 或本地部署开源权重。日调用量低于 100 万 token 且不涉及敏感数据,直接调 API 最省钱;数据要留在内网、或月调用量超过 5000 万 token,自建才划算。R1 模型以开源许可证免费开放权重(2025),这是自建成为选项的前提。
API怎么接?成本怎么算?
接入只需三步:官网注册拿 API Key、按 OpenAI 兼容格式发请求、指定模型名(如 deepseek-chat 或 deepseek-reasoner)。计费按 token 分输入和输出两档。假设一个客服机器人每天处理 1 万次对话,每次约 800 token,月消耗约 2.4 亿 token,按主流 API 定价通常落在几百到一千多元人民币区间,比养一台服务器便宜。
本地部署要什么显卡?
门槛在显存。R1 满血版(671B 参数)需要多张 80GB 显存的专业卡(如 H100),整机成本轻松超过 60 万元。多数团队跑不起满血版,改用蒸馏版:32B 参数模型一张 24GB 显存的消费级卡(如 RTX 4090)就能推理。所以选型前先算清月调用量,量小选 API,量大且要数据自主选蒸馏版本地跑。
总结:该不该用DeepSeek,什么情况下值得换?
该不该换看三点:语言、成本、合规。中文用户和成本敏感团队值得优先试 DeepSeek,因为 R1 模型以开源许可证免费开放,API 单价远低于同级闭源模型。但受 GDPR 或行业合规约束的场景,别急着切官方在线服务。
中文用户和成本敏感团队该不该换?
值得换。中文文案、翻译、多步数学推理这三类任务,DeepSeek 的性价比明显占优。日调用量低于 100 万 token 且数据不敏感,直接调 API 是最省钱的路径。创业团队和个人开发者尤其受益,网页版对个人免费,试错成本几乎为零。
开发者和合规敏感企业要注意什么?
开发者写代码可以用 Coder 线,但英文创意写作和实时信息仍要靠别的工具补。合规敏感企业要留意:官方服务数据存在中国境内服务器。美国 NIST 下属 CAISI 在 2025 年的评估报告指出,最佳美国模型在几乎所有基准上优于最佳 DeepSeek 模型,选型时要把这点纳入权衡。
下一步很简单:先用免费网页版跑 20 个你真实工作里的问题,对比现有工具的回答质量,再决定是否付费调 API 或本地部署。别只看榜单,实测你自己的用例最准。