DeepSeek不只是聊天工具:从模型机制看真实应用边界
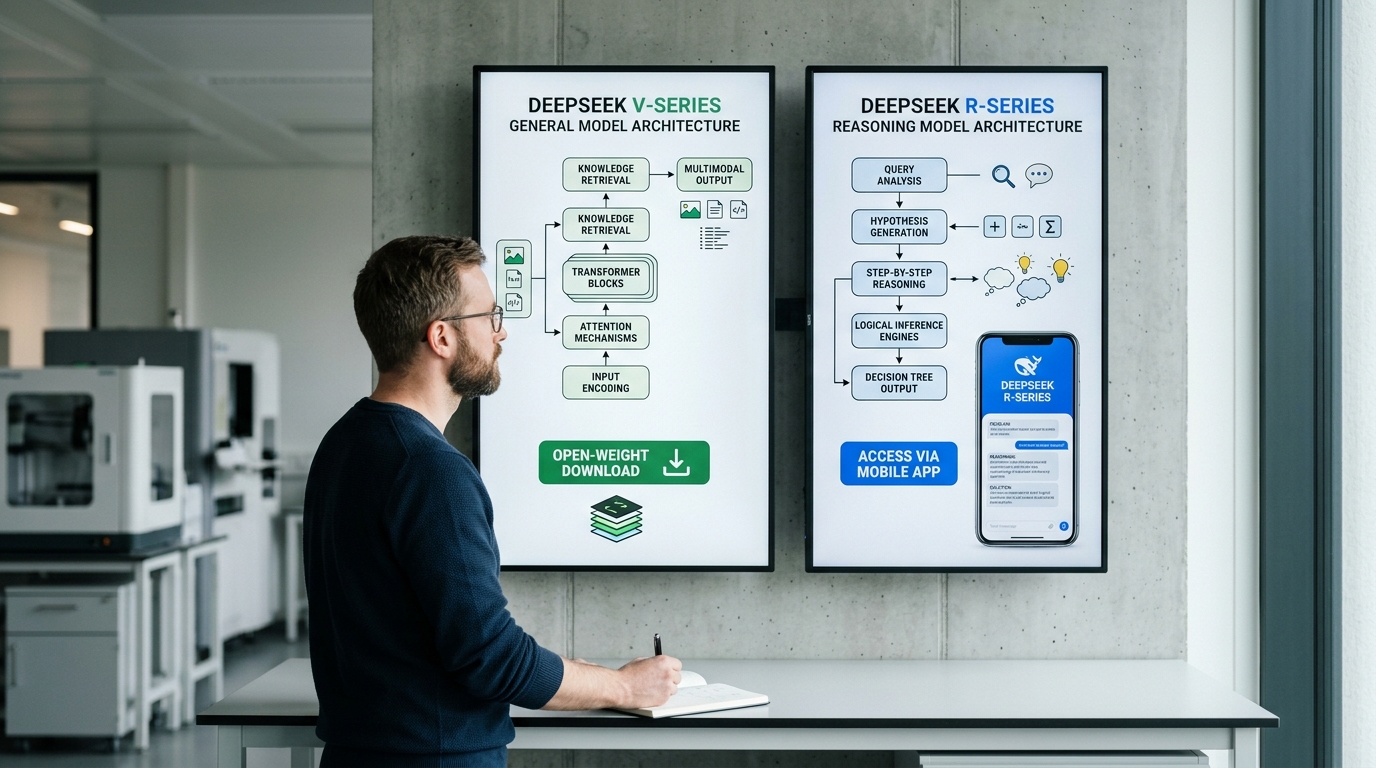
deepseek是中国杭州深度求索公司于 2023 年成立后推出的开源大语言模型系列,核心分为 V 系列通用模型和 R 系列推理模型,模型权重免费开放下载。其 R1 模型官方公布的训练成本约 557 万美元,仅为同级闭源模型的约十分之一;2025 年 1 月,deepseek 手机应用曾登上苹果 App Store 美国免费榜下载量第一名。
核心要点
- DeepSeek 2023年成立于杭州,模型权重免费开放下载。
- 日常对话选V系列,数学代码等复杂推理选R系列。
- V4.1-Flash支持原生多模态,可直接识别图片内容。
- R1训练成本约557万美元,仅同级闭源模型约十分之一。
- 万仅含最终训练GPU费,不含研发与失败实验成本。
关键速览
- DeepSeek 成立于 2023 年,总部在中国杭州。
- 其 V3 与 R1 系列模型开源,可本地部署或调用 API。
- R1 主打推理能力,专为数学、代码等复杂任务设计。
- 训练成本远低于同级闭源模型,引发行业关注。
- 模型有知识截止时间,不能实时联网,这是硬边界。
DeepSeek到底是什么?
DeepSeek 是中国杭州深度求索公司开发的开源大语言模型系列。这家公司成立于 2023 年,总部设在杭州。它的产品分两条线:V 系列通用模型负责日常对话、写作、翻译,R 系列推理模型专攻数学、代码和多步骤逻辑题。模型权重免费开放下载,普通用户零门槛就能用。
两条产品线怎么选?看任务类型:
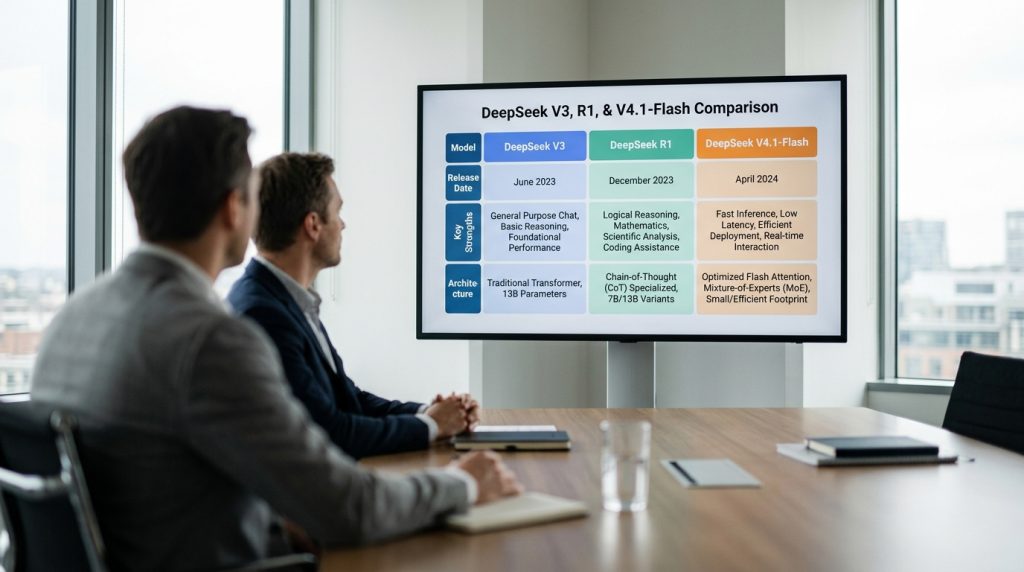
- V 系列(通用模型):回答快,适合聊天、摘要、起草文案。2026 年 9 月发布的 V4.1-Flash 在速度和成本上进一步优化,还加入了原生多模态视觉理解(能直接看懂图片内容)。
- R 系列(推理模型):回答前会先”想”,把思考步骤展开再给答案,解题准确率更高,但响应更慢。
“开源权重”是关键词
它指模型训练后的全部参数公开,开发者可下载到自己服务器运行,不用联网、不交数据给第三方。这解决了两个老问题:企业怕数据外泄,个人怕付费墙。相比之下,很多闭源模型只开放 API,参数藏在云端。
这个门槛有多低?2025 年 1 月,DeepSeek 的手机聊天应用一度登上苹果 App Store 免费榜下载量第一名,普通人下个 App 就能用上和 R1 推理模型同源的能力。
DeepSeek为什么能用十分之一成本撼动OpenAI?
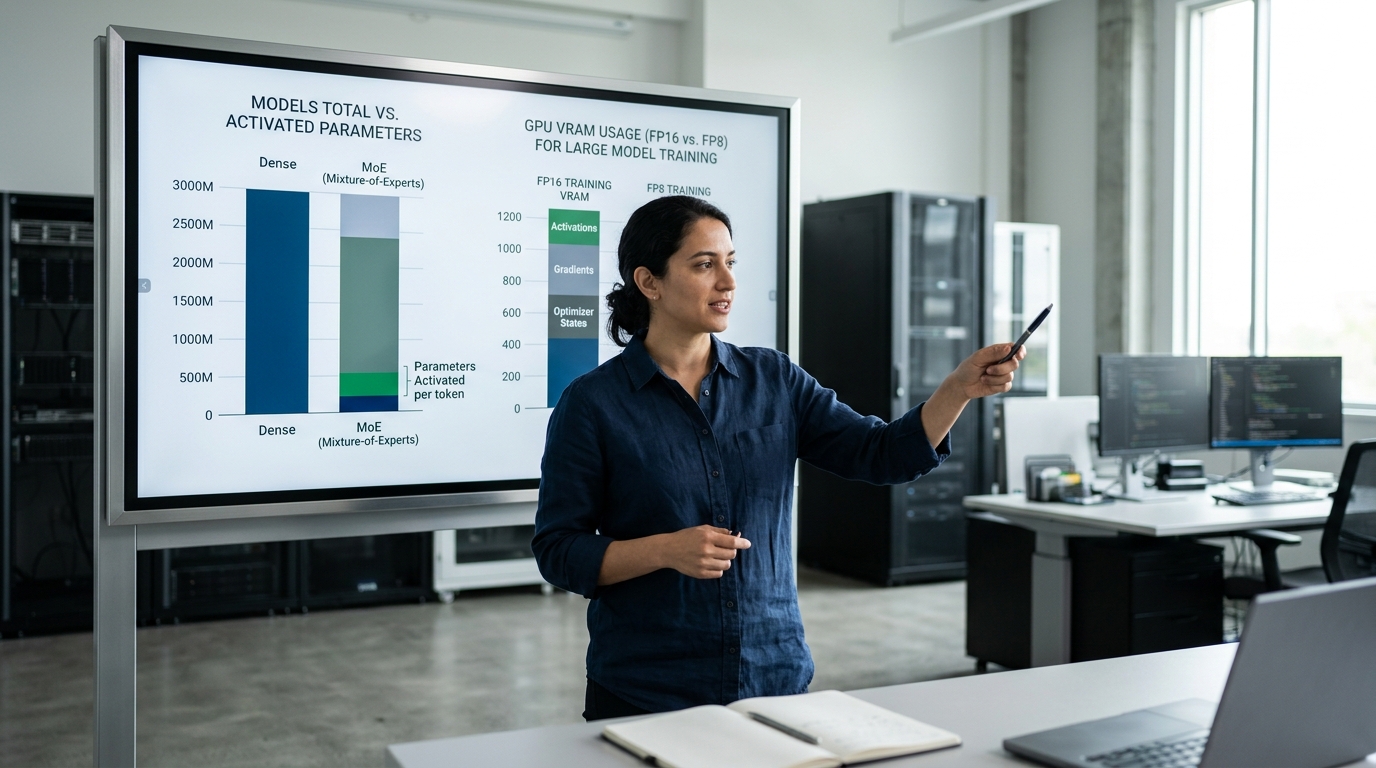
DeepSeek R1 官方公布的训练成本约 557 万美元,仅为同级别模型训练费用的约十分之一。关键不在于省钱,而在于三项工程选择:MoE 混合专家架构、FP8 低精度训练和强化学习驱动的推理训练。但这个数字只算了最后一次正式训练的 GPU 租用费,不含前期研发、失败实验和硬件折旧。
557 万美元是怎么省出来的?
省钱靠的是不让每个参数都参与计算。MoE(混合专家,Mixture of Experts)把模型拆成多个”专家”子网络,每次只激活其中一小部分。
- MoE 架构:总参数量巨大,但单次推理只唤醒一部分专家,算力消耗大幅下降。
- FP8 低精度训练:用 8 位浮点数代替常见的 16 位,显存占用减半,训练速度更快。
- 强化学习推理:R1 主要靠奖励信号自己摸索解题步骤,减少了昂贵的人工标注数据。
这个数字真的能信吗?
不能完全信。DeepSeek 官方自己也说明,557 万美元只覆盖最终训练阶段。实际投入还要加上数据清洗、多轮失败试验和显卡采购成本,这些往往是训练费的数倍。2025 年 1 月,R1 发布后一度登上美国 iPhone 应用免费榜第一,但热度不等于低成本结论成立。看模型机制,别只看省钱标题。
DeepSeek是怎么生成回答的?
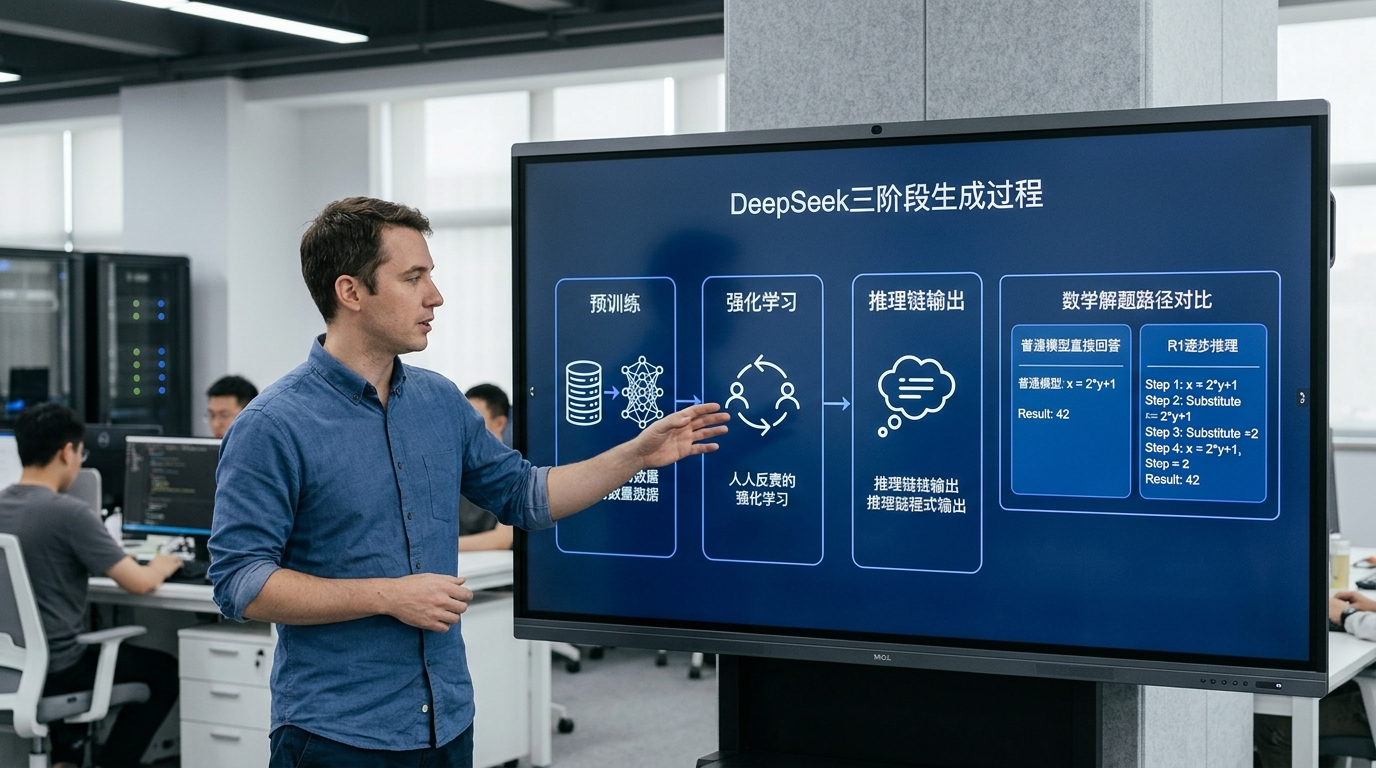
DeepSeek 生成回答分三步:先在海量文本上预训练学会语言规律,再用强化学习教它”怎么把问题想清楚”,最后 R 系列模型会在答题前输出一段可见的推理链(chain-of-thought,即把解题的中间步骤一条条写出来)。2026 年 9 月发布的 V4.1-Flash 进一步提升了推理和 Agent 性能。
推理链和普通对话有什么不同?
普通对话模型拿到数学题,往往一口气直接报答案,错了也看不出错在哪。R 系列不一样:它先在内部生成一长串”草稿”,把问题拆成小步,逐步验算,再给结论。
举个实际差别。遇到”某数的 约 15% 是 45,这个数是多少”,普通模型可能跳步算错。R1 会先写出”设该数为 x,则 0.15x=45,x=45÷0.15=300″,每一步都留痕。这种显式推理让编程题和多步逻辑题的正确率明显高于直接输出。
强化学习在这里起什么作用?
强化学习负责奖励”算对的思路”。训练时,模型每生成一条推理链,系统就核对最终答案对不对,对了给正反馈。反复几十万轮后,模型自己学会了检查、回溯、换方法,这些能力不是人手工写进去的,而是奖励信号逼出来的。
DeepSeek和ChatGPT、Gemini、Claude哪个更好?
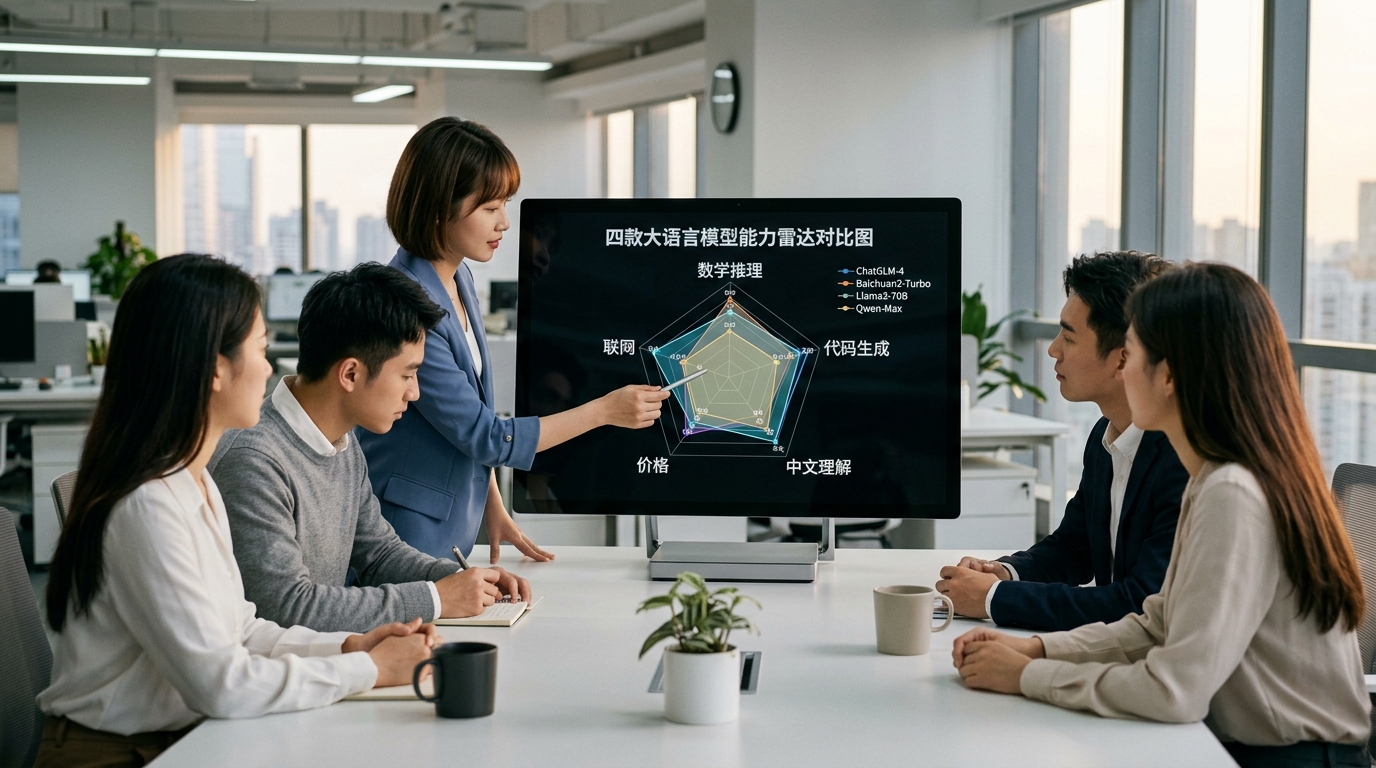
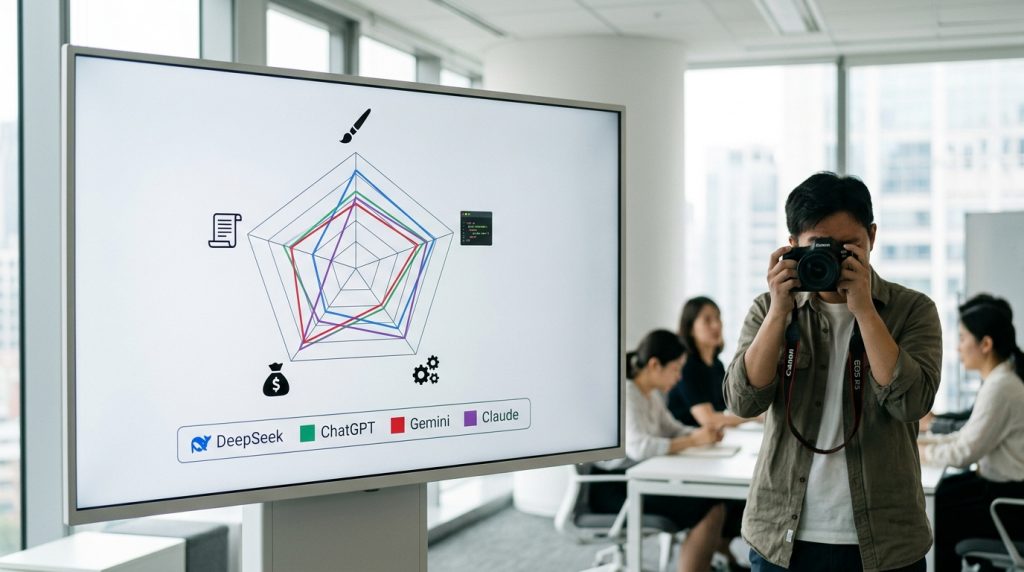
没有哪款模型全面胜出。DeepSeek 在数学推理和中文理解上接近第一梯队,调用价格只有闭源模型的几分之一;但它在复杂 Agent(自动执行多步任务的智能体)调度和超长文档处理上,仍落后于Claude和Gemini。2026 年 9 月发布的 V4.1-Flash 补上了原生多模态视觉能力,但速度和生态成熟度还在追赶。
⚠️ 常见错误:把 R1 的 557 万美元训练成本当作”复刻 DeepSeek 的总投入”。原因:该数字只覆盖最后一次正式训练的 GPU 租用费,不含数据清洗、多轮失败试验和显卡采购,这些常是训练费的数倍。修复:引用时注明”仅最终训练 GPU 费”,别把它当完整研发成本。
先说能力分布
R 系列推理模型的强化学习训练,让它在高难度数学题上表现亮眼;代码生成则擅长单文件逻辑题,但跨文件重构和大型项目的上下文维持不如 Claude。中文理解是 DeepSeek 的主场,训练语料里中文比例高,古文、方言、专业术语都比英文为主的模型更稳。
| 维度 | DeepSeek | ChatGPT | Gemini | Claude |
|---|---|---|---|---|
| 数学推理 | 强 | 强 | 中 | 中强 |
| 代码生成 | 单文件强 | 综合强 | 中 | 大项目最强 |
| 中文理解 | 最强 | 中强 | 中 | 中 |
| API 价格 | 最低 | 高 | 中 | 高 |
| 联网搜索 | 有限 | 成熟 | 最成熟 | 有限 |
哪类任务别用 DeepSeek?需要实时联网核实事实的查询、跨几十个文件的代码库重构、以及对数据合规要求严格的企业场景。这三类场景的真实边界,下一节会拆开讲。
DeepSeek能做什么?联网搜索、文件处理与代码的真实边界
DeepSeek 最擅长三件事:写代码、读结构化文档、做数学与逻辑推理。它的短板是实时信息、超长文件和复杂多模态任务。2026 年 9 月发布的 V4.1-Flash 加入了原生多模态视觉理解,但图表和手写识别的准确率仍不及专门的视觉模型。想用好它,先分清哪些任务它真能扛。
写代码和读文档,DeepSeek 做得怎么样?
代码是 DeepSeek 的强项。R 系列推理模型能把一个 Python 报错逐行推演,给出修复方案。2026 年它还与华为合作开发了面向 Ascend 芯片的编程工具。读文档方面,V4-Pro 支持更高上下文长度,几千字的技术手册、合同条款它能准确抽取要点。但超过上下文上限的长文件(比如上百页 PDF),它会”记不住”前半部分,导致答案自相矛盾。
DeepSeek 答不好哪些任务?
- 实时信息:股价、今日新闻、刚上线的 API,模型训练数据有截止日期,联网检索也可能抓到过期页面。
- 超长文件:整本书、海量日志,超出上下文窗口就丢信息。
- 复杂多模态:密集图表、手绘草图、视频内容,识别误差明显大于纯文本。
判断标准很简单:任务越依赖”此刻的外部世界”或”海量上下文”,DeepSeek 越吃力;越是封闭、可推理的问题,它越强。
使用DeepSeek时常踩的坑与信息核验方法
用 DeepSeek 最常栽的三类坑是:数字幻觉、过时信息、推理链看着严密其实前提错了。核验方法也只有三招:交叉验证、强制要出处、分步追问。记住一点,R 系列把推理过程写得越漂亮,你越要警惕,流畅的推理链不等于正确的结论。
数字幻觉怎么防?
模型会一本正经地编出精确到小数点的数字,比如”该药物有效率 约 73.6%”,但原始论文里根本没这个数。防法:凡是涉及具体数值、年份、人名、引文,让它给出可核验的出处,再自己点进去看。没有出处的精确数字,默认当它是编的。
过时信息怎么识别?
DeepSeek 的知识有训练截止日期,不联网时它不知道之后发生的事。但它不会主动说”我不确定”,反而会用旧数据硬答。追问一句”这是哪一年的数据”,常常就能逼出它的知识边界。涉及价格、版本、政策这类高频变动的内容,必须另找原始来源核对。
推理链过度自信怎么破?
把一道复杂题拆成三四步分别追问,比一次性问完更靠谱。每步让它只解决一个子问题,错误更容易暴露。成立于 2023 年的 DeepSeek 的 R 系列推理虽强,但遇到前提隐含错误时,它会沿着错的方向推得特别顺,这正是最危险的地方。
DeepSeek的数据隐私与中国背景引发了哪些争议?
核心争议只有一条:用官方云端服务时,你的对话数据存在中国境内的服务器上,受中国法律管辖。2025 年 1 月 DeepSeek 的移动应用登上美区 App Store 免费榜第一后,多国政府机构随即限制公职人员在办公设备上安装。
担忧主要有三块
一是数据主权,境内存储意味着数据可能依法被调取。二是内容审查,官方云端对部分政治话题会拒答或给出受限回答。三是合规空白,欧盟 GDPR(通用数据保护条例)要求的跨境数据传输保障,官方 App 未必满足。
本地部署和官方云端,隐私差在哪?
差别是质变,不是程度。DeepSeek 的模型权重开源免费下载,你把模型跑在自己的服务器或电脑上,对话数据根本不出本地网络,官方服务器看不到任何内容。审查过滤也主要作用在云端 API 层,本地权重版约束更弱。
| 维度 | 官方云端 App/API | 本地部署开源权重 |
|---|---|---|
| 数据存储位置 | 中国境内服务器 | 你自己的设备 |
| 第三方可见性 | 服务商可访问 | 无外部访问 |
| 部署门槛 | 注册即用 | 需 GPU 与运维能力 |
建议很直接:处理商业机密、个人敏感数据、合规受限行业,走本地部署;普通聊天、学习、写代码且不涉密,官方云端省事够用。
总结与使用建议
一句话选型:日常对话和写作用 V 系列,数学代码和多步逻辑用 R 系列,怕数据外流就本地部署开权重模型。DeepSeek 的技术意义在于证明了低成本路线可行,2026 年 9 月 Reuters 报道其年化收入已突破 10 亿美元,说明便宜的推理价格撑得起真实商业需求。
按任务和隐私需求挑,别一把梭。三条实操清单:
- 隐私敏感场景:含客户资料、合同、医疗数据的任务,走本地部署或私有云,绝不走官方云端——数据存中国境内这条底线不能碰。
- 成本敏感的高并发场景:客服脚本、批量翻译、代码补全这类调用量大的活,用 V4.1-Flash,单位成本比闭源低好几倍。
- 硬核推理场景:数学证明、算法题、财务建模,用 R 系列,但记得盯紧它的推理链前提。
最关键的习惯:把 DeepSeek 当草稿机,不当答案机。涉及数字、日期、法条的输出,一律交叉验证并强制要出处。推理链写得越漂亮,越要查它第一步的前提是否成立。混着 ChatGPT、Gemini 用,让一个模型的答案去校验另一个,这才是 2026 年用 AI 该有的姿势。