5 个维度读懂 DeepSeek AI 的模型与应用
deepseek ai是中国杭州公司「深度求索」于 2023 年创立后推出的大语言模型系列,主力产品包括 DeepSeek-V3 和推理模型 DeepSeek-R1。V3 参数规模达 6710 亿,采用混合专家(MoE)架构;R1 以 MIT 许可证开源发布,可商用。据 IBM 报道,DeepSeek-R1 在部分数学和编程测试上追平 OpenAI 的 o1,调用成本却便宜约 96%。
核心要点
- DeepSeek-R1 以 MIT 许可证开源,权重可下载私有部署、可商用
- R1 推理能力追平 OpenAI o1,调用成本却便宜约 96%
- V3 参数达 6710 亿,用 MoE 架构,奠定低成本预训练底子
- R1 训练成本约 560 万美元,比 GPT-4 级模型低约 20 倍
- 选型建议:要省钱推理选 DeepSeek,要成熟生态选 ChatGPT
关键速览
- DeepSeek 成立于 2023 年,总部设在中国杭州
- 主力模型包括 DeepSeek-V3 与推理模型 DeepSeek-R1
- R1 以开源方式发布,采用 MIT 许可证,可商用
- V3 参数规模达 6710 亿,采用混合专家(MoE)架构
- 编程、数学推理、中文任务是其核心强项场景
DeepSeek AI 到底是什么?和 ChatGPT 有什么不同?
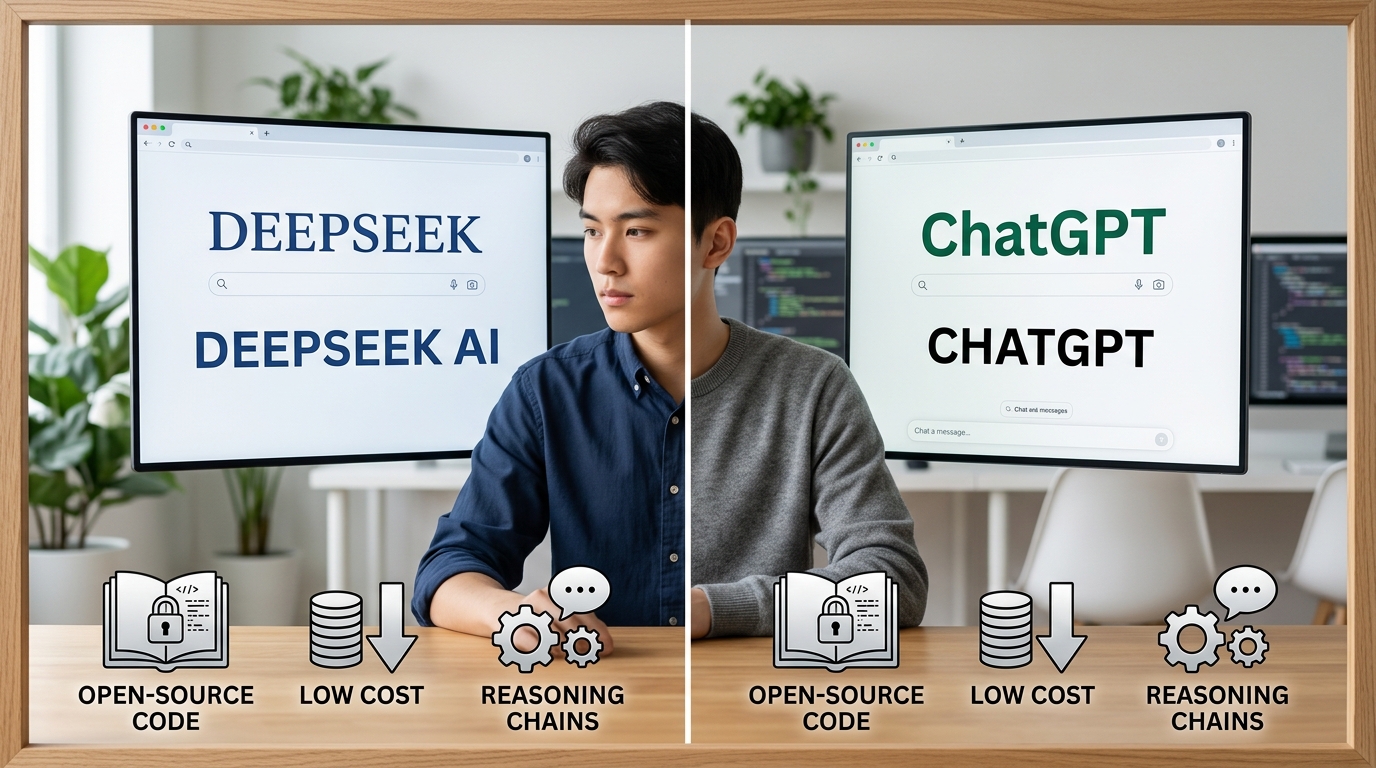
DeepSeek AI 是中国杭州公司「深度求索」于 2023 年创立后推出的大语言模型系列。它和ChatGPT最大的区别有三点:模型权重开源、使用成本低、推理能力强。据 IBM 的报道,其 DeepSeek-R1 推理模型在部分数学和编程测试上追平 OpenAI 的 o1,调用成本却便宜约 96%。
先说清楚什么是「大语言模型」:
它就是一个用海量文本训练出来、能理解和生成人类语言的 AI 程序。ChatGPT 和 DeepSeek 都属于这一类。但两者走的路完全不同。
ChatGPT 走闭源路线,模型内部结构不公开,你只能通过官方接口付费调用
DeepSeek 反着来,它把 V3 和 R1 两款模型当作开源项目,公开了模型权重(训练好的参数文件)、推理代码和技术文档。这意味着开发者能把模型下载到自己的服务器运行,不必把数据交给第三方。
推理能力是另一个分水岭
普通模型看到问题直接给答案,推理模型会先在内部「想一步步怎么算」,再输出结果,像人做数学题时打草稿。这类任务里 DeepSeek-R1 的表现尤其突出。
名气也不是空谈。2025 年 1 月,DeepSeek 的 AI 助手 App 登上苹果美国区免费应用下载榜第一名,一度引发全球关注。简单说:想要可私有部署、省钱、擅长推理,选 DeepSeek;想要成熟生态和多语言客服支持,ChatGPT 仍有优势。
DeepSeek 为什么能用更低成本撼动 OpenAI?
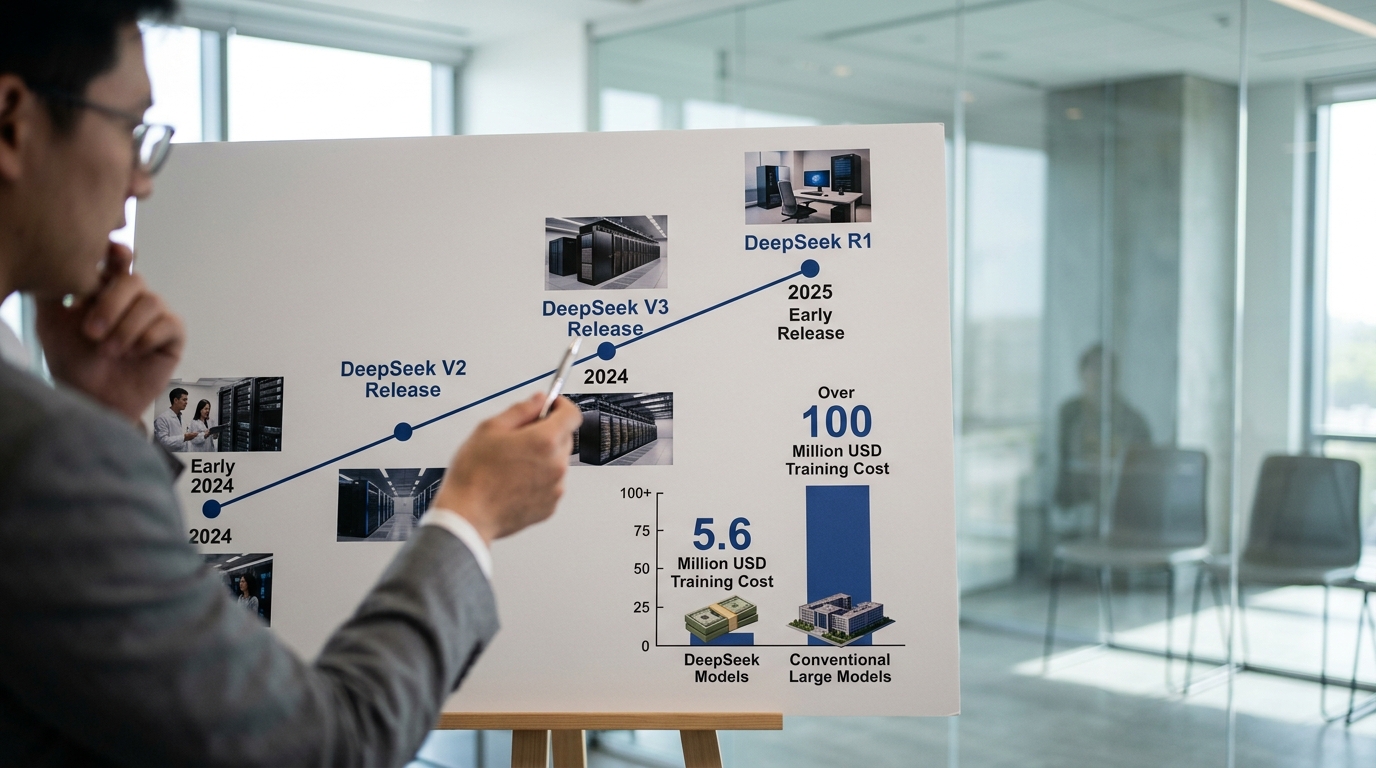
DeepSeek AI 撼动 OpenAI 的核心,是「同等能力、极低价格」。据 IBM 的报道,其 R1 推理模型在部分数学和编程基准上追平 OpenAI 的 o1,使用成本却约低 约 96%。这意味着开发者能用零头的钱,拿到接近顶级闭源模型的推理表现。
震动来自时间线
V2 先验证了低成本训练路线,V3 接棒做大基础模型,R1 则在 2025 年 1 月引爆关注。
- DeepSeek-V3:通用基础模型,奠定低成本预训练的工程底子。
- DeepSeek-R1:主打推理(会「分步思考」再答题),对标 o1。
市场最在意的是那个传闻数字:
R1 相关训练成本约 560 万美元,而 GPT-4 这类模型普遍被估为上亿美元级投入。差距约 20 倍。这个对比直接冲击了「AI 必须烧天量算力」的共识,也让英伟达等芯片股在 2025 年 1 月剧烈波动。
效果立竿见影
据 美国国会研究服务处记录,V3 与 R1 连同免费聊天应用在 2025 年 1 月引发全球关注,App 一度登上美区 Apple 免费榜第一。真正撼动对手的,不是单一指标,而是「开源权重 + 低训练成本 + 免费可用」三者叠加,把高端模型的门槛一次性拉低。
DeepSeek 的 MoE 架构和推理模型是怎么工作的?
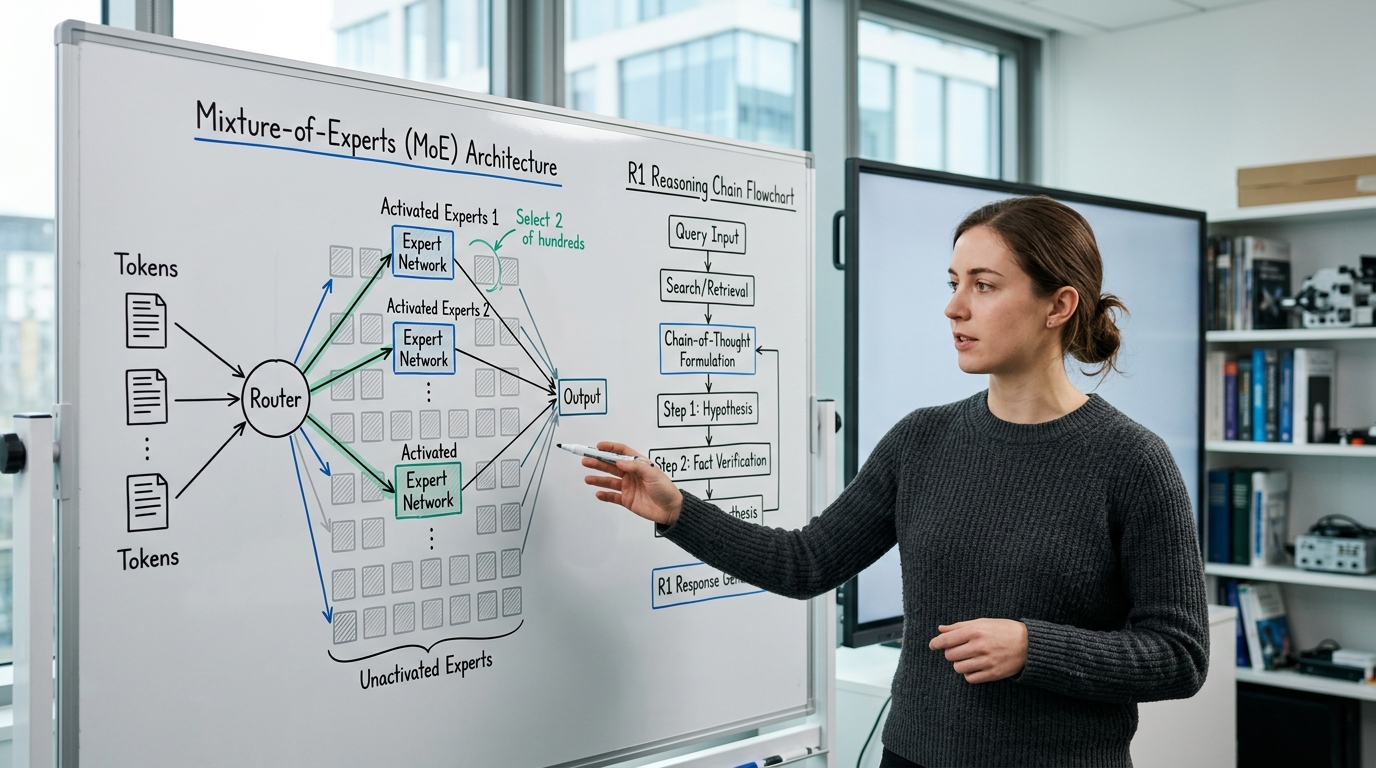
DeepSeek AI 的省算力秘诀,是混合专家架构(MoE,Mixture of Experts)。它的 V3 模型总参数达 6710 亿,但每处理一个词只唤醒约 370 亿个参数,只占总量 约 5.5%。这样推理时算力消耗大幅下降,却保留了大模型的知识容量。对开发者来说,意味着同等答题质量下,服务器账单低得多。
MoE 是怎么只激活一小部分参数的?
把模型想成一家有几百名专科医生的医院。你挂号看感冒,系统只叫内科医生,不会把外科、眼科全部喊来会诊。MoE 的「路由器」(router)就是这个分诊台:它读懂当前任务,只调用最相关的几个「专家」子网络。
- 专家网络(Experts):数百个独立的前馈子网络,各自擅长不同类型的内容,如代码、数学、自然语言。
- 路由门控(Gating):每个词进来,门控网络打分,只选前几个专家激活,其余保持休眠不耗算力。
- 共享专家(Shared Experts):DeepSeek 保留少量始终在线的专家,处理通用知识,避免路由出错导致质量塌陷。
R1 的强化学习推理链和普通模型差在哪?
R1 的区别在于「先想后答」。它用强化学习训练模型自己生成一长串推理步骤,再给结论,而不是脱口而出。据 IBM 的报道,DeepSeek-R1 在部分数学和编程基准上追平 OpenAI 的 o1,使用成本却约低 约 96%。遇到复杂数学题时,这条推理链能自我检查、纠错,正是它接近 o1 水平的关键。
DeepSeek、ChatGPT 和 Gemini 哪个更好?能力与价格横向对比
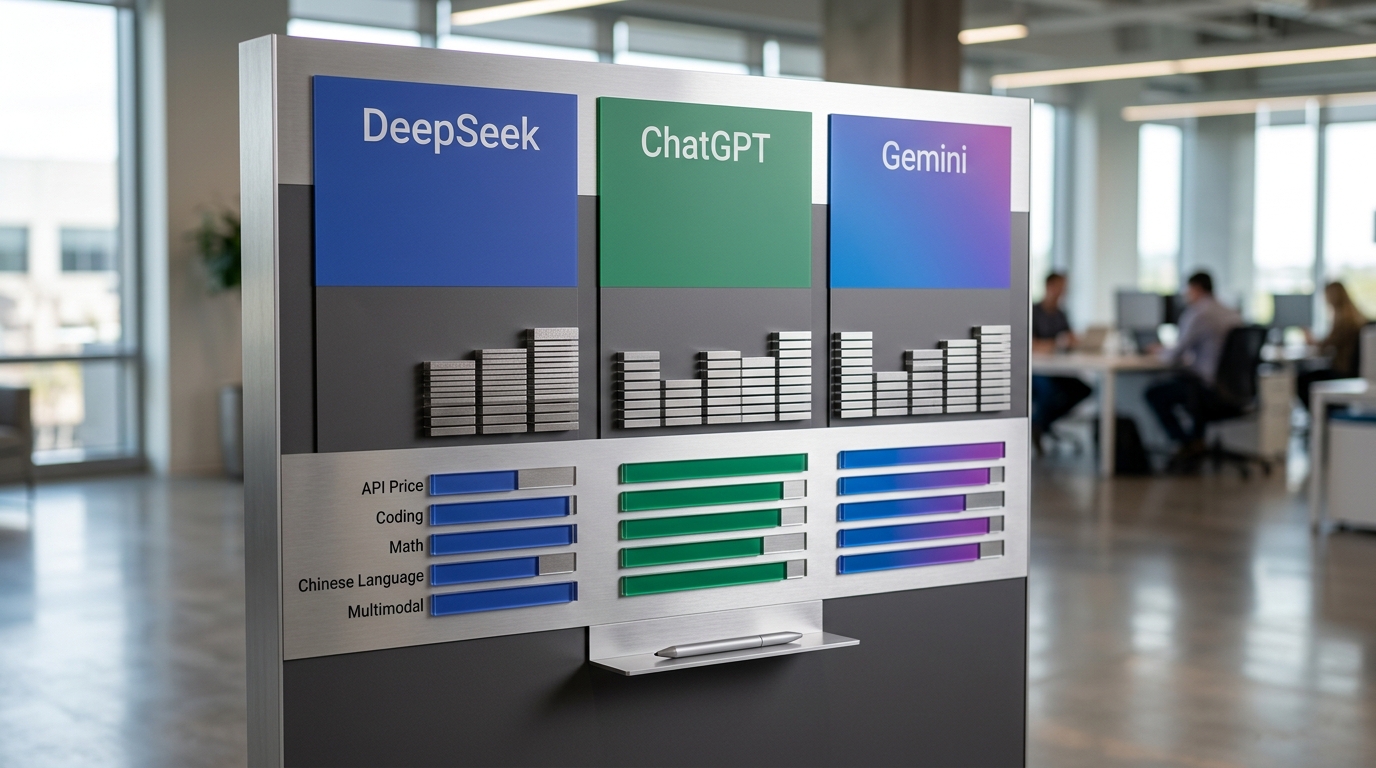
没有「绝对更好」,只有「哪个更划算」。在数学和代码任务上,DeepSeek-R1 已在部分基准追平 OpenAI 的 o1,据 IBM 2025 年报道使用成本约低 约 96%。换句话说:预算紧、任务偏推理,选 DeepSeek;要原生多模态和成熟生态,ChatGPT 或 Gemini 更稳。
💡 反直觉: DeepSeek-V3 总参数高达 6710 亿,但每处理一个词只激活约 370 亿参数,仅占总量 5.5%。证据:这种 MoE 架构让推理算力大幅下降,R1 训练成本约 560 万美元,比 GPT-4 级模型低约 20 倍,证明大模型未必要靠全量参数烧算力。
| 维度 | DeepSeek AI | ChatGPT(GPT 系列) | Gemini |
|---|---|---|---|
| API 价格趋势(每百万 token) | 最低档,R1 约为 o1 的 1/25 | 中高档 | 中档,有免费层 |
| 代码能力 | 强,R1 基准接近 o1 | 强,生态工具最全 | 强,深度集成 Google Workspace |
| 数学推理 | 优势项,链式推理透明 | 优秀 | 优秀 |
| 中文理解 | 母语级,本土语料训练 | 良好 | 良好 |
| 多模态 | V4.1-Flash 起支持原生视觉 | 成熟(图像/语音) | 原生多模态,强项 |
按预算分三类选:日调用量大的后端批处理,选 DeepSeek 省钱;需要处理图片、视频等混合输入的产品,Gemini 的原生多模态更顺手;团队已用 Microsoft 或开发插件生态,ChatGPT 迁移成本最低。DeepSeek 的新模型 V4.1-Flash 加入了原生视觉理解,正在补齐多模态这块短板。
DeepSeek AI 能用来做什么?真实应用场景与能力边界
DeepSeek AI 最擅长四类任务:编程辅助、长文档分析、数学解题和内容创作。据 IBM 2025 年的报道,其 R1 推理模型在部分数学和编程基准上追平 OpenAI 的 o1。所以写代码、做数据推理这类「硬逻辑」活,它交付质量稳定,适合当日常生产力工具。
哪些场景最适合用 DeepSeek?
推理驱动的任务是它的主场。具体包括:
- 编程辅助:写函数、排查 bug、解释报错日志。2026 年路透社报道,DeepSeek 已与华为合作开发针对昇腾芯片的编程工具,在国产算力场景下有实际落地。
- 长文档分析:读合同、提炼论文、整理会议纪要,一次塞进几万字也能抓住重点。
- 数学解题:R1 会把推理步骤写出来,方便你核对哪一步出错,而不是只给一个答案。
- 内容创作:起草文案、改写邮件、生成大纲,中文语感比多数海外模型更顺。
DeepSeek 做不好什么?
它有三块明显短板,用之前要清楚。第一是实时联网弱,问「今天股价」或当天新闻容易答不上或过时。第二是图像生成缺失,V4.1-Flash 虽加了原生多模态视觉理解(能看懂图),但看图不等于画图。第三是幻觉控制,模型可能把不存在的引用说得很确定。涉及法律、医疗、财务数字时,务必人工复核。deepseek 的建议是:把它当高效的「初稿引擎」,而非终审。
用 DeepSeek 安全吗?数据隐私、合规争议与各国限制
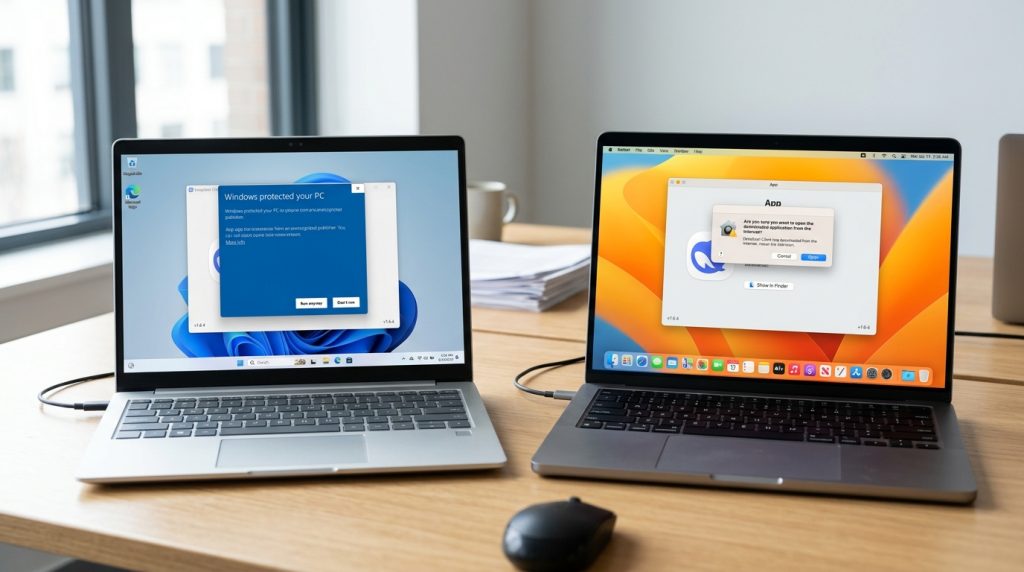
看你怎么用。公开的网页版和官方 App 会把数据存在中国境内,这触发了多国的合规顾虑;但 DeepSeek 的 V3 和 R1 模型权重已开源(2025 年,美国国会研究服务处),企业可把模型下载到自己的服务器本地跑,数据完全不出门。
争议的导火索是 2025 年 1 月
当时 DeepSeek 助手冲上苹果 App Store 免费榜第一(2025 年),引发各国监管关注。意大利数据保护局随后下令应用商店下架该 App;韩国多个政府部门和企业禁止员工在办公设备上使用;美国部分联邦机构也发出设备禁用令。
顾虑的核心是「数据主权」,你输入的内容(Data at rest,即静态存储的数据)落在中国服务器,受当地法律约束。对处理用户隐私、商业机密或政府数据的机构,这是合规红线。
避坑判断很简单:
- 个人试用:网页版随便用,别输入身份证、银行卡这类敏感信息即可。
- 企业内部工具:走本地部署或私有云,用开源权重自建,数据不回传。
- 受监管行业(金融、医疗、政务):先查你所在地区的数据跨境规定,必要时只用本地部署版本。
一句话:模型本身没问题,风险在「数据往哪存」。想合规,就把 DeepSeek AI 装进自己的机房。
如何免费使用 DeepSeek?网页版与 API 接入步骤
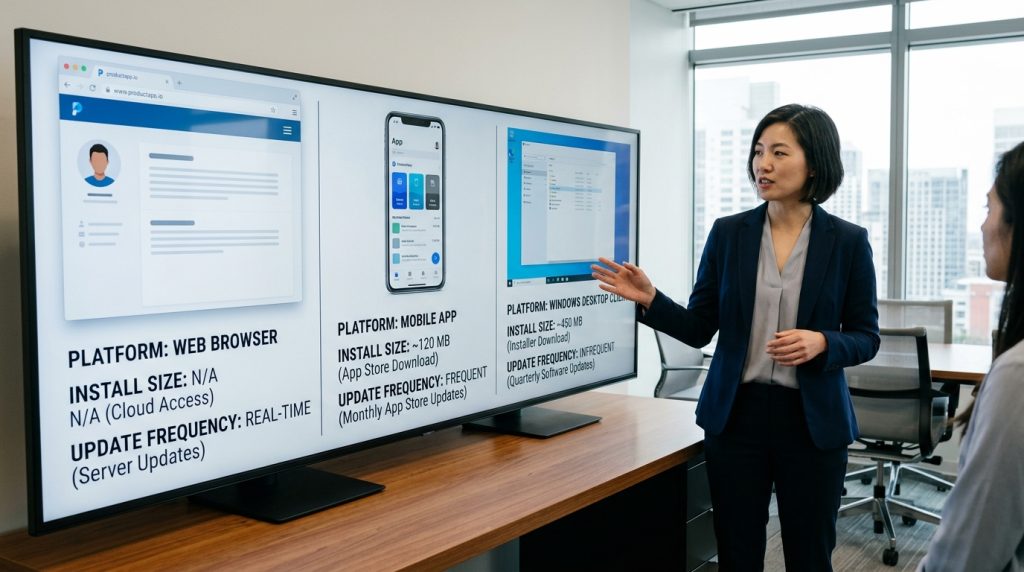
普通用户零成本:打开网页版或下载官方 App 即可免费对话。DeepSeek 的官方移动应用在 Apple App Store 和 Google Play 都上架,应用商店页面明确标注为官方 AI 助手、免费使用。2025 年 1 月,它一度登上 Apple iPhone 美区免费榜第一名。
网页版和 App 怎么用?
三步上手:访问deepseek-app.org或装好官方 App,用邮箱或手机号注册,然后直接输入问题。想做推理题或写代码,点开对话框里的「深度思考」开关,就会调用 R1 推理模型,它会先列出思路再给答案。全程不收费,也不需要绑定支付方式。
开发者怎么接入 API?控制成本的实操建议
登录开放平台(platform.deepseek-app.org),在控制台「API Keys」里点「创建」,复制生成的密钥,注意它只显示一次,务必立刻存好。调用接口兼容 OpenAI 的 SDK 格式,把 base_url 改成 DeepSeek 的地址、填入你的 Key 即可,旧代码几乎不用重写。
控成本有个被老手常用的技巧:
开启上下文缓存(context caching)。重复出现的系统提示词命中缓存后,这部分 token 的计费大幅下降,适合问答机器人这类前缀固定的场景。R1 的使用成本据 IBM 2025 年报道约比 OpenAI o1 低 96%,叠加缓存后更省。
总结 DeepSeek 适合谁用,下一步怎么选
DeepSeek AI 最适合三类人:预算紧的开发者、重推理任务的工程师、需要本地部署的企业。核心原因是它的 R1 推理模型在部分数学和编程基准上追平 OpenAI 的 o1,据 IBM 2025 年报道使用成本约低 96%。想试,网页版和官方 App 零门槛免费。
但有一个前提:
公开网页版和官方 App 会把数据存在中国境内,触发多国合规顾虑。如果你处理的是医疗、金融或政府敏感数据,别用公开入口。
按你是谁,下一步这样选:
- 个人学习者:直接用网页版或官方 App,免费对话。2025 年 1 月它曾登上苹果 iPhone 商店免费应用下载榜第一。
- 独立开发者:接 API,按量计费,拿接近顶级模型的能力只花零头。
- 企业与合规团队:下载开源的 V3、R1 权重,部署到自家服务器,数据不出门。
deepseek的建议很直接:任务偏硬逻辑推理、又卡预算,它就是性价比最高的选项;数据敏感,就走本地开源那条路,别碰公开云端入口。