DeepSeek AI 不只是聊天工具,关键在推理与开放接口
DeepSeek AI 是一家 2023 年 7 月由梁文锋在杭州创立的中国开源大模型公司,主力产品为 V3 通用模型和 R1 推理模型。它宣称以竞品几十分之一的成本对标 OpenAI 顶级性能,据官方数据,DeepSeek-R1 使用成本比同级领先模型便宜约 96%。其免费聊天应用于 2025 年 1 月发布后迅速登顶美国区 App Store 免费榜,并公开了模型权重与推理代码,供开发者本地部署。
核心要点
- DeepSeek由梁文锋2023年在杭州创立,主打开源大模型
- R1推理成本比同级模型便宜约96%,大幅压低API账单
- V3采用MoE架构,6710亿参数每次仅激活约370亿
- 模型权重开源,开发者可本地部署,无调用次数限制
- 聊天网页免费,API按token计费才是核心竞争力
关键速览
- DeepSeek 由 2023 年成立的杭州团队打造,主打推理与开放接口
- R1 推理模型把思考链摊开展示,可用于数学、代码等硬任务
- API 采用按 token 计费,成本低于多数主流闭源模型
- 模型权重开源,开发者可本地部署,不受调用次数限制
- 聊天网页免费,但 API 才是它区别于普通聊天工具的核心
DeepSeek AI 是什么?为什么它被称为「中国 AI 挑战者」?
DeepSeek AI 是一家中国开源大模型公司,于 2023 年 7 月由对冲基金创业者梁文锋在杭州创立,脱胎自量化投资机构幻方量化。它的主力产品是 V3 通用模型和 R1 推理模型。之所以被称为「中国 AI 挑战者」,是因为它宣称以竞品几十分之一的成本,做出了对标 OpenAI 和 Meta 顶级模型的性能,并把模型权重直接开源。
DeepSeek 靠哪几款模型出名?
DeepSeek 的名气建立在三代模型上。V3 是通用对话与文本模型;R1 是专攻逻辑的推理模型,IBM 将其描述为把「思维链推理」(模型先分步骤想清楚再给答案)与强化学习结合的模型。2026 年,官方站点又主推 DeepSeek-V4.1-Flash,宣称具备更强的文本、Agent 能力和原生多模态视觉理解(即能同时看懂图片和文字)。
为什么它能在 2025 年引发全球震动?
真正让市场炸锅的是成本。据该公司数据,DeepSeek-R1 的使用成本比同级领先模型便宜约 96%。其免费聊天应用于 2025 年 1 月发布后,迅速登顶美国区App Store免费榜。加上 美国国会研究服务处确认 V3 和 R1 公开了权重、推理代码与技术文档,开发者可自行部署,这套「低价加开源」的组合,直接动摇了闭源巨头的定价逻辑。
DeepSeek 的 MoE 混合专家架构是怎么工作的?
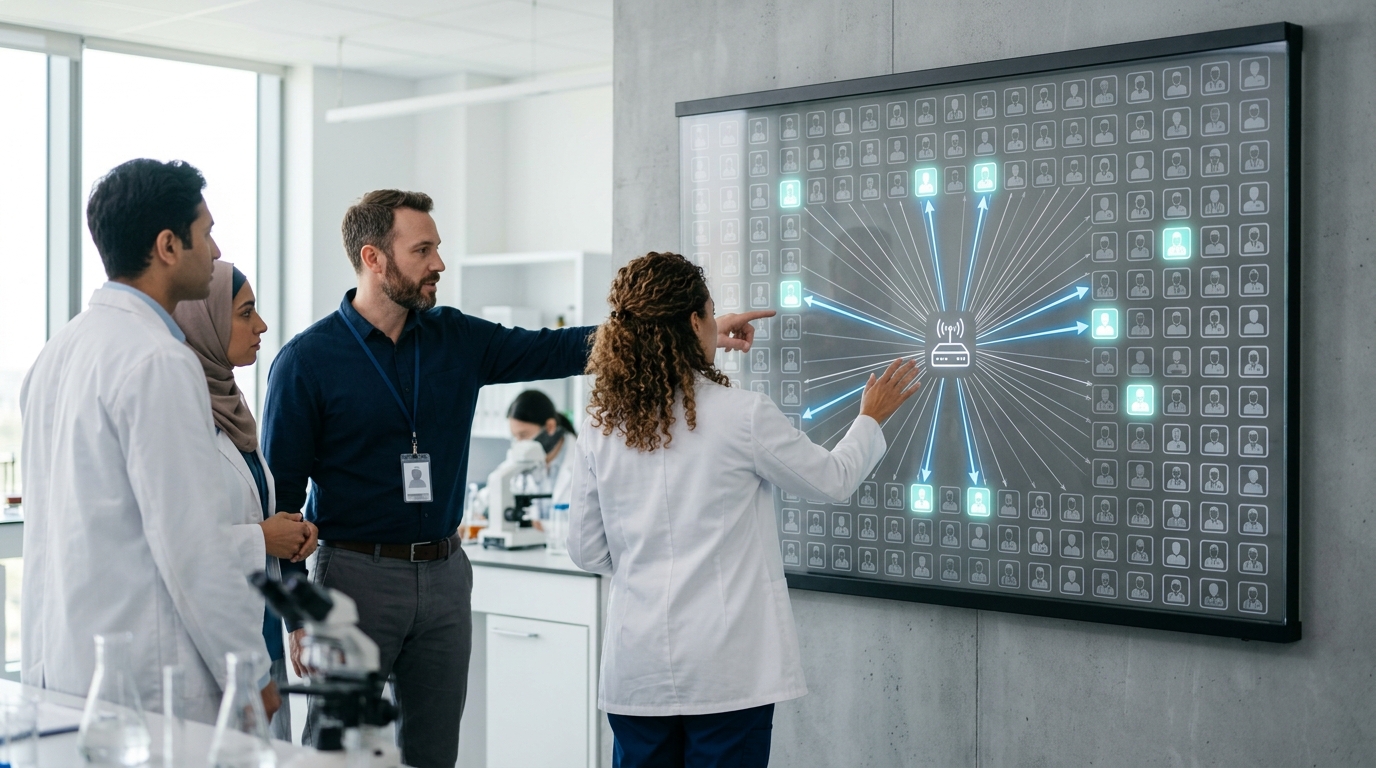
DeepSeek 的 V3 模型总共有 6710 亿个参数,但每处理一个词元(token,模型读写的最小文字单位)时只激活约 370 亿个,也就是仅唤醒总量的 约 5.5% 左右。这套稀疏机制叫 MoE(Mixture of Experts,混合专家)。它让 deepseek ai 在保持大模型能力的同时,把每次推理的算力砍到密集模型的一小部分。
可以把 MoE 想成一家有 256 个专科医生的医院
病人来了,前台(叫「路由器」)不会让所有医生一起会诊,只挑最对口的 8 位上阵。其余专家继续待命,不消耗计算。DeepSeek-V3 正是这样:每层配备大量细分专家,路由器为每个词元动态选出少数几个。
为什么省算力还不掉性能?
关键在于「相关专家」处理「相关内容」。写代码的词元交给擅长代码的专家,翻译交给语言专家,各司其职反而比一个笼统模型答得更准。
这种设计直接压低了使用成本
据 IBM 2025 年的分析,DeepSeek-R1 的使用成本比同级领先模型低约 96%。对开发者的实操意义很明确:跑同样的推理任务,账单可能只有原来的零头。
为什么 DeepSeek 训练成本只有竞品的几十分之一?
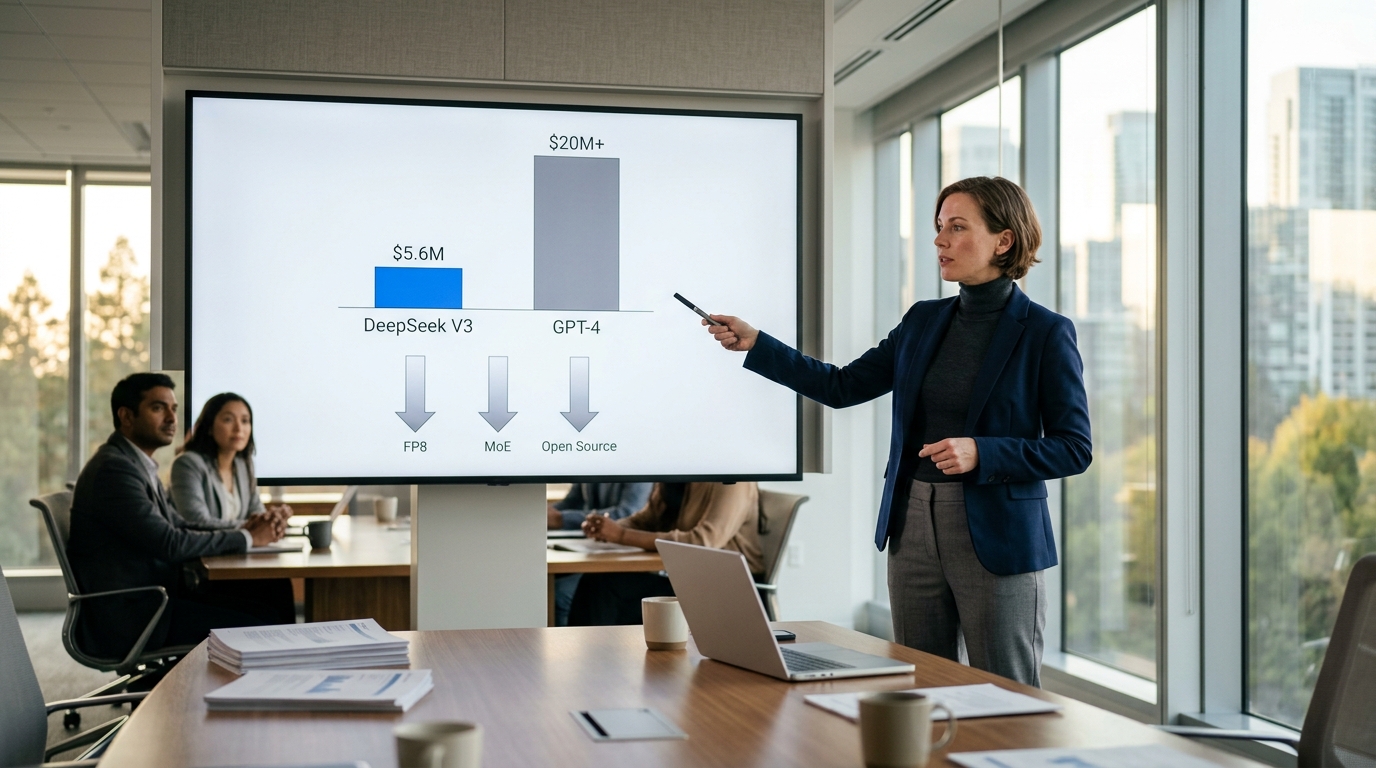
DeepSeek V3 的训练成本约为 560 万美元,而 GPT-4 一类模型的公开训练花费高达数千万甚至上亿美元。路透社 2025 年报道指出,DeepSeek AI 声称其 V3 和 R1 模型性能与 OpenAI、Meta 的顶尖模型相当,但训练与使用成本只是零头。这意味着「造好模型必须烧巨资」这条行业铁律被撕开了口子。
降本靠三件事叠加,而非单点魔法
- FP8 混合精度训练:用 8 位浮点数(FP8,一种更省内存的数字格式)替代常用的 16 位,显存占用直接砍半,同样的显卡能算更多。
- MoE 稀疏激活:每个词元只唤醒约 5.5% 的参数,大部分算力不浪费在闲置的「专家」上,训练与推理的算力开销大幅下降。
- 开源复用:不重复造轮子,直接站在已公开的算法与数据基础上迭代,省掉从零验证的高昂试错。
省下来的钱也传导到用户端
IBM 2025 年的分析称,DeepSeek-R1 的使用成本比同级领先模型低约 96%。对开发者的实操意义很直接:跑同一批推理任务,账单可能从每月上千美元降到几十美元。
DeepSeek 和 ChatGPT、Gemini、Claude 比,哪个更好?
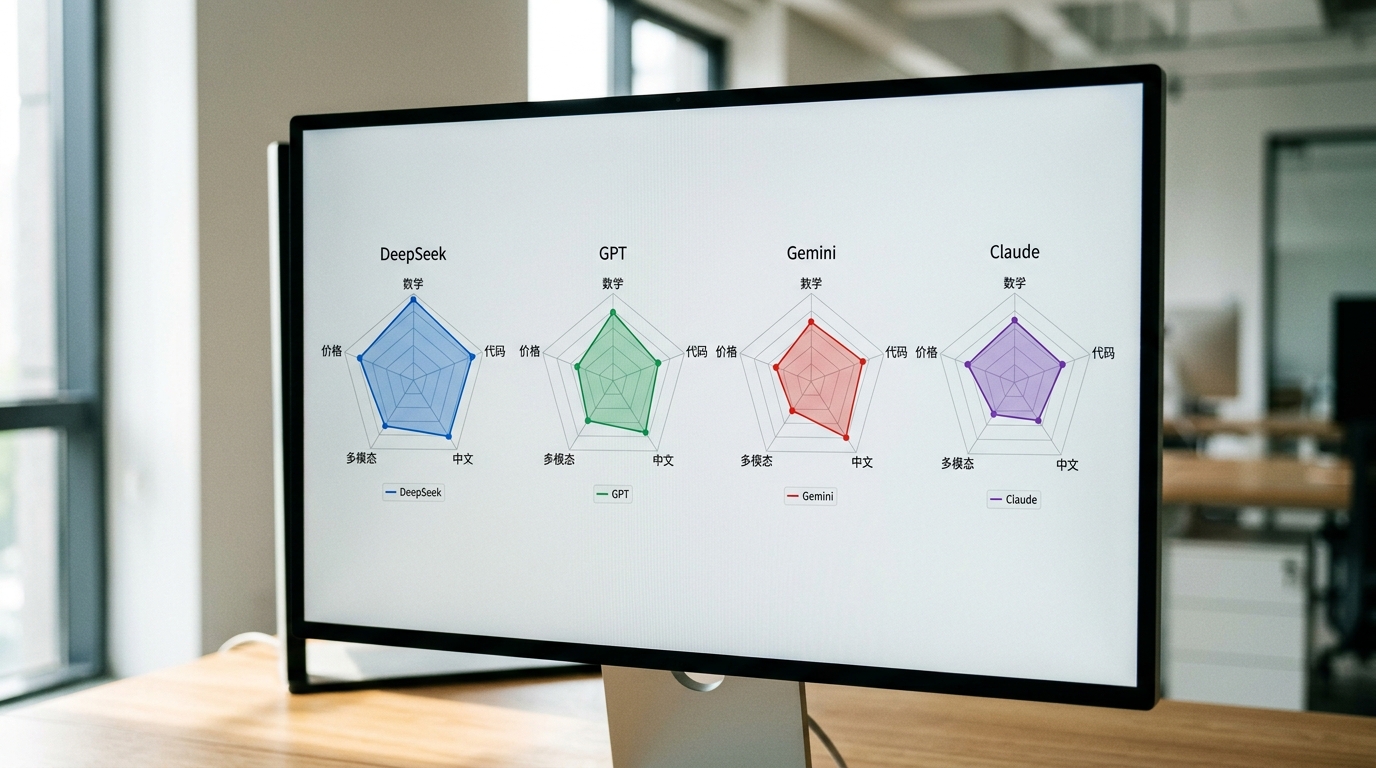
没有单一赢家。预算敏感、要跑数学推理和代码任务,选 DeepSeek AI;需要复杂图像、视频等多模态处理,选 Gemini 或 GPT。据 IBM 2025 年报道,DeepSeek-R1 的使用成本比同级顶尖模型低约 96%,这让它在批量调用场景里性价比突出。
⚠️ 常见错误: 把「聊天网页免费」当成 DeepSeek 的核心优势,忽略了它真正区别于普通聊天工具的是按 token 计费的 API。原因:网页版有交互与调用限制,规模化应用无法依赖。修复:接入 API 或本地部署开源权重,才能实现无调用次数限制的低成本推理。
下面按四项核心能力和 API 价格逐项对比,价格指每百万输入 token 的公开参考成本(2026 年初):
| 维度 | DeepSeek | GPT | Gemini | Claude |
|---|---|---|---|---|
| 数学推理 | R1 链式推理强 | 强 | 中上 | 中上 |
| 代码生成 | 强 | 强 | 中上 | 很强 |
| 中文能力 | 母语级 | 好 | 好 | 中上 |
| 多模态 | 原生视觉(V4.1) | 图文音视频 | 图文音视频最全 | 图文 |
| API 输入价(每百万 token) | 约 $0.27 | 约 $2.5+ | 约 $1.25+ | 约 $3+ |
DeepSeek 官网现已把 DeepSeek-V4.1-Flash 列为发布模型,补上了原生多模态视觉理解,缩小了与 Gemini 的差距。但 Claude 在长代码重构、GPT 在生态插件上仍各有专长。选型建议:高频跑推理任务优先 DeepSeek,追求全能多模态创作则用 GPT 或 Gemini。
DeepSeek 的文本、代码与推理能力分别适合哪些任务?
选模型看任务类型:日常问答和写作用 V3,数理推理和逻辑链用 R1,编程用 Coder。据 IBM 2025 年报道,R1 把思维链(chain-of-thought,模型一步步写出推理过程)和强化学习结合,专攻多步推理,用起来比同级模型便宜约 96%。用错模型,会白花算力还得不到最优答案。
V3 适合和不适合哪些文本任务?
V3 是通用模型,适合客服问答、文章草稿、邮件润色、摘要提取这类需要流畅表达的活。DeepSeek 官网还上线了 V4.1-Flash,据 DeepSeek 官方站点(2026)介绍,它文本和多模态视觉理解更强。不适合的场景:需要严格数学证明或复杂逻辑推导,这时 V3 容易跳步,答案看着对其实错。
R1 适合哪类推理任务?
R1 适合数学竞赛题、代码调试的逻辑分析、科研公式推导,这些任务需要模型把每一步想清楚再给结论。它会先输出一长段思考过程再给答案,所以延迟更高。不适合要求秒回的高频客服,等它想完,用户早跑了。
Coder 处理编程任务的边界在哪?
- 适合:函数补全、单元测试生成、代码翻译(如 Python 转 Java)、SQL 查询编写。
- 不适合:跨十几个文件的大型架构设计,模型缺乏项目全局上下文,产出的代码需人工整合。
DeepSeek 的数据隐私和安全争议是怎么回事?
核心争议在于数据存储地点。DeepSeek 是一家 总部位于杭州、2023 年成立的中国 AI 公司,其官方 App 的用户数据默认存放在中国境内服务器。多国监管机构据此担心数据可能被第三方调取,因而采取了下架或禁用行动。
2025 年 1 月 DeepSeek 免费聊天 App 冲上美国 App Store 免费榜第一后,监管反应很快跟上
意大利数据保护局要求应用商店下架该 App;韩国个人信息保护委员会暂停其本地下载;美国多个政府部门禁止在办公设备上安装。这些动作都指向同一个问题,跨境数据传输的合规性(是否符合当地数据保护法)。
企业和个人怎么办?实操建议如下:
- 敏感数据脱敏:上传前把姓名、身份证号、财务数字替换成占位符(如「客户A」「金额X」),推理完成后再还原。
- 走开源自部署:DeepSeek 的 V3 和 R1 权重与推理代码公开可下载,企业可在自有服务器本地运行,数据完全不出内网,这是绕开数据出境问题最彻底的做法。
- 分级使用:公开信息用云端 API,涉密内容只用本地部署的 deepseek ai 模型。
一句话,想用它的推理能力又怕数据风险,就把云端聊天版当草稿工具,把开源自部署当生产环境。
DeepSeek AI 有哪些局限性,使用时容易踩哪些坑?
DeepSeek AI 最大的三个坑是幻觉、知识时效滞后、部分话题受限。所谓幻觉(hallucination),就是模型把编造的内容当成事实说得头头是道。因此涉及数字、法律、医疗的关键信息,必须二次核查原始出处,绝不能直接拿去做合规决策。
幻觉和时效滞后具体表现在哪里?
幻觉常见于引用文献、编造 API 参数、虚构历史日期。你问一个不存在的函数,模型往往不会说「不知道」,而是替你「发明」一个用法。时效滞后指的是训练数据有截止日期,模型不知道之后发生的事。DeepSeek 官网在 2026 年主推的 V4.1-Flash 虽然增强了原生多模态视觉理解,但仍不能替代实时联网查证。
规避方法很直接:让模型「列出信息来源」,再自己点开验证。做代码时,别让它凭空造依赖,先给它真实的官方文档片段。
哪些场景绝对不该单靠 DeepSeek 决策?
| 使用场景 | 风险 | 建议做法 |
|---|---|---|
| 合同/法律条款审查 | 可能漏判关键条款 | 交由持证律师复核 |
| 医疗诊断建议 | 幻觉误导用药 | 仅作科普,就医为准 |
| 财务/税务数字 | 算错税率或金额 | 用官方计算器核对 |
| 敏感政治话题 | 部分内容受限 | 切换其他信源 |
成本低不代表可以偷懒。IBM 2025 年报道 R1 的使用成本比同级模型低约 96%,但省下的钱应投入到人工核查环节。deepseek 的建议是:把它当作高效的初稿助手,而非最终决策者。
总结与下一步行动建议
DeepSeek AI 的颠覆性在两点:模型权重、推理代码和技术文档全部公开,加上 R1 的使用成本据 IBM 2025 年报道比同级顶尖模型低约 96%。这意味着中小团队第一次能用近乎零的授权费,跑起过去只有大厂负担得起的推理级模型。
怎么选?先看预算和合规两条线。
- 预算紧、任务集中在数理与代码:直接用 DeepSeek 官方 API,按词元计费,无需自建 GPU。日常问答走 V3,多步推理走 R1。
- 数据不能出境、有合规红线:别用官方 App(数据默认存中国服务器)。改用开源权重,自行部署到本地或本国云,敏感数据全程不出内网。
- 要视觉理解或 Agent 任务:可评估官网已发布的 DeepSeek-V4.1-Flash,它带原生多模态视觉能力。
DeepSeek的实操建议是:
先小规模测试,再规模化。拿 100 条真实业务样本跑一轮,核对幻觉率和推理正确率,确认达标后再接入生产。涉及数字、法律、医疗的输出,务必二次核查原始出处,绝不能直接拿deepseek ai的答案做合规决策。先验证,后放量,这一步省下的返工成本,远比省下的 API 费用值钱。