DeepSeek AI 不只会聊天,推理机制和应用边界一并讲清
deepseek ai是中国深度求索公司开发的开源大语言模型,核心优势在于多步推理与超低成本。最新版 V4.1-Flash-1017 于 2026 年 10 月 17 日发布,官方称其项目开发能力更强、速度更快、价格更低。其 V3 模型采用 MoE 混合专家架构,总参数达 671B 但每次仅激活约 37B,训练成本压低至 557 万美元,远低于同级闭源模型。
核心要点
- V4.1-Flash-1017于2026年10月发布,开发提速且价格更低
- MoE架构671B总参仅激活37B,训练成本压到557万美元
- 日常问答选V4.1-Flash,复杂代码数学推理才上V4-Pro
- 开源权重可本地部署,数据不出内网降低调用成本
- 长文档、数学、代码是强项,实时联网搜索是短板
关键速览
- V4.1-Flash-1017 于 2026 年 10 月发布,主打低成本与开发提速。
- 推理模型靠”思维链”分步计算,不是一次性输出答案。
- DeepSeek 以开源权重著称,开发者可本地部署降低调用成本。
- 长文档、数学、代码任务是它的强项,实时联网搜索是短板。
- 选型看三点:响应速度、调用价格、是否需要深度推理。
DeepSeek AI 是什么?和普通聊天机器人有什么区别?
DeepSeek AI 是成立于 2023 年、位于中国杭州的深度求索公司开发的开源大语言模型(LLM,即能理解和生成文字的 AI 系统)。
它与普通聊天机器人的核心差异有三点:
开放权重(open-weight,模型参数可免费下载自行部署)、超低推理成本、原生中文优化。普通聊天机器人多为封闭接口,只能联网调用;DeepSeek 把模型权重公开,企业可本地化运行,数据不出内网。这意味着你既能像用聊天工具一样对话,也能把整个模型搬到自己的服务器上跑。
截至 2026 年,官网把主力模型分为DeepSeek-V4-Pro(高难度推理与编程)和 V4.1-Flash(快速日常使用)两档,按任务挑速度或精度。深度求索的建议很直接:日常问答选 Flash,复杂代码或数学推理才上 Pro。
DeepSeek 的模型原理是怎么工作的?
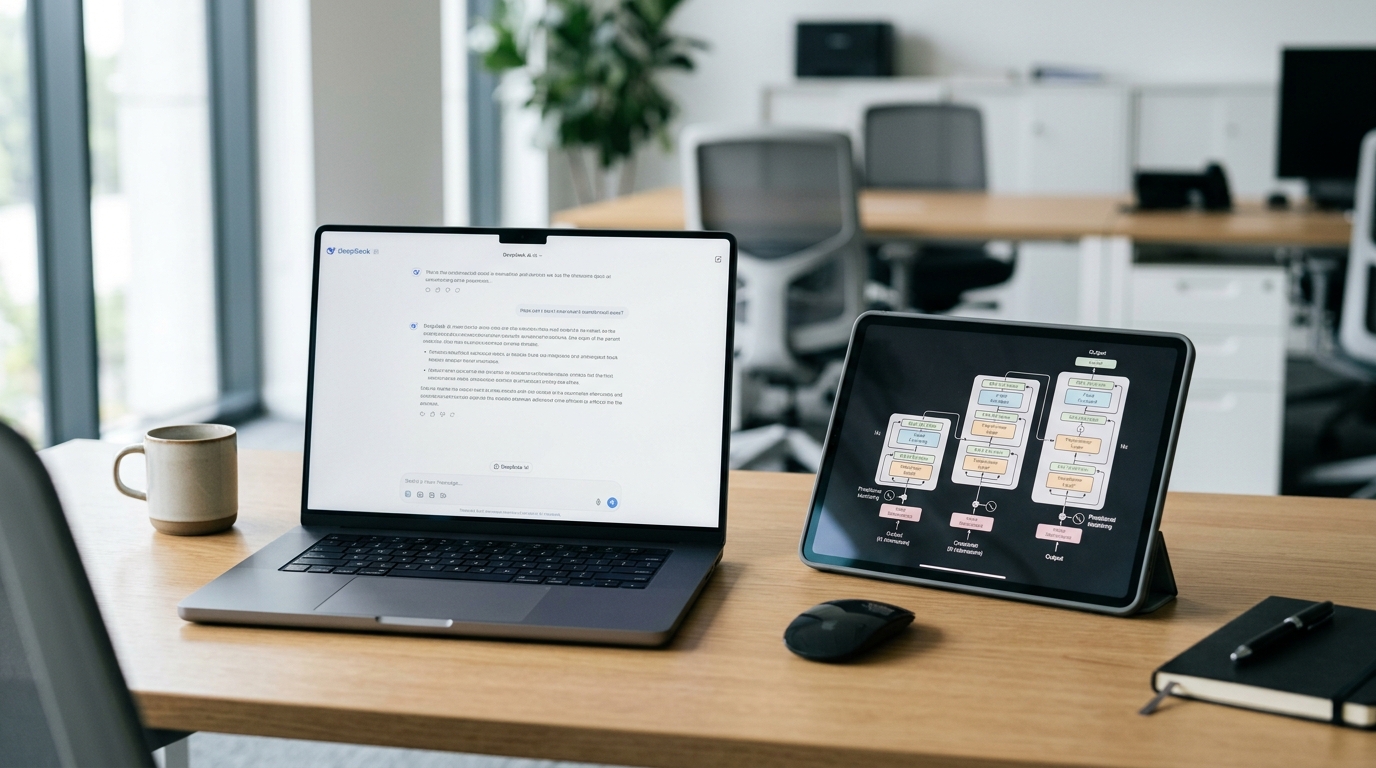
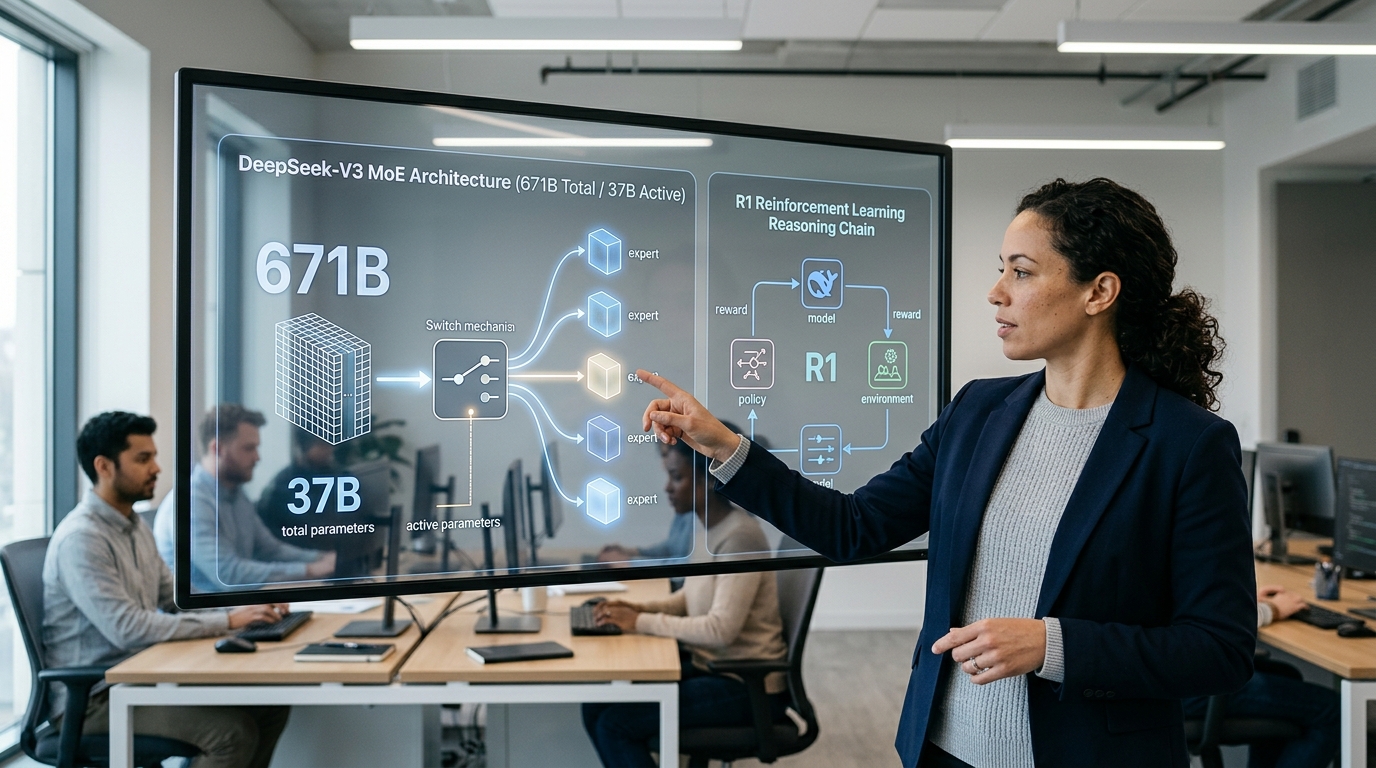
DeepSeek 的核心原理是 MoE 混合专家架构(Mixture of Experts,即把模型拆成许多”专家”子网络,每次只调用其中一部分)。以 V3 为例,总参数达 671B,但每个词只激活约 37B 参数,推理时只跑整个模型的 约 5.5%,算力省下大半,效果却逼近顶尖模型。
这正是训练成本能压到 557 万美元的关键
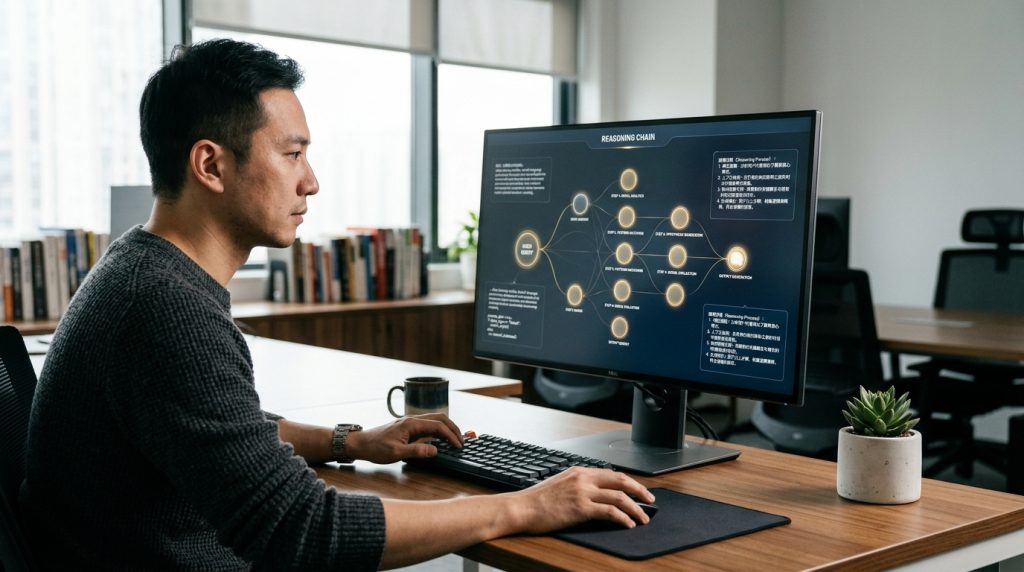
R1 在此基础上加了强化学习(reinforcement learning,让模型通过奖惩反复试错)来训练推理链:模型会先在内部”写草稿”推演步骤,再给出答案。深度求索是一家成立于 2023 年的中国 AI 实验室,以 open-weight 开源模型闻名,MoE 加强化学习这套组合正是它低成本高性能的底层逻辑。
DeepSeek-V3 和 DeepSeek-R1 有什么区别?该用哪个?
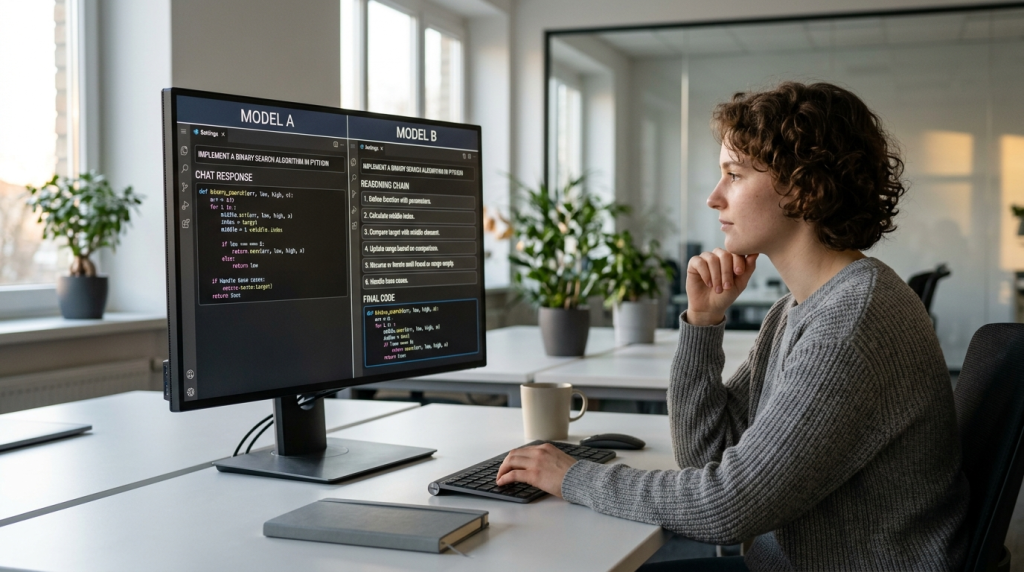
一句话决策:日常问答、翻译、写文案选 V3,速度快;数学题、编程调试、多步逻辑推理选 R1,它会把思考过程一步步写出来给你看。2025 年 1 月 DeepSeek 官方发布的 R1,正是靠这种”显式推理”(chain-of-thought,即链式思维)与 V3 拉开差距,代价是先推理后输出,响应更慢。
| 维度 | DeepSeek-V3 | DeepSeek-R1 |
|---|---|---|
| 擅长任务 | 对话、翻译 | 数学、编程、逻辑 |
| 响应速度 | 快 | 慢(先推理) |
| 是否显示思考 | 否 | 是 |
实操建议:拿不准时先用 V3,答案不对再换 R1。到 2026 年,这两条线已演进为 V4.1-Flash(快速日常)和 V4-Pro(高难推理),选型逻辑不变。
DeepSeek 和 ChatGPT、Claude、通义千问哪个更好?
没有绝对的赢家,看任务选,四款模型各有主场。中文写作和性价比上 DeepSeek AI 领先;代码生成 Claude 最稳;多模态(能处理图片、语音)和插件生态ChatGPT最全;企业级中文客服集成通义千问更顺手。DeepSeek 的 open-weight(权重可下载)模型,官方 2026 年主力是 V4-Pro 和 V4.1-Flash,后者主打低成本、快速。
⚠️ 常见错误:把日常问答也丢给 V4-Pro(R1)处理。原因:Pro/R1 先走”思维链”分步推演再输出,响应慢且按推理 token 计费,成本更高。修复:对话、翻译、写文案用 V4.1-Flash,只有数学、代码调试、多步逻辑才切 Pro。
| 任务 | 最优选择 | DeepSeek 表现 |
|---|---|---|
| 中文写作 | DeepSeek | 语感自然、用词地道 |
| 代码生成 | Claude | 接近,调试略弱 |
| 多模态 | ChatGPT | 暂不支持图像输入 |
两条分界线很清楚:想省钱又主做中文,选 DeepSeek;要图文混合处理,选 ChatGPT。
DeepSeek AI 能做什么?写作、编程、分析实战场景
DeepSeek AI 最实用的四类用途是:中文文案润色、代码调试补全、数据分析和长文档总结。2026 年 10 月更新的 V4.1-Flash-1017 版本专门提升了项目开发能力,速度更快、成本更低。下面各配一个具体示例,帮你判断它能否满足需求。
- 中文文案润色:输入一段生硬的产品介绍,它能改出口语化版本,并标出被动句改主动句的位置。
- 代码调试补全:贴入报错的 Python 函数,R1 会逐行推理定位 bug,给出修正代码加注释。
- 数据分析:粘贴一张销售数据表,它能算出环比增长率并指出异常月份。
- 长文档总结:扔进一份 2 万字合同,输出关键条款清单和风险点摘要。
DeepSeek 的 API 怎么接入?调用成本和本地部署怎么选?
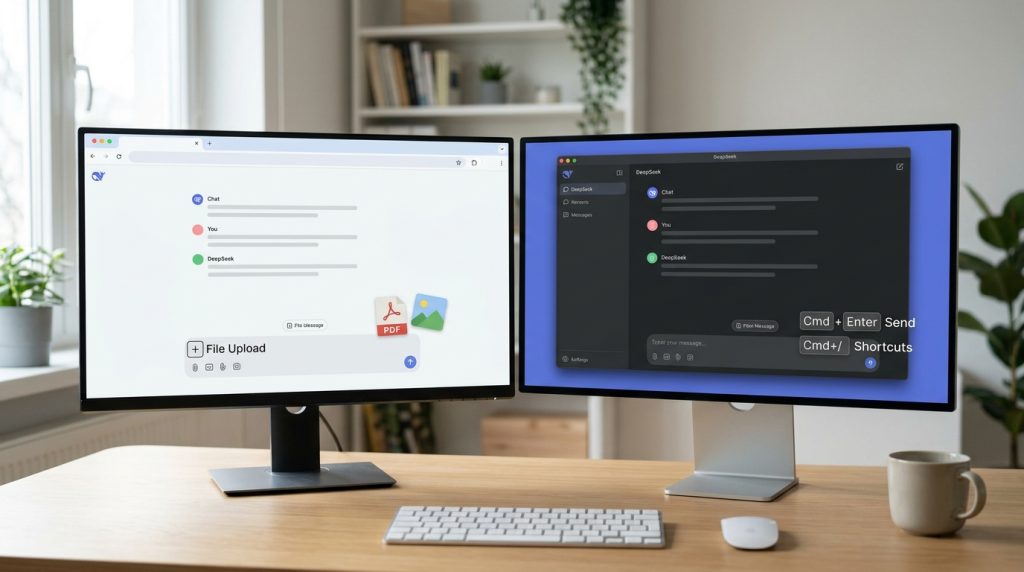
三种接入方式,选哪种看规模:个人用网页端,零门槛;开发者接 API,按量付费;企业追求数据不出门就本地部署。DeepSeek 官方在 2026 年还开放了网页搜索与抓取 API供开发者测试,让模型能联网取数。
本地部署的分水岭在显存
蒸馏版 7B 模型约需 16GB 显存(一张消费级显卡即可),而满血 671B 模型需多卡集群,硬件门槛在数十万元,团队没有专职运维就别碰,直接用 API 更划算。
DeepSeek 的数据隐私和企业使用风险你需要知道什么?
用云端 API 时,数据会传到中国杭州的服务器。据美国国会研究服务处 2026 年材料,DeepSeek 是一家位于中国杭州的 AI 初创公司,这意味着云端数据受中国数据法规管辖。企业上传敏感信息前,必须先过合规这一关。
企业落地前查三点:
一、客户个人信息、商业机密走本地部署(模型跑在自己服务器,数据不出门),不走云端 API;二、公开资料、营销文案这类非敏感内容,用云端 API 省成本;三、签合同前确认数据留存政策和跨境传输是否符合你所在地法律,比如欧盟 GDPR 对数据出境有硬性要求。open-weight 模型的好处正在这里,你能完全离线运行,隐私风险归零。
总结:谁最适合用 DeepSeek AI?
三类人该优先用 DeepSeek AI:预算有限的开发者、中文内容创作者、重视推理过程的研究者。有多模态或海外数据合规硬需求的团队,则需评估替代方案。原因很直接,DeepSeek 的 open-weight 模型可免费下载自部署,云端 API 又比主流闭源模型便宜一截。
按需求对号入座:
- 预算有限的开发者:选 open-weight 版本本地跑,省掉按量付费。参考前文,蒸馏版 7B 模型在 16GB 显存的消费级显卡上就能起步。
- 中文创作者:中文润色和长文总结是 DeepSeek 的强项,日常用 V4.1-Flash 速度足够。
- 推理型研究者:需要显式思维链的数学、代码调试任务,上 V4-Pro。
- 需多模态 / 海外合规的团队:云端 API 数据传往中国杭州服务器,敏感数据先过合规审查,或考虑其他模型。
上手第一步很简单:
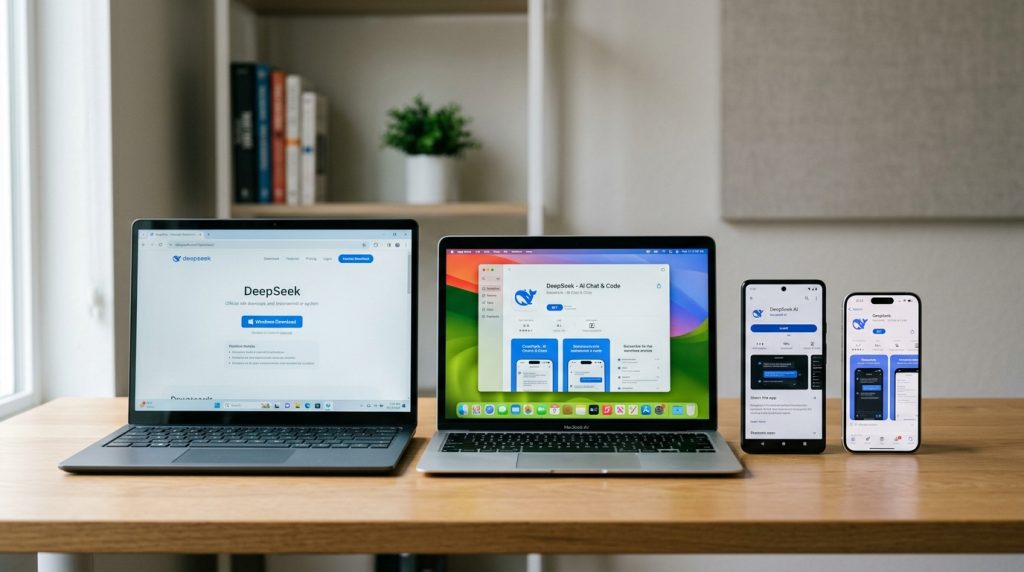
打开网页端免费试一个真实任务,满意再接 API。2026 年 10 月 17 日更新的 V4.1-Flash-1017 已提升项目开发能力,成本与速度都更友好,正适合从零试起。