DeepSeek 不只是聊天工具:模型、API 与开源边界
deepseek是一家中国人工智能公司,由杭州深度求索开发,主打开源权重的大语言模型,模型文件可免费下载并本地部署。其核心产品分三类:聊天应用、按 token 计费的 API,以及开源模型,API 价格比多数闭源大模型便宜数倍。两条主线中,6710 亿参数的 V3 擅长通用对话,R1 则专注数学、代码与多步推理;2025 年 1 月 20 日 R1 发布后,一周内冲上国际热榜,正面撼动了 OpenAI 等闭源产品的格局。
核心要点
- 开源权重可免费下载本地部署,区别于GPT-4闭源模型
- 三层概念别混淆:公司实验室、聊天App、底层大模型
- API按token计费,成本比多数闭源大模型低数倍
- 通用对话写作选V3,数理编程推理任务选R1
- R1回答慢且输出思考链,别用于高并发客服场景
关键速览
- DeepSeek 主打开源权重 LLM,模型权重可公开下载自行部署
- 核心产品分三类:聊天应用、API 接口、可本地运行的开源模型
- API 按 token 计费,比多数闭源大模型便宜数倍
- 开源的是模型权重,训练数据和完整训练代码并未全部公开
- V3 与 R1 是两条主线:前者通用对话,后者侧重推理
DeepSeek 是什么?公司、产品和模型三者如何区分
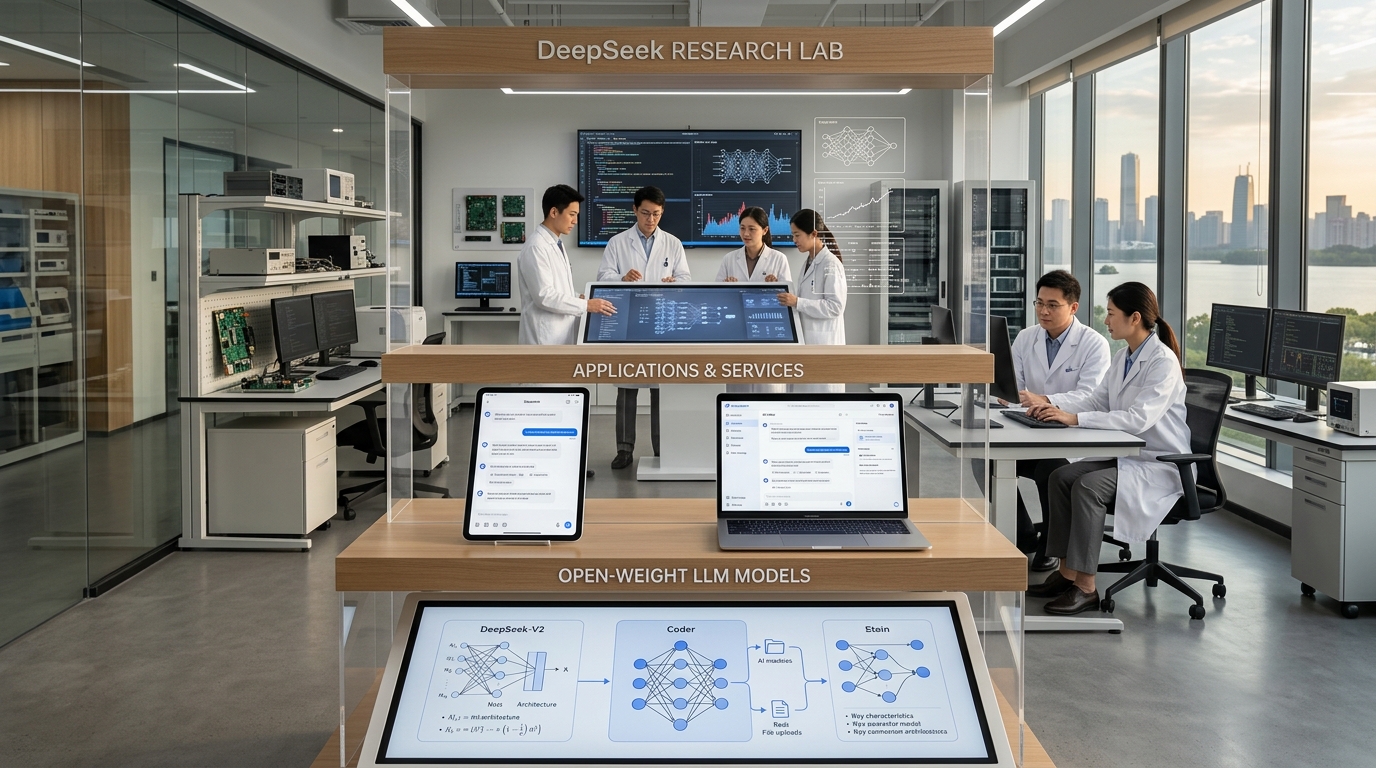
DeepSeek 其实是三个东西,别混为一谈:它既是公司,也是你用的 App,还是底层模型。官方注册名为杭州深度求索人工智能基础技术研究有限公司,总部在杭州,由对冲基金High-Flyer出资,梁文锋创立,2023 年起步时只是量化基金的一个副项目。
三层含义具体是:
- 公司(实验室):开发开源权重大模型的中国 AI 团队,背靠量化基金资金。
- 产品:网页端和手机 App 的聊天机器人,普通用户直接对话用。
- 模型:底层大语言模型,如 6710 亿参数的 DeepSeek-V3 和推理模型 R1。
它为何被称作挑战 OpenAI 的开源力量?
关键在”开源权重”,模型文件可免费下载、本地部署,而 OpenAI 的 GPT-4 是闭源的。2025 年 1 月 20 日 R1 发布后,DeepSeek 一周内冲上国际热榜,用免费可下载的开源路线正面撼动了闭源霸主的格局。
DeepSeek V3、R1 和后续模型分别适合什么场景
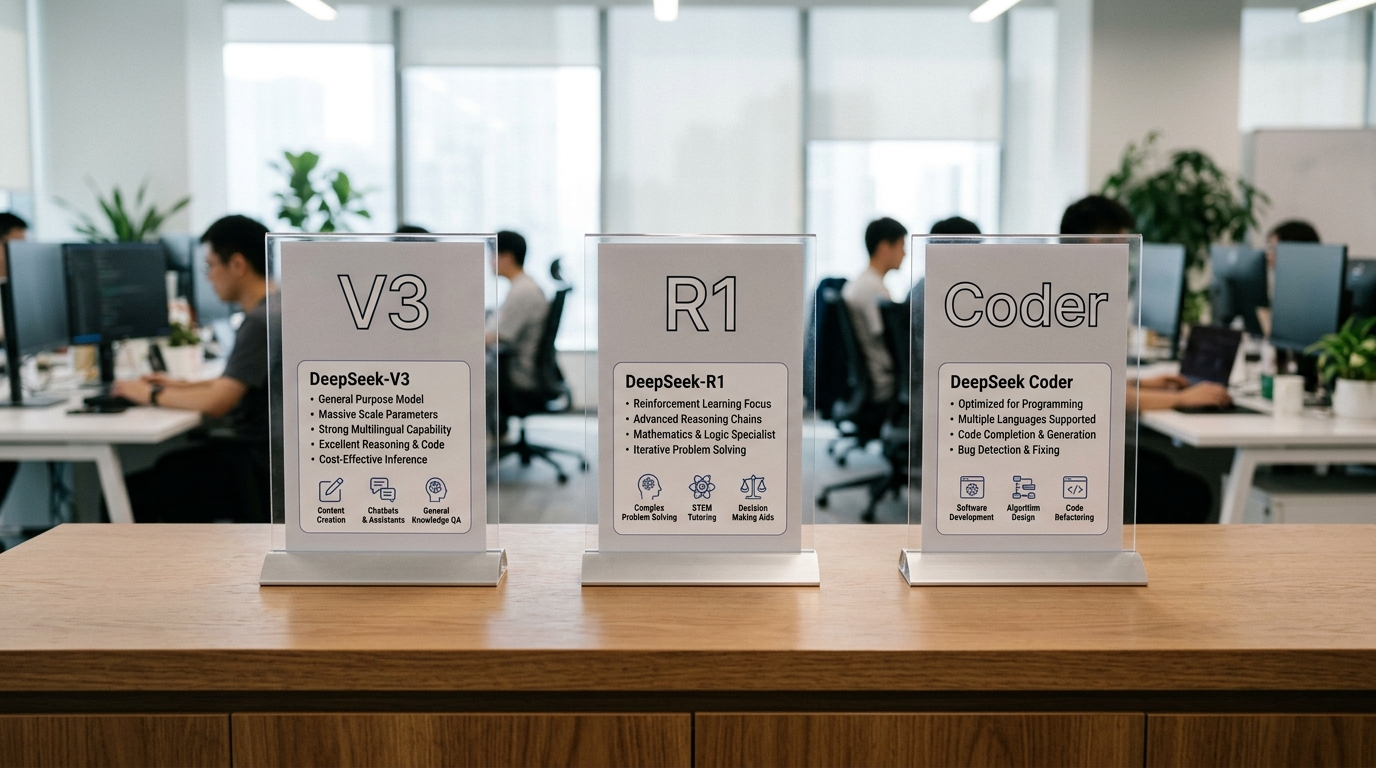
选型看一条规则:要快、要便宜、要通用,选 V3;要推理、要数理、要编程,选 R1。据 IBM 的介绍,R1 是在 6710 亿参数的混合专家模型 V3 基础上微调而成的推理模型,它继承了 V3 的底子,再专门训练它”想清楚再回答”。
| 模型 | 擅长任务 | 典型用法 |
|---|---|---|
| DeepSeek-V3 | 通用对话、写作、翻译 | 客服、内容草稿、批量文案 |
| DeepSeek-R1 | 数学、代码、多步推理 | 算法题、调试、逻辑分析 |
| DeepSeek-Coder | 代码生成与补全 | IDE 插件、代码审查 |
实操上要注意速度差异:
R1 回答慢且会输出完整思考过程,别拿它做高并发客服;写邮件、改文案用 V3,每千 token 成本更低。R1 自 2025 年 1 月 20 日发布后,正是靠这条推理主线成为 DeepSeek 走红的关键。
DeepSeek 的 MoE 与推理训练机制是怎么工作的
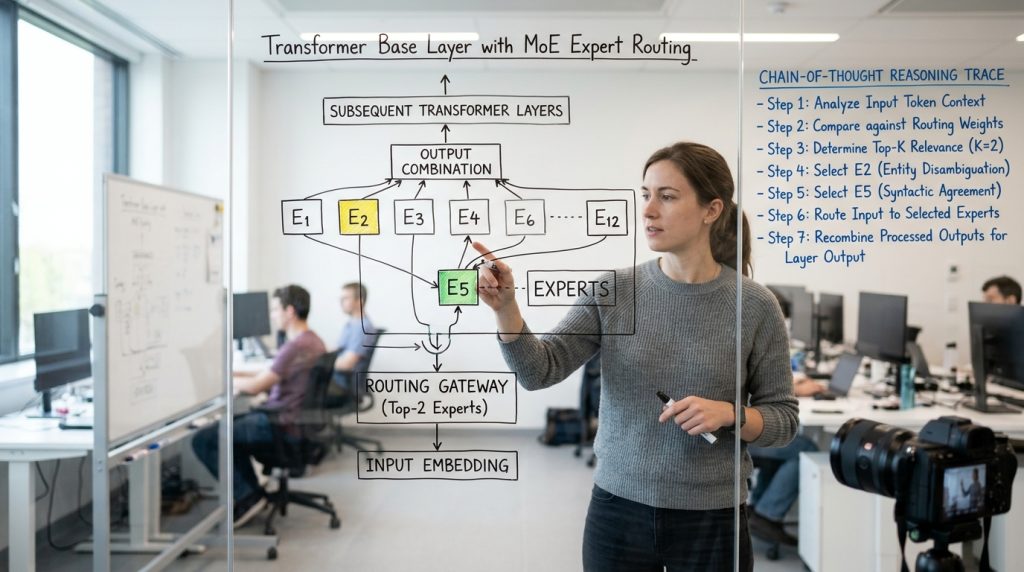
DeepSeek 省算力的秘密在两点:混合专家(MoE)只唤醒部分参数,强化学习让模型自己练出推理链。IBM 指出,V3 虽有 6710 亿参数,但每次推理只激活一小部分”专家”,而非全量计算,同等效果下算力成本因此大幅降低。
MoE 像一个会分诊的医院:
模型里有很多专家子网络,一个”路由器”根据输入内容只挑几个相关专家干活,其余休眠。参数总量大,但实际运算量小,这正是 DeepSeek 能用更低预算逼近顶级模型的根本原因。
推理链则不是靠分诊得来,而靠强化学习训出来
R1 答题后,系统用奖励信号鼓励它”先想步骤再给答案”,逐渐学会拉长推理链。这套方法不依赖海量人工标注,省钱又有效,也解释了为什么 R1 在数理题上明显强于只做通用对话的 V3。
DeepSeek 对比 GPT-4 和 Claude 哪个更好
没有绝对赢家,取决于你花多少钱、做什么任务。DeepSeek 的核心优势是成本:它是开源权重模型,自部署几乎零 API 费用,同样任务量下比闭源的 GPT-4、Claude 便宜一大截;短板在复杂写作的文笔润色和超长文本连贯性上,仍落后 Claude。下表把三者按主要维度摆在一起:
⚠️ 常见错误:把 R1 用于高并发在线客服。原因 R1 会输出完整思考链,回答慢且每次响应 token 更多,既拖延迟又抬高成本。修复:客服、文案等通用场景改用 V3,R1 只留给数理、编程等多步推理任务。
| 维度 | DeepSeek R1 | GPT-4 | Claude |
|---|---|---|---|
| 数学推理 | 强(R1 专练推理链) | 强 | 中上 |
| 编程 | 强 | 强 | 强 |
| 长文本连贯 | 中 | 中上 | 最强 |
| 成本 | 最低(可自部署) | 高 | 高 |
据此选型:预算敏感、重数理和代码,选 DeepSeek;要稳定的长文润色和连贯性,选 Claude。
DeepSeek 能做什么?写作、编程、分析与检索实战
DeepSeek 在四类任务中表现分化:代码辅助最强,数据分析和知识检索次之,长篇写作润色最弱。专门的 DeepSeek-Coder 自 2023 年 11 月起持续迭代,聚焦数学与编码,这是它写代码靠谱的根本原因。按任务分工:编程和算数用 R1,批量生成文案用 V3 省钱。
- 编程:R1 生成的函数可直接跑,但复杂项目需人工核对边界条件。
- 数据分析:能写 SQL 和 pandas 脚本,大表易漏字段,要给它列明表结构。
- 知识检索:无联网时会编造引用,常见踩坑是把虚构论文说得很真。
- 写作:中文结构清晰,中译英文笔偏生硬。
海外企业用 DeepSeek 有哪些数据隐私与合规风险
核心风险在数据存放在哪:用官方 API,提示词会传到中国境内服务器处理。DeepSeek 总部位于杭州(2026),受当地数据法规管辖。这对受 GDPR 或 HIPAA 约束的欧美企业是硬门槛,跨境传输个人数据需单独的合规评估。
因此要分场景处理
公开资料、营销草稿、无个人信息的代码片段,走 API 省事又便宜;涉及客户身份、病历、财务记录或源代码核心逻辑的,必须本地部署开源权重模型,让数据根本不出内网。DeepSeek 开放权重的意义正在于此:它本就是为自托管而存在。
怎么接入 DeepSeek?API 调用、本地部署与成本估算
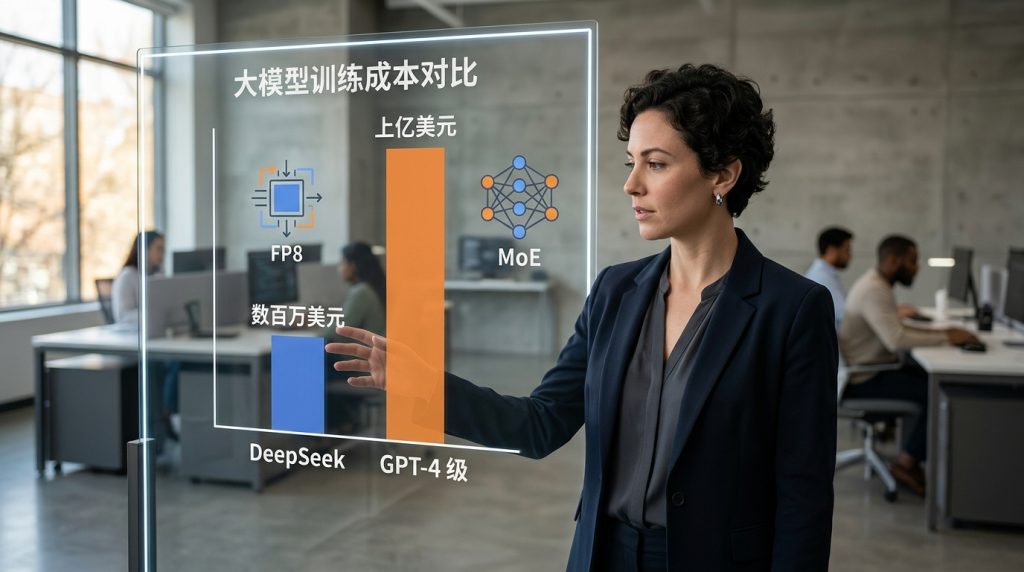
两条路:官方 API 几分钟开通,自托管则需多卡 GPU。DeepSeek 是开源权重模型(2026),所以你能下载 6710 亿参数的 V3 权重自己跑,但满血版需约 8 张高端 GPU,门槛极高。小团队直接用 API,省心又便宜。
API 怎么调?成本大概多少?
注册拿 Key,接口兼容 OpenAI 格式,改个 base_url 就能跑。假设每月处理 1 亿输入 token、2000 万输出 token,按低价档估算,月费通常在几十美元级别,远低于自建一台多卡服务器的电费与折旧。数据敏感、量又不大,就选 API;要让数据不出境、调用量又极大,才值得承担自托管的硬件成本。
总结与下一步行动建议
一句话定位:DeepSeek 是一家开发开源权重大语言模型的中国公司(2026),它既是公司、App,也是模型。能否用、怎么起步,分两类人看。
非技术决策者:
先用网页版免费试 3 天,验证中文写作和编程两类任务是否够用。涉及 GDPR 或客户个人数据,别碰官方 API,提示词会传到杭州境内服务器,跨境合规评估绕不开。
开发者:
小团队直接调官方 API,通用任务选 V3,推理数理选 R1;要数据不出境,就自托管 671B 权重(需约 8 张高端 GPU)。先跑通一个真实场景,再决定是否扩容。