DeepSeek AI 不只是聊天工具,架构与能力边界详解
DeepSeek AI 是中国深度求索公司开发的开源大语言模型系统,由梁文锋于 2023 年 12 月在杭州创立,覆盖对话、推理、代码与视觉理解等多条产品线。2026 年 10 月发布的 DeepSeek-V4.1-Flash 支持原生多模态视觉理解,可直接看图。据 IBM 2025 年报道,DeepSeek-R1 在部分数学和编程基准上可与 OpenAI o1 相当,但使用成本约低 约 96%。
核心要点
- DeepSeek 是开源权重模型,可私有化部署,数据不出企业内网
- V4.1-Flash 2026年10月发布,原生多模态可直接看图
- MoE架构每次仅激活约370亿参数,推理成本大幅降低
- 据IBM报道,R1性能接近o1但使用成本低约96%
- 强项是数学、代码与中文长文本,联网和超长上下文仍有限
关键速览
- DeepSeek-V4.1-Flash 于 2026 年 10 月发布,支持原生多模态视觉理解
- 核心架构采用 MoE(混合专家),推理时只激活部分参数以降成本
- DeepSeek 不止一个模型:含对话、推理、代码、视觉等多条产品线
- Agent 能力让它可调用工具、分步执行任务,而非单轮问答
- 强项是数学、代码与中文长文本;实时联网和超长上下文仍有边界
DeepSeek AI 到底是什么?
DeepSeek AI 是中国深度求索公司开发的开源大语言模型。它由梁文锋在 2023 年 12 月创立,总部设在杭州。它有两副面孔:一个免费的聊天产品,和一套可下载的开放权重(open-weight,即模型参数公开供人下载运行)模型。所以你既能像用聊天机器人一样问它问题,也能把模型搬到自己的服务器上跑。
很多人误以为 DeepSeek 只是又一个聊天框,这是最大的误解
它的 V3 和 R1 模型公开了模型权重、推理代码和技术文档,任何开发者都能自行部署、微调。这意味着企业可以把模型装进内网,数据不出公司。单纯的聊天机器人做不到这一点。
低成本是它的另一张名片
据 IBM 2025 年的报道,DeepSeek-R1 在部分数学和编程基准上可与 OpenAI 的 o1 相当,而公司称其使用成本约低 约 96%。对要大批量调用 API 的团队,这直接改写了账单。
DeepSeek 把官网定位为模型发布平台。到 2026 年 10 月,它在首页推出了 DeepSeek-V4.1-Flash,官方称其文本与 Agent 性能提升,并支持原生多模态视觉理解,能直接看图,不只是读文字。
DeepSeek 的模型架构为何能低成本做出高性能?
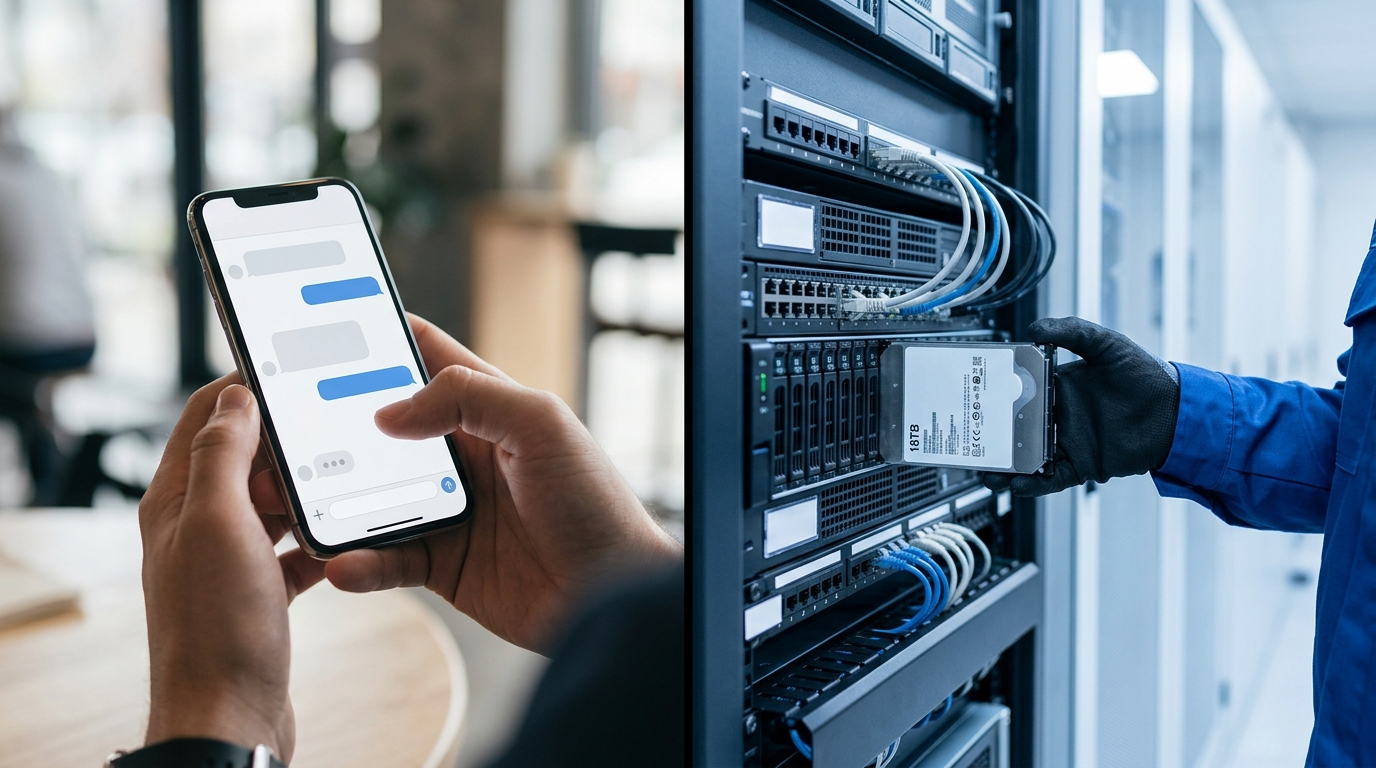
靠三个技术省钱:MoE 混合专家、MLA 多头潜在注意力和 FP8 低精度训练。DeepSeek-V3 在 2024 年 12 月发布,据 IBM 2025 年的报道,其后续的 R1 使用成本比 OpenAI o1 低约 96%。省钱不靠砍质量,而靠少算无用的部分。
先说 MoE(Mixture of Experts,混合专家)
模型里藏着很多个”专家”小网络,但每次回答只唤醒其中少数几个。V3 总参数 6710 亿,可每个词实际只激活约 370 亿。你付的算力只够用在真正需要的专家上,闲着的不花钱。
再看 MLA(Multi-head Latent Attention,多头潜在注意力)
它把注意力的记忆缓存(KV cache)压成一个低维向量,显存占用大幅缩小。推理时省显存,意味着同一张显卡能服务更多用户,单次对话成本就降下来了。
- FP8 训练:用 8 位浮点数代替常见的 16 位,内存和带宽需求减半,是 V3 控制成本的关键一环
- 开放权重:据 美国国会研究处材料,DeepSeek 公开了 V3、R1 的权重与推理代码,省去你自研底座的成本
DeepSeek AI 把这几项叠加,才能做到高性能的同时压低账单。想自己部署时,MLA 的省显存特性尤其值得关注,它直接决定你需要几张卡。
R1、V3 和最新模型应该怎么区分?
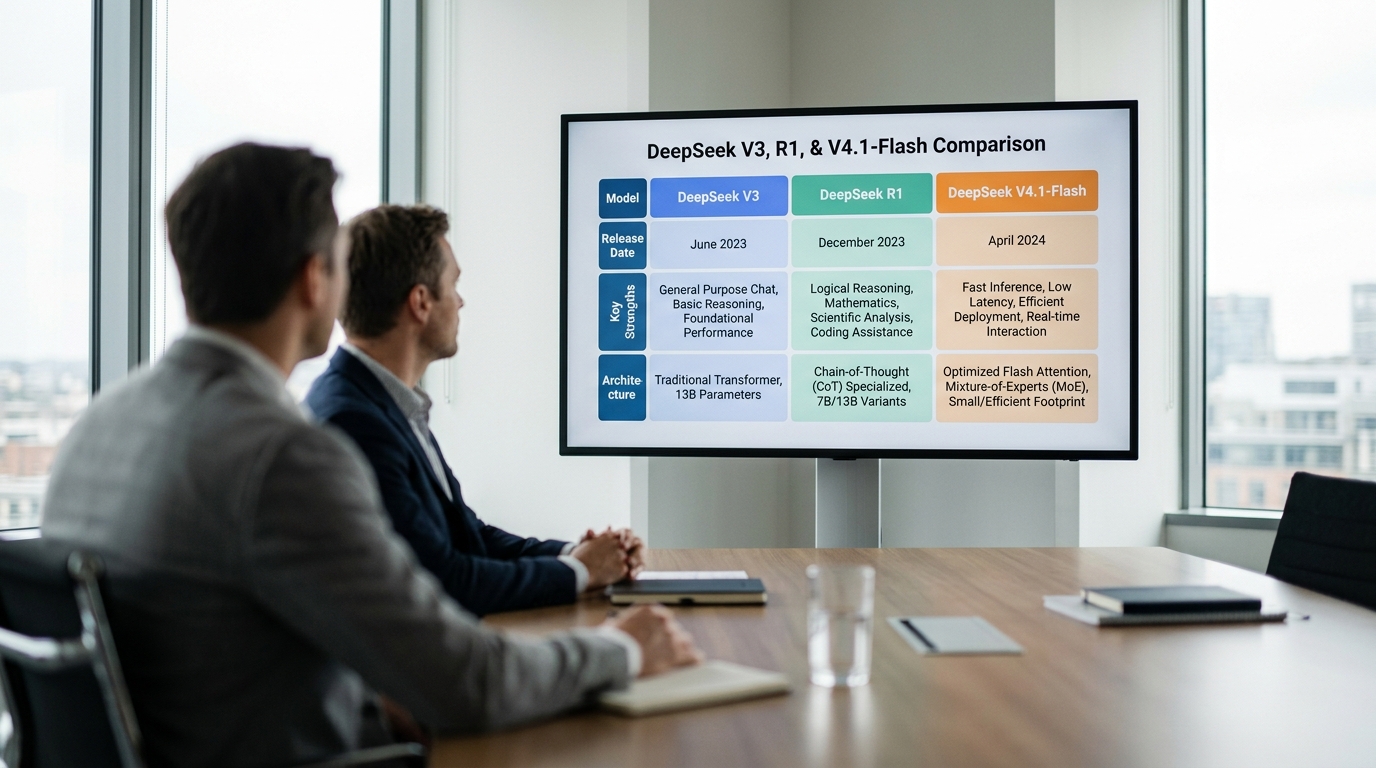
简单说:V3 是通用对话主力,R1 是会”想一步再答”的推理模型,V4.1-Flash 则是 2026 年的最新多模态版本。选哪个看任务,写邮件、整理文档用 V3;解数学题、调代码、做逻辑推演用 R1。据 IBM 2025 年的报道,R1 在部分数学和编程基准上与 OpenAI o1 相当,成本却约低 约 96%。
两者差在”思维链”(chain-of-thought,即模型把推理步骤一步步写出来再给结论)。V3 直接吐答案,快;R1 会先在内部”打草稿”,慢但准。Britannica 2025 年的条目记载,V3 于 2024 年 12 月发布,R1 于 2025 年 1 月推出。
| 版本 | 发布时间 | 擅长任务 | 特点 |
|---|---|---|---|
| DeepSeek-V3 | 2024年12月 | 对话、办公、中文写作 | 响应快,无思维链 |
| DeepSeek-R1 | 2025年1月 | 数学、编程、逻辑推理 | 带思维链,答案更准 |
| V4.1-Flash | 2026年10月 | 图文理解、Agent 任务 | 原生多模态视觉 |
deepseek 的建议很直接:批量日常任务别开 R1,它多花的推理时间是浪费。遇到要图片理解或自动化工作流,再上 2026 年 10 月发布的 V4.1-Flash,官方称其文本与 Agent 性能全面提升。
DeepSeek 和 ChatGPT、Gemini、Claude 哪个更好?
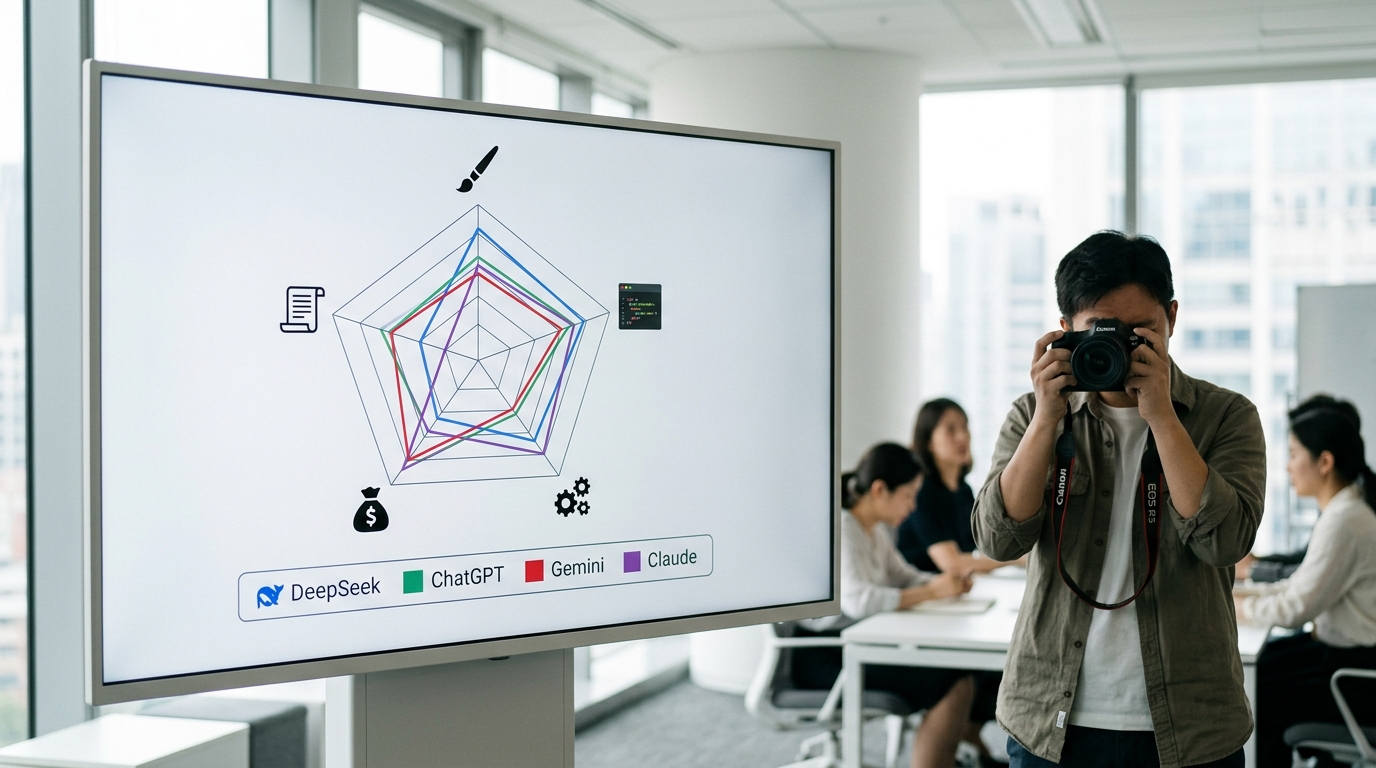
没有单一赢家。选哪个取决于你的任务:要省钱做推理选 DeepSeek,要稳定代码与超长文档选 Claude,要生态整合选 ChatGPT 或 Gemini。据 IBM 2025 年的报道,DeepSeek-R1 的使用成本比 OpenAI o1 约低 约 96%,这让它在高频调用场景里最划算。
⚠️ 常见错误:写邮件、整理文档却默认调用 R1 推理模型。原因 R1 会先生成”思维链”逐步打草稿,响应更慢且多耗 token,简单任务上性价比反而更低。修复:日常对话用 V3,只在数学、代码、逻辑推演时才切到 R1。
下面这张表列出四款模型在关键维度上的可声明情况,供你按需挑选:
| 模型 | 中文能力 | 开放权重 | 最适合谁 |
|---|---|---|---|
| DeepSeek-R1 / V4.1-Flash | 强(原生中文语料训练) | 是(V3、R1 权重公开) | 预算有限、需要本地部署的团队 |
| ChatGPT(GPT 系列) | 强 | 否 | 需要插件生态和图像生成的用户 |
| Gemini | 中等 | 否 | 重度使用 Google 办公套件的人 |
| Claude | 中等 | 否 | 处理长文档、要代码稳定的开发者 |
DeepSeek 的独家优势是「开放权重」,你能下载模型参数,装在自己的服务器上运行,数据不出本地。这是其他三家闭源模型给不了的。但它的短板也明显:图像生成、语音对话这类多模态功能起步晚,直到 2026 年 10 月发布的 DeepSeek-V4.1-Flash 才补上原生视觉理解。想要成熟的画图或插件生态,ChatGPT 仍更顺手。
从 deepseek ai 的定位看,它主打「同等推理水平、更低成本」。若你每月要跑几百万次 API 调用,省下的 96% 费用就是实打实的预算。
DeepSeek AI 能用在哪些中文、编程和办公场景?
DeepSeek AI 在中文长文写作、代码调试、数据整理和 API 集成这四类任务上都能上手,其中中文理解和推理类编程是强项。据 IBM 2025 年的报道,DeepSeek-R1 在部分数学和编程基准上可与 OpenAI o1 相当,使用成本却约低 96%。所以预算有限又要跑推理任务,它很合适。
中文写作和办公整理它做得怎么样?
写中文长文用 V3 最顺。它对成语、公文腔、政策术语的拿捏比多数海外模型自然,适合写工作总结、产品文案、调研报告。办公场景里,把一段杂乱的会议记录丢给它,让它输出”决议/负责人/截止日”三列表格,它能一次整理清楚,省下手动归类的十几分钟。
编程和 API 集成适合哪类任务?
调代码优先用 R1,因为它会”先想一步再答”,定位空指针、递归逻辑错误比直接吐答案的模型准。API 集成方面,DeepSeek 开放了模型权重和推理代码,开发者能自己部署,不必受外部服务限流约束。2026 年 10 月发布的 DeepSeek-V4.1-Flash 还加了原生多模态视觉理解,能读截图里的报错信息。
哪些场景它仍不如竞品?
超长代码仓库的跨文件重构,它的上下文稳定性不如 Claude。生态插件和第三方工具链整合,也比 ChatGPT、Gemini 弱。要在团队协作里跑复杂工作流,先掂量这些短板。
DeepSeek 的数据存在哪里?为何多国限制使用?
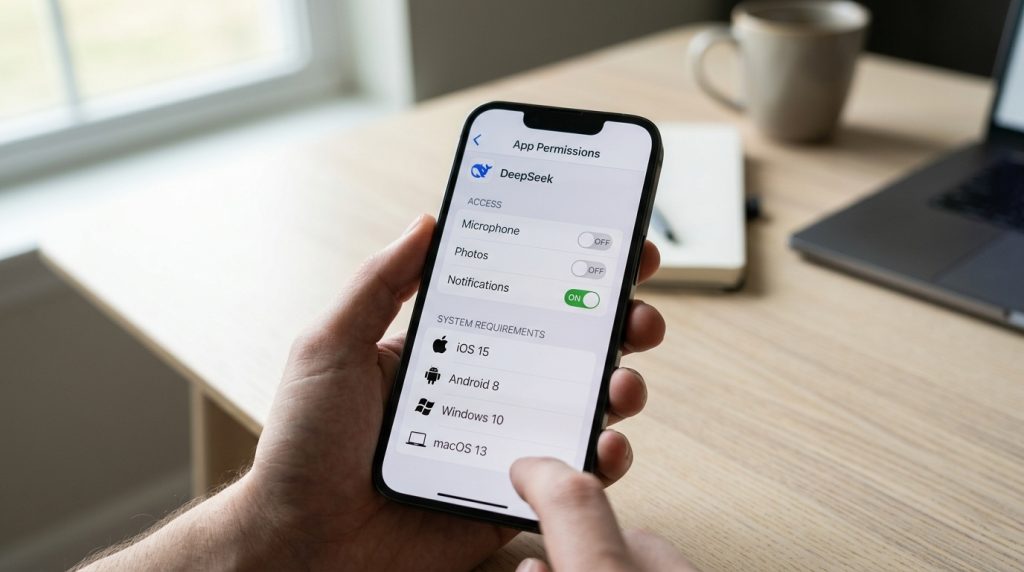
DeepSeek 官方 App 的用户数据存储在中国境内服务器,这是多国限制使用的核心原因。据美国国会研究处 2025 年材料,DeepSeek 2025 年 1 月上线的免费聊天应用引发了美国和国际的监管关注。关键区别在于:官方 App 会回传数据,而开放权重模型可本地运行、完全离线。
官方 App 和本地部署版有什么区别?
一句话:用官方 App 等于把对话送到中国服务器,用本地部署版则数据不出你的机器。DeepSeek 把 V3 和 R1 的模型权重、推理代码和技术文档都公开了,这意味着你可以下载模型,在自己的服务器或电脑上跑,不经过任何官方接口。
- 官方 App / 网页版:免费、省事,但输入内容走中国境内服务器——处理公司机密、客户信息时风险高。
- 本地开源部署:数据零外传,适合敏感场景;代价是需要显卡(R1 完整版需多张高端 GPU)和运维能力。
- 第三方托管的开源版:部署在你信任的云区域,折中方案——可控但仍依赖服务商。
敏感场景该怎么选?
处理医疗、法务、政府或企业核心数据时,直接跳过官方 App,用本地部署的开放权重版。普通个人问答、学习练习,官方免费版足够用。从 deepseek ai 的开源属性看,这正是它和闭源模型的关键差异:你有”把模型搬回家”的选项。
如何核验 DeepSeek 输出的事实、代码与引用?
核验 DeepSeek 输出要走三步:交叉验证事实、让模型自检逻辑、本地运行测试代码。任何大语言模型都会”幻觉”(hallucination,即模型编造看起来可信但其实错误的内容),哪怕 IBM 2025 年报道中说 DeepSeek-R1 在部分编程基准上可与 OpenAI o1 相当,也不代表它永远对。把它当草稿作者,不当最终裁判。
最常见的幻觉和错误代码长什么样?
事实类幻觉里,编造引用最危险。它会给出一个格式完整的论文标题、作者和年份,但这篇论文根本不存在。代码类错误则集中在三处:调用不存在的 API 方法、虚构库的参数名、以及边界条件漏判(比如空列表、除零)。这些错误看起来很专业,所以更容易骗过人。
三步核验清单具体怎么做?
- 交叉验证事实:把关键数字、人名、日期粘到搜索引擎或官方文档比对。引用类内容必须点开原链接确认存在,不存在就删。
- 让模型自检:追问”这段里哪些说法你没有把握?列出来并标注原因”。模型常会主动标出它编造的部分。
- 本地运行测试:代码不要只读,直接跑。写一个最小测试用例,喂空值和极端值,看会不会崩。
deepseek 的建议是:越重要的输出,核验越要前置。一段营销文案可以宽松,一份医疗或法律引用必须逐条查证。
总结与使用建议
deepseek ai的定位很清晰:一个运行成本低、开放权重的大语言模型家族,推理和中文任务是强项,数据合规是最大短板。据 IBM 2025 年的报道,R1 使用成本比 OpenAI o1 约低 96%,但官方 App 数据存中国境内这一点,决定了你能不能直接用它。
按身份对号入座,别一刀切:
- 普通用户:直接用免费网页版写中文、整理资料。别往输入框里贴身份证号、合同或公司机密——官方 App 会回传数据。
- 开发者:从 API 起步跑通流程,对数学和代码任务切到 R1。预算敏感或要数据不出门,就下载开放权重模型本地部署,自己掏硬件和电费。
- 企业:先过合规关。涉及客户数据或受监管行业,走私有化部署或可审计的第三方托管,绝不接官方 App。
下一步建议很直接:
想尝鲜就从官网最新的 DeepSeek-V4.1-Flash(2026 年 10 月发布,带原生多模态视觉理解)试一个真实任务,看它在你的场景下到底顶不顶用。记住:任何输出都要交叉验证,代码本地跑一遍再上线。deepseek ai省的是钱,不能省你的核验步骤。