DeepSeek AI 不只是一款聊天工具(能力边界详解)
DeepSeek AI 是中国杭州一家 2023 年成立的人工智能公司及其推出的开源大语言模型系列,由量化投资机构幻方量化孵化。它与 ChatGPT 最大的区别是模型权重开源可免费本地部署,且 API 调用成本显著更低。2025 年 1 月,其免费聊天应用一度登顶美国 Apple App Store 免费榜第一,V3 与 R1 模型更因性能接近美国顶级模型而被美国国会研究处点名关注。
核心要点
- DeepSeek 2023年成立于杭州,由幻方量化孵化推出开源大模型
- 模型权重开源可免费下载本地部署,敏感数据不出内网
- V3 适合写作问答,R1 擅长数学代码调试,按需选用
- R1 展示完整推理链路,准确率高但速度慢、token消耗大
- API 调用成本远低于同级闭源模型,适合规模化应用
关键速览
- DeepSeek 成立于 2023 年,总部位于中国杭州
- 模型采用开放权重,个人和企业可免费本地部署
- 覆盖聊天、代码生成、数学推理三大核心能力
- 推理型模型 R1 会展示完整思考步骤,可追溯答案逻辑
- API 调用成本显著低于同级闭源模型,适合规模化应用
DeepSeek AI 是什么?它和 ChatGPT 有什么不同?
DeepSeek AI 是中国杭州一家2023 年成立的人工智能公司及其推出的大语言模型系列,由量化投资机构幻方量化孵化。它与 ChatGPT 最大的不同有两点:模型权重开源(任何人可下载部署),以及使用成本极低。它适合预算有限的开发者、需要本地私有部署的企业,以及想研究模型内部的技术团队。
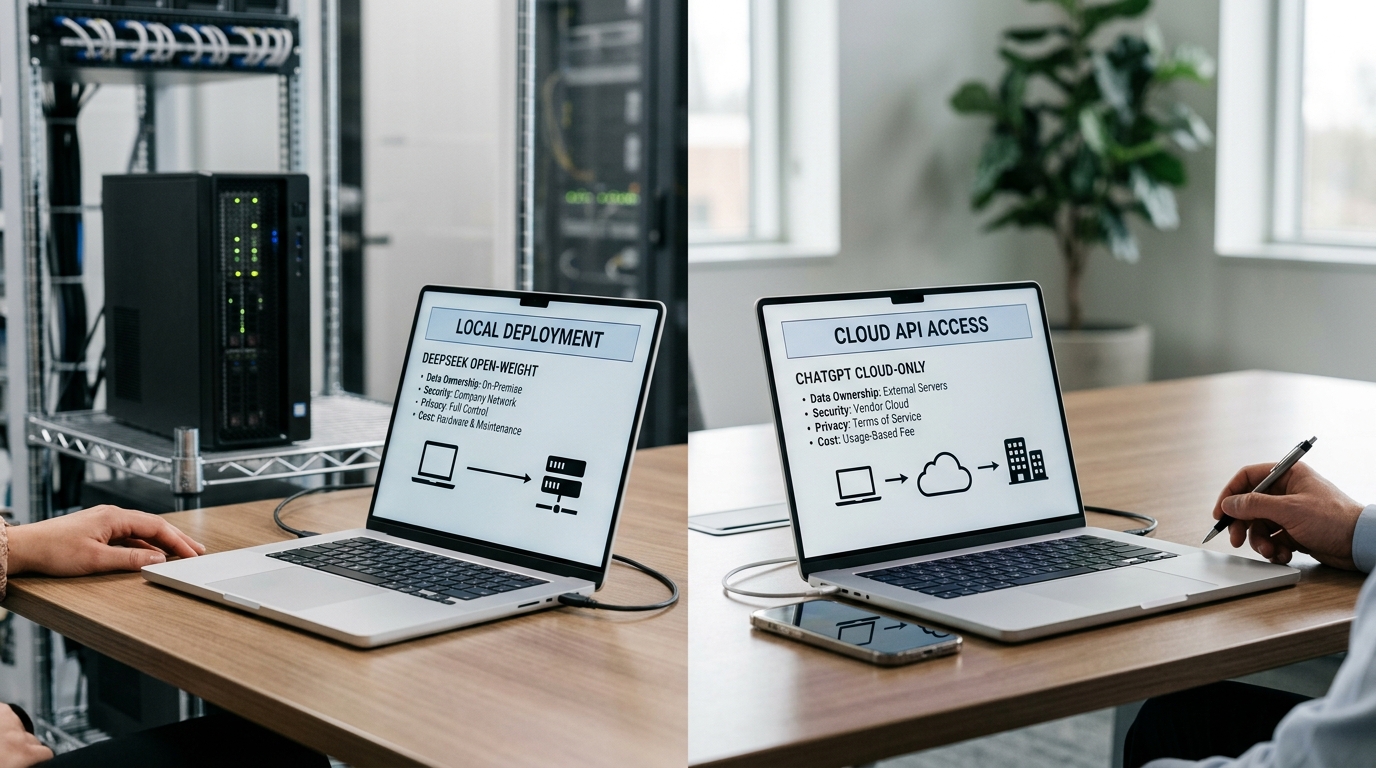
所谓「开放权重」,是指模型训练好的参数文件可以免费下载到自己服务器上运行,不必依赖官方接口
ChatGPT的 GPT 系列权重不公开,你只能通过 OpenAI 的云端 API 调用。这个差别决定了数据主权,用 DeepSeek,你可以让敏感数据完全不出公司内网。
成本是另一道分水岭
2025 年发布的 V3 与 R1 模型被美国国会研究处点名关注,原因正是它们在性能接近美国顶级模型的同时,训练与调用成本显著更低。2025 年 1 月,DeepSeek 的免费聊天应用一度登上美国 Apple App Store 免费榜第一。
到 2026 年,官方已推出 DeepSeek-V4.1-Flash,新增原生多模态视觉理解。对个人用户,官方 iOS 和 Android 应用依旧免费体验;对企业,开源路线意味着可自建、可微调、不被单一供应商锁定。
DeepSeek R1 和 V3 模型有什么区别?该选哪个?
V3 和 R1 是 DeepSeek AI 在 2025 年发布的两条产品线,定位完全不同:V3 是通用对话模型,响应快、适合写作和问答;R1 是推理模型,会先在内部”想一遍”再回答,擅长数学和代码。路透社 2025 年报道称两者性能都接近美国领先模型。选错模型会白白浪费时间和成本。
核心差别在于一个叫”链式思维”(Chain-of-Thought,指模型把推理步骤一步步写出来再给结论)的机制
R1 会生成大量中间推理过程,所以答数学题、找代码 bug 时准确率更高,但速度慢、消耗的 token(计费单位)也多。V3 跳过这一步,直接出答案,快但遇到复杂逻辑容易出错。
| 维度 | DeepSeek V3 | DeepSeek R1 |
|---|---|---|
| 定位 | 通用对话 | 深度推理 |
| 响应速度 | 快 | 慢(含推理过程) |
| 擅长任务 | 写文案、翻译、闲聊 | 数学、代码调试、逻辑题 |
| token 消耗 | 低 | 高 |
DeepSeek 给的实操建议很直接:写营销文案、客服问答、日常问答选 V3,省钱又快;解方程、证明题、排查一段跑不通的 Python 选 R1。别用 R1 写购物清单,那是用高射炮打蚊子。
DeepSeek 为什么训练成本这么低却性能很强?
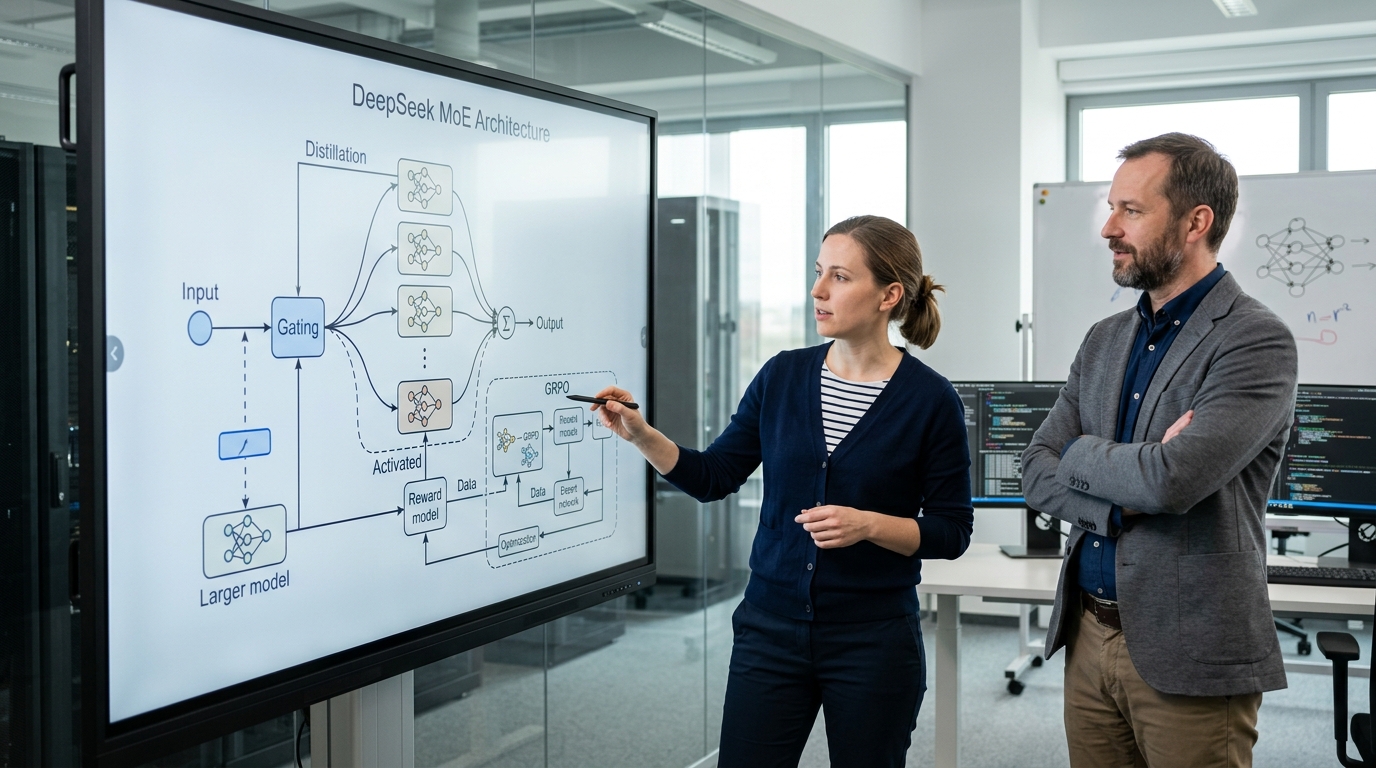
DeepSeek AI 把训练成本压到约 560 万美元,靠的不是”更先进”,而是三项工程取舍:只激活部分参数、把大模型的能力蒸馏进小模型、以及用纯强化学习省掉昂贵的人工标注。路透社 2025 年报道称,其 V3 与 R1 模型性能对标美国领先模型,而成本更低。这意味着中小团队也能用上接近顶级的模型。
MoE 混合专家架构是怎么省钱的?
MoE(Mixture of Experts,混合专家)把一个巨型模型拆成许多”专家”子网络,每次只唤醒其中几个。V3 总参数达 6710 亿,但处理每个词时只激活约 370 亿,相当于一家医院有几百个专科医生,病人来了只叫对口的那几位,而不是全体坐诊。算力花在该花的地方,训练和推理成本因此大幅下降。
模型蒸馏和 GRPO 分别解决什么问题?
蒸馏(distillation)是让小模型”抄”大模型的作业:用大模型生成的高质量答案去训练小模型,使几 B 参数的版本也能跑出接近大模型的推理水平,方便本地部署。
GRPO(分组相对策略优化)是 R1 的关键。传统做法要人工标注海量”好答案”,成本极高;GRPO 让模型自己生成多个解法、互相比较打分,像学生对答案一样自学,省去了昂贵的人工监督环节。这正是 R1 数学和代码能力强的原因。
所以”低成本”不等于”偷工减料”,而是把钱省在重复算力和人工标注上。
DeepSeek、ChatGPT、Claude、Gemini 哪个更好?四维对比
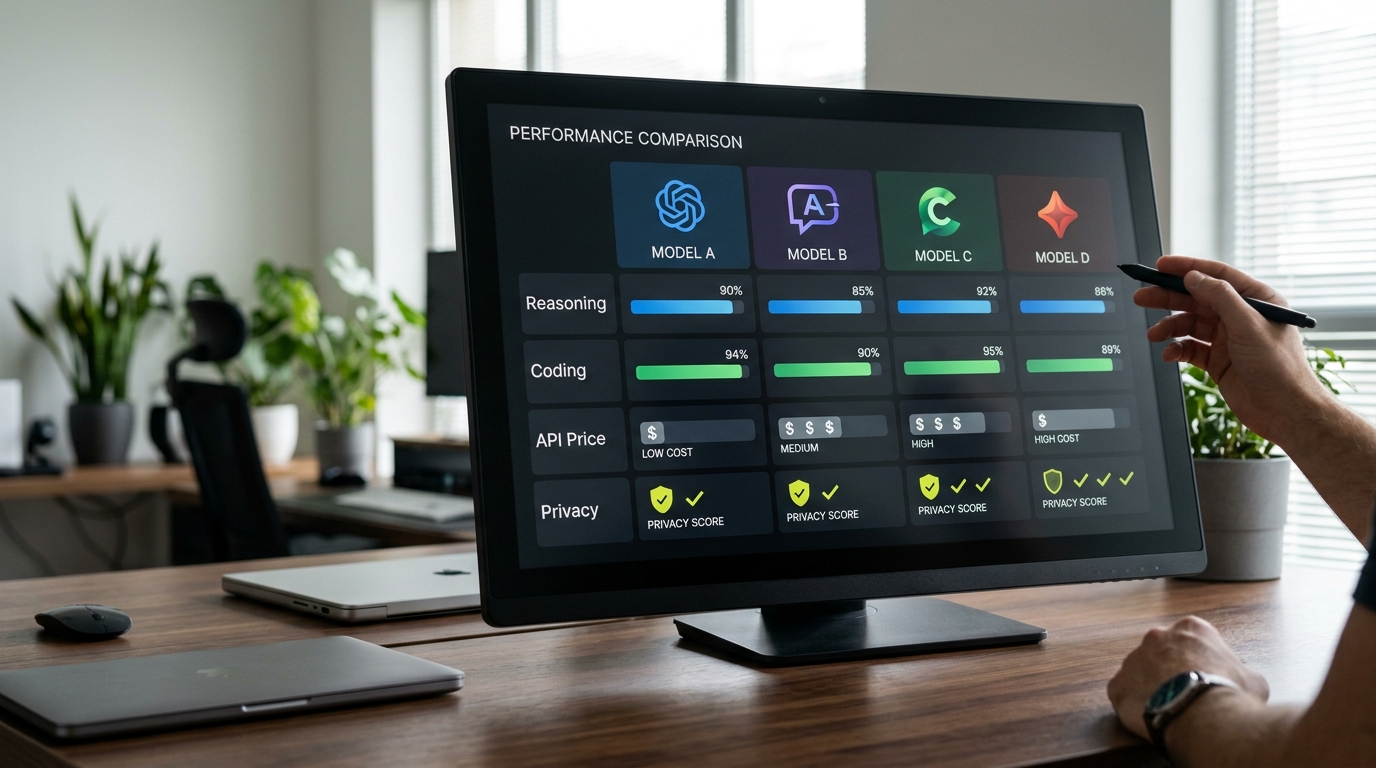
没有”最好”,只有”最适合你的任务”。在推理、代码、API 价格、数据隐私四个维度上,DeepSeek AI 的最大优势是成本,其 API 价格通常只有闭源模型的几分之一,加上开放权重(模型文件可自行下载部署)这一特性,让它成为预算敏感团队的首选;而 Claude 更稳、Gemini 更会处理图片和超长文档。
⚠️ 常见错误:无论什么任务都用 R1 推理模型,比如写购物清单、营销文案。原因 R1 会生成大量链式思维中间步骤,速度慢、token 消耗高,等于高射炮打蚊子。修复:写作、翻译、客服问答改用 V3,只有数学题和代码调试才启用 R1。
先看硬指标。价格一栏用的是 2026 年各家官网公开标价,单位是”每百万 token 的美元”(token 指模型处理文字的最小单位,一个汉字约占 1-2 个 token)。
| 维度 | DeepSeek | ChatGPT(GPT 系列) | Claude | Gemini |
|---|---|---|---|---|
| 推理能力 | R1 强(数学/代码) | 强,通用均衡 | 最稳,少幻觉 | 长文档强 |
| 代码生成 | R1 对标顶尖 | 优秀 | 公认最佳 | 中上 |
| 数据隐私 | 可本地部署,不出内网 | 云端为主 | 云端,企业版合规强 | 云端,绑定谷歌生态 |
| 部署方式 | 开源可自建 | 仅 API/闭源 | 仅 API/闭源 | 仅 API/闭源 |
谁该选谁?
- DeepSeek:适合要控成本、怕数据外泄的团队——因为能本地部署,敏感数据不出公司内网。不适合要原生图片理解又不想自建的人。
- Claude:适合写代码和长文审校,出错率低。不适合要极致低价的场景。
- Gemini:适合已用谷歌文档、Gmail 的办公族。
- ChatGPT:功能最全,适合不想折腾的普通用户。
路透社 2025 年报道称,DeepSeek 的 V3 与 R1 性能接近美国领先模型,这正是它敢打价格战的底气。
DeepSeek AI 能用来做什么?真实场景与上手体验
DeepSeek AI 在四类任务上表现最稳:代码调试、长文写作、数学推理和学习答疑。其中 R1 模型靠”先想再答”的推理链,在找出代码 bug 上明显强于普通对话模型;而中文长文写作时,V3 超过 2000 字后容易跑题。它的官方 App 在 2026 年仍免费开放,上手几乎零成本。
R1 在代码调试上到底强在哪?
R1 的强项是”定位错误原因”,不是写新代码。给它一段报错的 Python 函数,它会在内部推理链里逐行假设哪里出问题,再给出修复。实测一个常见场景:传入一段死循环代码,R1 能指出是边界条件写反,而不是只改表面语法。这类”根因分析”正是推理模型的价值。建议把完整报错信息和相关代码一起贴进去,别只发一行。
中文长文写作有什么坑?
V3 写短文流畅,但写长文有真实短板:生成 2000 字以上的中文内容时,后半段容易偏离开头设定的主题,论点开始重复。应对办法是分段生成,先让它列大纲,再逐节扩写,每节单独开一轮对话。学习答疑场景下,R1 的分步推理反而成了优势,解数学题时会把每一步算式写清楚,方便学生跟着复盘。
想了解它为何不止是聊天工具,可参考DeepSeek 的推理与开放接口机制。
DeepSeek 的数据隐私和合规风险有哪些需要注意?
使用 DeepSeek AI 官方 App 和网页版,你的对话数据会存储在中国境内的服务器上,受中国本地法律管辖,并受内容审查约束。这意味着政治敏感问题可能被过滤,企业机密或个人身份信息一旦输入,就可能触发合规风险。美国国会研究处 2025 年的报告指出,DeepSeek 的免费应用引发了多国政府和议员的数据安全担忧。
意大利数据保护局在 2025 年初以违反 GDPR(欧盟通用数据保护条例)为由,要求 DeepSeek App 下架
韩国个人信息保护委员会随后暂停其在应用商店的新下载。多个国家的政府机构、国防与政务部门也先后禁止在办公设备上安装该应用。
合规边界很清晰:别把受监管数据喂给官方云端版本。以下场景应避免使用 DeepSeek 云服务:
- 医疗健康数据:受 HIPAA(美国健康信息隐私法)约束的患者记录
- 金融客户信息:银行卡号、交易明细等需满足 PCI DSS 标准的数据
- 企业商业机密:未公开的源代码、合同条款、并购计划
想绕开数据出境问题?DeepSeek 的模型权重开源,可下载后在本地或私有云部署,对话全程不出你的服务器,这正是它相比闭源模型的隐私优势。下一节讲具体怎么部署。
如何通过 API 调用或本地部署 DeepSeek?
有两条路:调官方 API(最快、按量付费)或用开源权重本地部署(数据不出本机)。DeepSeek AI 的 API 价格通常只有闭源模型的几分之一,而本地跑完整版需要数百 GB 显存,绝大多数人该选蒸馏版小模型。IBM 在 2025 年证实其模型为开放权重,这正是本地部署能成立的前提。
API 怎么接?定价和调用方式是什么?
官方 API 兼容 OpenAI 的接口格式,这意味着你把原来调 ChatGPT 的代码里 base_url 改成 DeepSeek 的地址、换个 API key 就能跑,几乎零改造成本。计费按 token(模型处理的文字单位,1 token 约等于 0.75 个英文词)走,输入和输出分别算钱,命中缓存的输入还更便宜。
先在平台充值,创建 key,然后用 Python 的 openai 库发请求即可。调 deepseek-chat 走 V3,调 deepseek-reasoner 走 R1。
本地部署的硬件门槛有多高?
完整 671B 参数模型不是家用级任务。实用做法是部署蒸馏版(把大模型能力压进小模型的版本)。
| 方案 | 显存需求 | 适用场景 |
|---|---|---|
| Ollama 跑 7B 蒸馏版 | 8GB | 个人笔记本、尝鲜 |
| Ollama 跑 32B 蒸馏版 | 24GB | 单张 RTX 4090 |
| vLLM 部署 70B | 2×A100 | 企业内网服务 |
最简路径:装 Ollama,终端输入 ollama run deepseek-r1:7b,它会自动下载并启动。追求高并发就换 vLLM,它的批处理吞吐远高于 Ollama。deepseek 的建议是:数据敏感选本地蒸馏版,追求满血性能选官方 API。
总结 — DeepSeek AI 适不适合你?
DeepSeek AI最适合三类人:预算敏感的开发者、看重开源可控的工程团队、以及不涉敏感数据的个人用户。它的 API 价格通常只有闭源模型的几分之一,模型权重又可免费下载。但若你要处理企业机密或个人身份信息,官方 App 的数据存储在中国境内,这条路得慎走。
预算敏感?直接用
写作、翻译、代码调试这些日常任务,网页版免费,R1 和 V3 的质量足够用。省下的钱很实在,同样的调用量,成本可能只是别家的零头。
看重开源可控?优先本地部署蒸馏版
模型权重开放(文件可自行下载),数据不出本机,合规顾虑一笔勾销。IBM 在 2025 年明确将其定义为开放权重生成式 AI 模型,这正是企业内网部署的前提。
涉及敏感数据?别碰官方云端。
法律、医疗、金融类机密信息,要么本地部署,要么换合规方案。这不是性能问题,是管辖权问题。
下一步怎么走?
先用免费网页版试一周,拿你真实的任务去压测,中文长文、代码 bug、数学题各试几次。确认它扛得住,再决定是接 API 还是本地部署。DeepSeek 官网在 2026 年已推出 V4.1-Flash,带原生多模态视觉理解,值得一并试试。先小后大,别一上来就深度接入。