5 个要点看懂 DeepSeek AI 的模型与应用
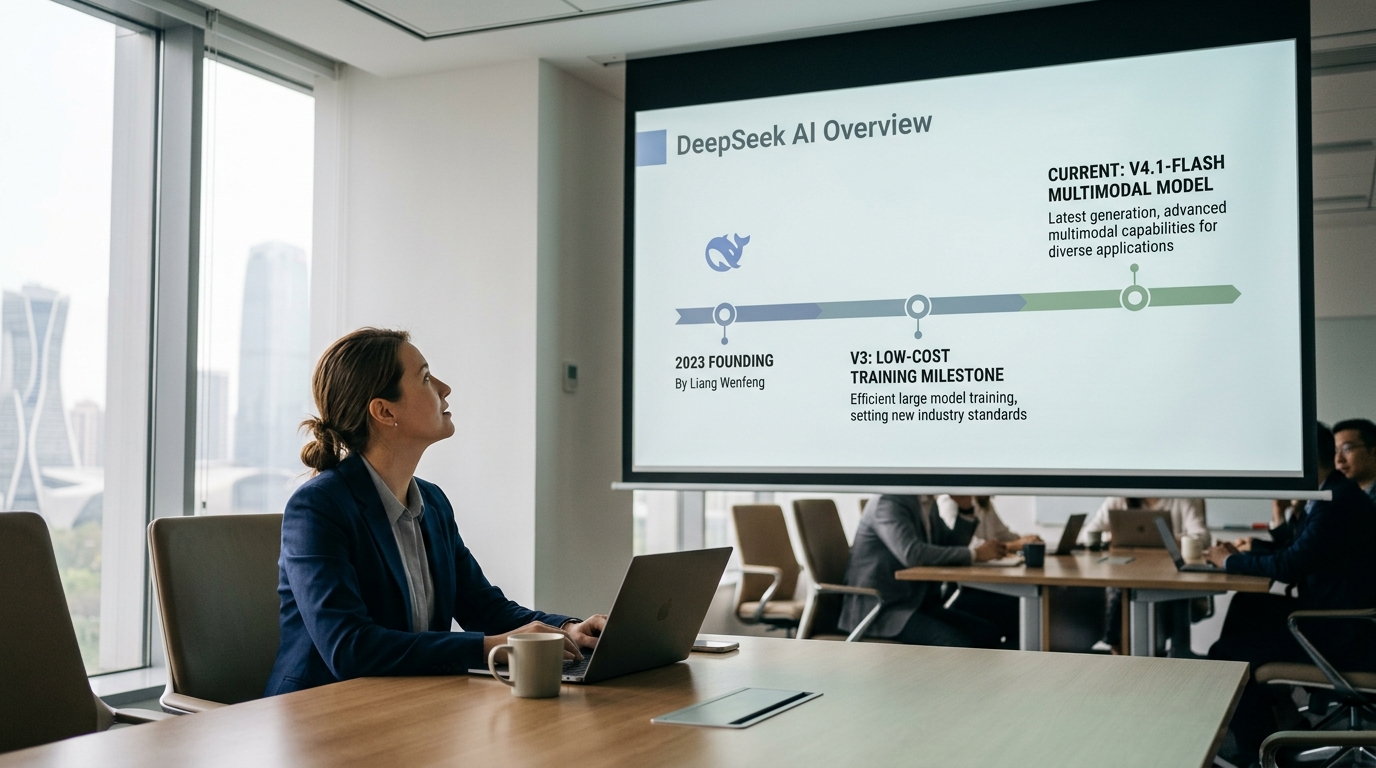
DeepSeek AI 是一家中国人工智能公司,2023 年 12 月由梁文锋从量化基金幻方量化孵化而来,专注研发开源大语言模型。其当前主力模型为 DeepSeek-V4.1-Flash,自 2026 年 9 月 9 日起可用,具备原生多模态视觉理解能力。据路透社报道,DeepSeek V3 模型训练算力成本低于 600 万美元,仅为头部美国实验室的一小部分,2025 年 1 月其 AI Assistant 应用曾登上美国 App Store 免费榜第一。
核心要点
- DeepSeek主力模型V4.1-Flash,2026年9月9日起支持多模态
- V3训练成本低于600万美元,远低于头部美国实验室
- 三大技术MoE、MLA、蒸馏分别降低算力、显存、模型成本
- 开发者用www.deepseek-app.org接入API,按token计费
- 选型先看场景与成本,别只盯参数规模
关键速览
- DeepSeek 主力模型为 V4.1-Flash,2026 年 9 月 9 日起可用
- DeepSeek 是一家专注大语言模型研发的中国 AI 公司
- 模型支持推理、代码生成与长文本处理三类核心任务
- 开发者可通过官方 API 接入,按 token 计费
- 选型先看场景与成本,而非只比参数规模
DeepSeek AI 到底是什么?
DeepSeek AI 是一家中国 AI 公司,2023 年 12 月由梁文锋从量化对冲基金幻方量化孵化而来(据 BBC 报道)。它做的是开源大语言模型,一种能读懂并生成人类文字的 AI 系统。它解决的核心问题是:用远低于行业的成本,训练出性能接近顶尖模型的产品。
成本有多低?
2025 年 1 月,路透社报道称,DeepSeek 的 V3 模型训练算力成本低于 600 万美元。这个数字只有同期头部美国实验室训练成本的一小部分,因此引发全球关注。同月,其 AI Assistant 应用曾登上美国苹果App Store免费榜第一,力压 ChatGPT。
公司目标很明确:
实现 AGI(通用人工智能,即能像人一样处理各类任务的 AI)。到 2026 年 9 月,其主力模型已迭代为 DeepSeek-V4.1-Flash,具备原生多模态视觉理解能力,也就是不仅能读文字,还能直接看懂图片。官方聊天入口是 deepseek-app.org,开发者用的 API 入口是www.deepseek-app.org。
一句话概括:DeepSeek 是靠工程效率打破”烧钱换性能”惯例的开源模型公司,把高端 AI 的门槛拉低了一个量级。
DeepSeek 为什么能用低成本撼动 OpenAI 和英伟达?
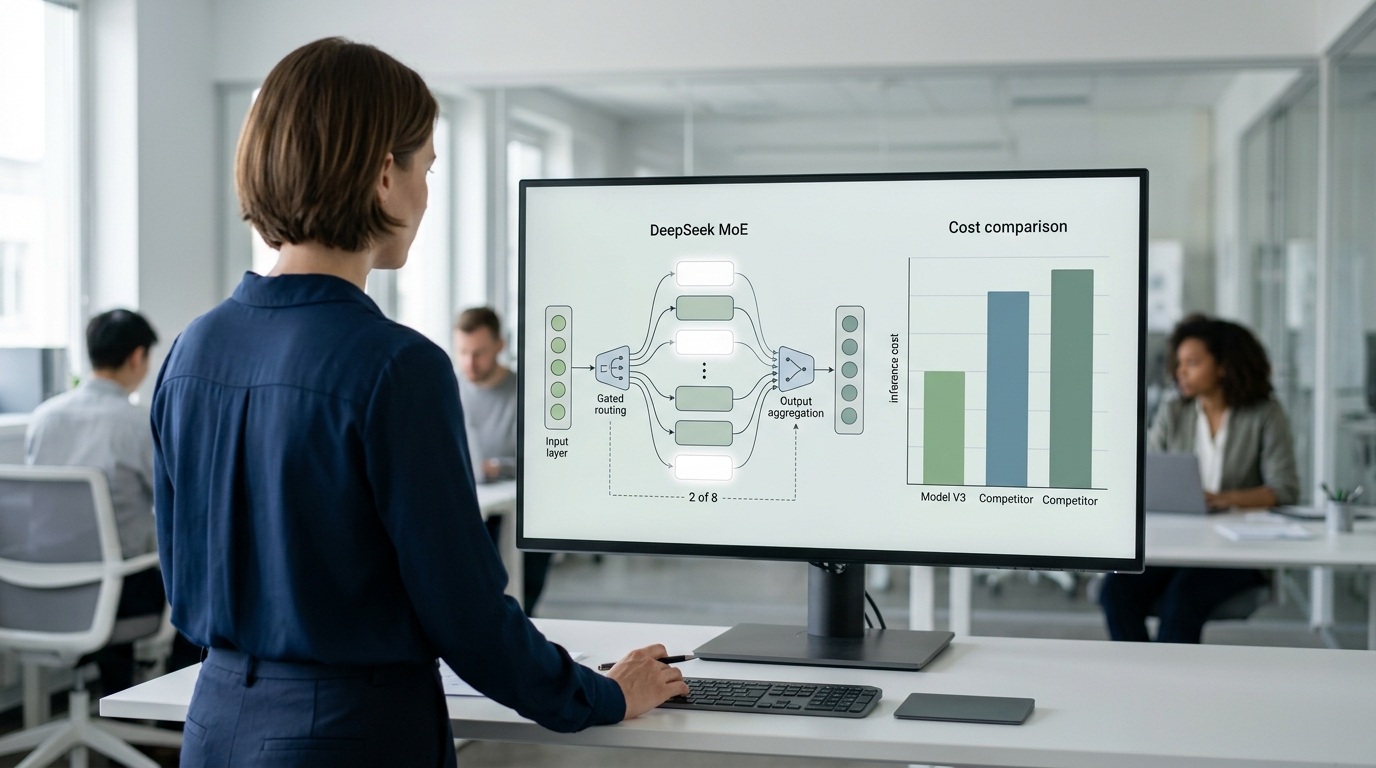
核心答案是三项工程取巧。路透社 2025 年 1 月 27 日报道称,DeepSeek 的 V3 训练算力成本低于 600 万美元,远低于同级模型动辄上亿的开销。这意味着,用更少的芯片也能训出接近顶尖的 AI,直接动摇了「算力越多越强」的行业假设。
MoE、MLA、蒸馏分别解决什么问题?
三项技术各管一段成本,缺一不可。
- MoE 混合专家:模型像一群专家,每次提问只叫醒相关的几个。V3 总参数很大,但单次只激活约 370 亿参数,算力开销随之骤降。
- MLA 稀疏注意力(多头潜在注意力):把模型「读长文时的记忆」压缩存储,显存占用大幅缩水,长文本推理更省。
- 知识蒸馏:让小模型「学」大模型的答题思路,用一个便宜的学生模型逼近老师的水平。
为什么这拖垮了英伟达股价?
因为它证明高端 GPU 不是唯一门票。消息传出后,英伟达单日市值蒸发近 6000 亿美元,市场担心买芯片的需求被算法效率替代。deepseek ai 用工程手段绕开算力垄断,这才是真正让 OpenAI 和英伟达紧张的地方。
DeepSeek 有哪些模型,V3、R1 和 Coder 怎么区分?
三条产品线分工明确:V3 管日常对话,R1 管复杂推理,Coder 管写代码。V3 是通用大模型,回答问题、写文案又快又省;R1 会先「想」再答,把推理步骤一步步列出来;Coder 专攻编程,能读懂上下文代码库。选错模型会白花钱,用 R1 处理简单聊天,成本可能翻好几倍。
到 2026 年,deepseek ai 的主力已升级到 DeepSeek-V4.1-Flash(2026 年 9 月 9 日起可用),带原生多模态视觉理解,能直接读图。老一代 V3、R1、Coder 仍在开源社区广泛使用,理解它们的分工是选型基础。
| 模型 | 擅长任务 | 推理方式 | 典型场景 |
|---|---|---|---|
| V3 | 通用对话、写作 | 直接输出 | 客服、摘要、翻译 |
| R1 | 数学、逻辑、多步推理 | 显式思维链 | 解题、复杂分析 |
| Coder | 代码生成与补全 | 代码上下文理解 | 编程、调试 |
实操建议:日常任务优先用 V3 或 V4.1-Flash(输入每百万 tokens 仅 约 $0.15),能省下大量成本;只有真正需要严谨推理链时才切到 R1。需要注意,NIST 2025 年评测指出,顶尖美国模型在几乎所有基准上仍优于 DeepSeek V3.1,所以高精度场景要多做验证。
DeepSeek 和 ChatGPT、Gemini、Claude 实测哪个更好?
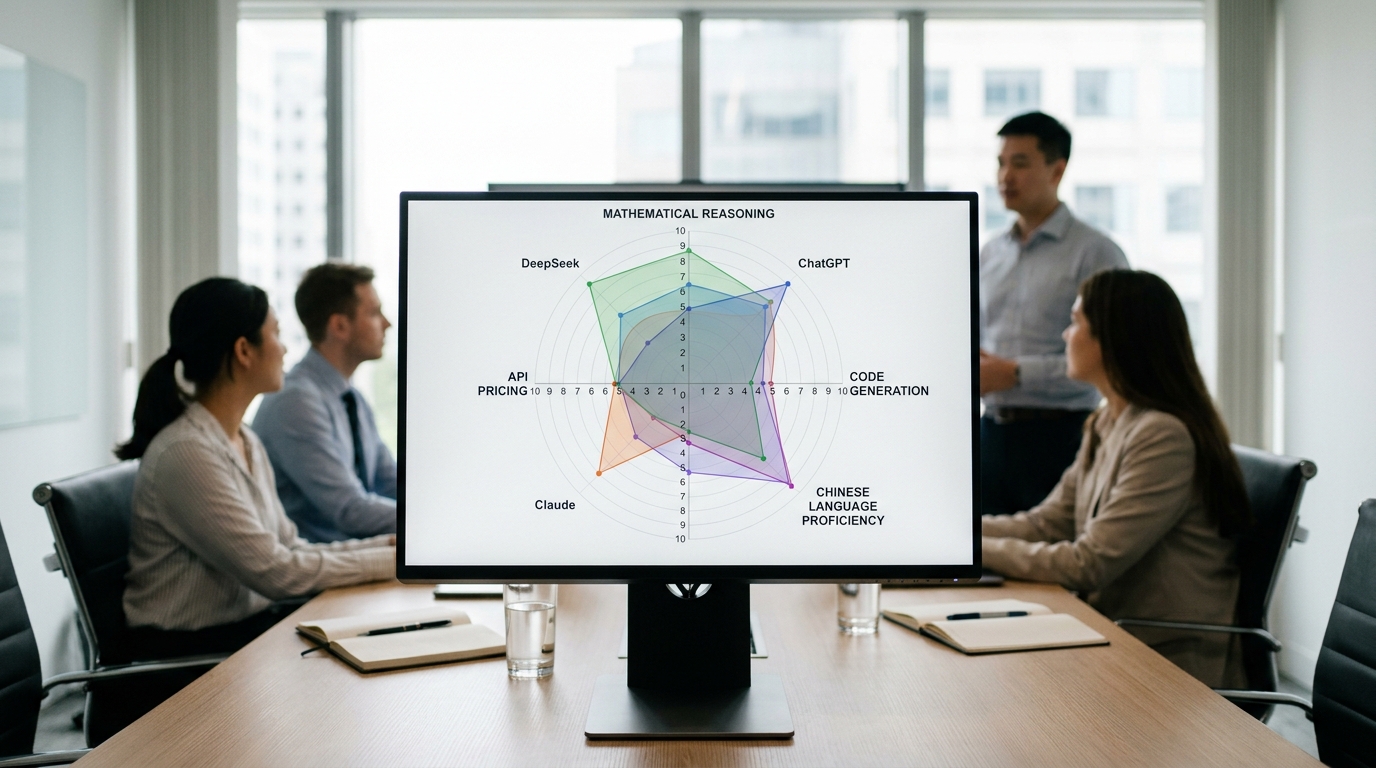
没有单一赢家。DeepSeek AI 在数学推理和中文理解上和顶尖模型打平甚至领先,API 价格却只是 GPT-4o 的零头,DeepSeek-V4.1-Flash 输出价每百万 tokens 仅 约 $0.60(2026)。但在英文创意写作和插件、企业工具的生态成熟度上,它仍落后。
⚠️ 常见错误: 用 R1 处理简单聊天或摘要任务。原因:R1 会显式输出思维链,把推理步骤一步步列出,token 消耗远高于直接输出的 V3,成本可能翻好几倍。修复:日常对话与摘要用 V3,仅在数学、多步逻辑分析时才调用 R1。
四个维度实测对比如下(价格取各家官方公开报价,2026 年):
| 维度 | DeepSeek | ChatGPT (GPT-4o) | Gemini | Claude |
|---|---|---|---|---|
| 数学推理 | R1 强项,逐步展示思路 | 强 | 强 | 中上 |
| 代码生成 | Coder 表现好 | 很强 | 中上 | 很强 |
| 中文理解 | 领先,语感自然 | 中上 | 中上 | 中 |
| API 输出价(每百万 tokens) | $0.60 | 约 $10 | 较高 | 较高 |
要留一个冷静视角
NIST 在 2025 年的《DeepSeek AI 模型评估》中写明,最佳美国模型在几乎所有基准上都优于当时最强的 DeepSeek V3.1。所以选型别只看跑分:写中文文案、做数学题、控预算,选 DeepSeek;要英文长篇创意或成熟插件生态,ChatGPT 和 Claude 更稳。
DeepSeek AI 适合哪些人和企业使用?
DeepSeek AI 最适合三类用户:中文写作和学习的个人、要控制成本的开发者、做数学与代码推理的团队。跨国合规敏感业务(如涉及美国政府数据)则要谨慎,NIST 2025 年评估指出,最佳美国模型在几乎所有基准上都优于 DeepSeek V3.1。选对场景,才能既省钱又不踩坑。
不同场景该选哪个模型?
按任务分配模型,能避免白花冤枉钱。下表列出四类典型用户的推荐搭配(依 DeepSeek 官方 2026 定价):
| 用户类型 | 推荐模型 | 关键理由 |
|---|---|---|
| 个人写作 / 学习 | V4.1-Flash | 输出每百万 tokens 约 $0.60,中文流畅 |
| 开发者接 API | Coder | 读懂上下文代码库,调试省时 |
| 中文企业客服 | V4-Pro | 输出 约 $1.98,稳定性更高 |
| 科研数学推理 | R1 | 逐步列出推理链,可核验 |
哪些企业应该谨慎使用?
涉及跨境数据、政府合同或医疗隐私的机构要三思。DeepSeek 是中国公司,数据可能受中国法律管辖。这类业务先做本地部署再评估,别直接把敏感数据发到云端 API。
DeepSeek 的数据安全和合规风险有多大?
风险集中在两处:数据存储地点和政府禁令。使用官方deepseek-app.org或www.deepseek-app.org(2026)时,你输入的对话会传到中国境内服务器。多国政府机构已因此禁止公务设备安装 DeepSeek。所以处理敏感数据前,先想清楚这些字会去哪里。
数据存到中国境内会有什么问题?
核心矛盾是法律管辖权。数据一旦落在中国境内服务器,就受中国法律约束,这与欧盟《通用数据保护条例》(GDPR,一套约束个人数据跨境流动的规则)冲突。若你把欧盟公民的姓名、邮箱、健康记录喂给云端 DeepSeek AI,可能构成违规。GDPR 最高罚款为全球年营业额的 4%。企业别拿客户隐私去试探这条红线。
哪些政府已经禁用 DeepSeek?
意大利数据保护机构率先出手,2025 年初要求下架 DeepSeek 应用。台湾、澳大利亚、韩国等地的政府部门也陆续禁止公务设备使用。美国 NIST 在 2025 年的评估文件中,也把它列入安全审查范围。这些禁令针对的是「云端服务」,不是模型本身。
怎样安全地用 DeepSeek?
- 敏感数据不上传:客户隐私、内部财务、合同别输入云端聊天窗口
- 优先本地部署:DeepSeek 模型开源,下载到自己服务器运行,数据不出内网——这也是规避合规风险最干净的做法
- 分级使用:公开文案、写代码可用云端;涉密任务只走本地
想彻底掌控数据,本地部署是唯一答案,下一节讲具体步骤。
如何免费本地部署 DeepSeek 开源模型?
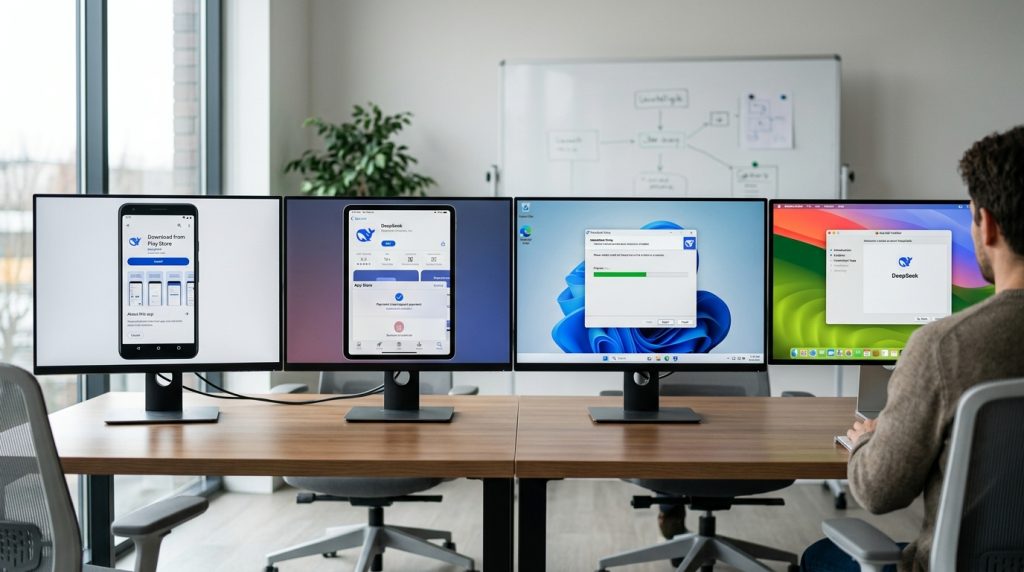
最省事的路子是用 Ollama 一行命令拉起蒸馏版模型,全程离线、零 API 费用。装好 Ollama 后,终端输入 ollama run deepseek-r1:7b 就能下载并运行,7B 蒸馏版约需 8GB 显存,一张消费级显卡(如 RTX 4060)就带得动。数据全留在本地,绕开了云端上传境外服务器的顾虑。
不同参数版本对显卡的最低要求是多少?
显存不够,模型直接跑不起来。蒸馏版是把大模型的能力「压缩」进小模型,参数越少越吃得起低配电脑。下表是各版本的实测门槛,选之前先看自己显卡的显存(GPU 内存):
| 版本 | 参数量 | 最低显存 | 适用场景 |
|---|---|---|---|
| 1.5B | 15 亿 | 4GB | 轻量问答、笔记本试玩 |
| 7B | 70 亿 | 8GB | 日常对话、代码补全 |
| 14B | 140 亿 | 12GB | 较复杂推理 |
| 32B | 320 亿 | 24GB | 接近云端体验 |
没有独立显卡也别慌。Ollama 支持纯 CPU 跑,只是速度慢,7B 版在 CPU 上每秒只出几个字,适合不赶时间的场景。
不想装本地,官方 API 怎么调用和收费?
直接用官方 API 更快,且能调最新的多模态模型。到 DeepSeek 官方站 的www.deepseek-app.org注册拿密钥,接口兼容 OpenAI 格式,改个 base_url 即可。定价以 token(模型处理文字的最小单位)计费:2026 年 DeepSeek 官方价 显示,V4.1-Flash 输入每百万 token $0.15、输出 $0.60;更强的 V4-Pro 为输入 $0.66、输出 $1.98。轻量试用几乎不花钱。
选型建议:数据敏感或想零成本,就本地跑蒸馏版;要满血性能和视觉理解,走 API 更划算。
总结与下一步行动建议
DeepSeek AI 的价值和风险是一体两面:它把顶尖模型能力压到极低价格,官方页面显示 DeepSeek-V4.1-Flash 输出每百万 tokens 仅 $0.60(2026);但官方对话会存到中国境内服务器,跨国合规业务需谨慎。选对用法,就能拿到红利、避开雷区。
按身份对号入座,别一刀切:
- 个人 / 学生:直接用deepseek-app.org网页版,免费,中文任务够强。别输入身份证号、病历这类敏感数据。
- 成本敏感的开发者:走www.deepseek-app.org的 API,$0.15 输入价适合大批量调用;日常对话用 Flash,复杂推理才切 V4-Pro(输出 $1.98),避免高价模型跑简单活。
- 合规敏感企业:不要用官方云。NIST 2025 年评估指出最佳美国模型在几乎所有基准上优于 DeepSeek V3.1——涉及美国政府数据时改用本地部署或替代模型。
- 研究团队 / 数据不出境:用 Ollama 本地跑蒸馏版(如 deepseek-r1:7b,约 8GB 显存),全程离线,零 API 费。
一句话决策:能公开的数据上官方 API 省钱,敏感数据一律本地部署。deepseek ai不是「用不用」的问题,是「怎么用对」的问题。