5个关键问题看懂DeepSeek的模型与能力边界
DeepSeek 是由中国杭州深度求索公司开发的开源大语言模型系列,创始人为梁文锋,公司成立于 2023 年 7 月。其主力包括 V3 通用模型(参数达 6710 亿,采用 MoE 架构)与 R1 推理模型两条线,模型权重以 MIT 许可开源,可免费商用与本地部署。R1 于 2025 年 1 月 20 日发布,通过强化学习训练,擅长数学、代码与多步逻辑推理。
核心要点
- DeepSeek由杭州深度求索开发,梁文锋2023年7月创立
- R1模型2025年1月20日发布,强化学习训练擅长推理
- 模型权重MIT许可开源,可免费商用与本地部署
- V3参数6710亿,MoE架构只激活部分专家省算力
- 年推出V4.1-Flash,新增原生多模态视觉理解
关键速览
- DeepSeek 主力包括 V3 通用模型与 R1 推理模型两条线。
- R1 采用强化学习训练,擅长数学、代码与多步逻辑推理。
- 模型权重以 MIT 许可开源,可商用、可本地部署。
- V3 参数达 6710 亿,采用 MoE 架构降低推理成本。
- 训练数据截止时间限制了它对最新事件的准确性。
DeepSeek是什么?由哪家公司开发?
DeepSeek 是由中国杭州深度求索公司开发的开源大语言模型(open-source large language model,即公开源代码、可免费下载使用的 AI 模型)。据 Wikipedia 公司条目,该公司成立于 2023 年 7 月 17 日,创始人为梁文锋。它把前沿模型免费开放,因此在全球 AI 圈引发关注。
深度求索背后是谁?
深度求索的资金与团队根基来自一家量化对冲基金。行业资料显示,公司与中国量化机构High-Flyer关系密切,由后者持有或资助。这一背景很关键,量化基金早年为交易囤积了大量图形处理器(GPU,训练 AI 的核心硬件),为模型训练提供了算力底座。
公司规模并不大。截至 2025 年,员工数仅 160 人,远小于同级别的国际 AI 实验室。第一个模型早在 2023 年 11 月发布,此后迭代节奏一直很快。
DeepSeek 为什么引发全球关注?
真正让它出圈的是 DeepSeek-R1。据 CSIS 的分析,R1 于 2025 年 1 月 20 日发布,被视为它在全球 AI 竞争中确立地位的关键。R1 采用开源许可,允许免费商用,直接冲击了闭源付费模型的定价逻辑。到 2026 年,公司又推出了 DeepSeek-V4.1-Flash,加入了原生多模态视觉理解能力(模型能直接看懂图片,而非只处理文字)。
DeepSeek的模型原理是怎么工作的?
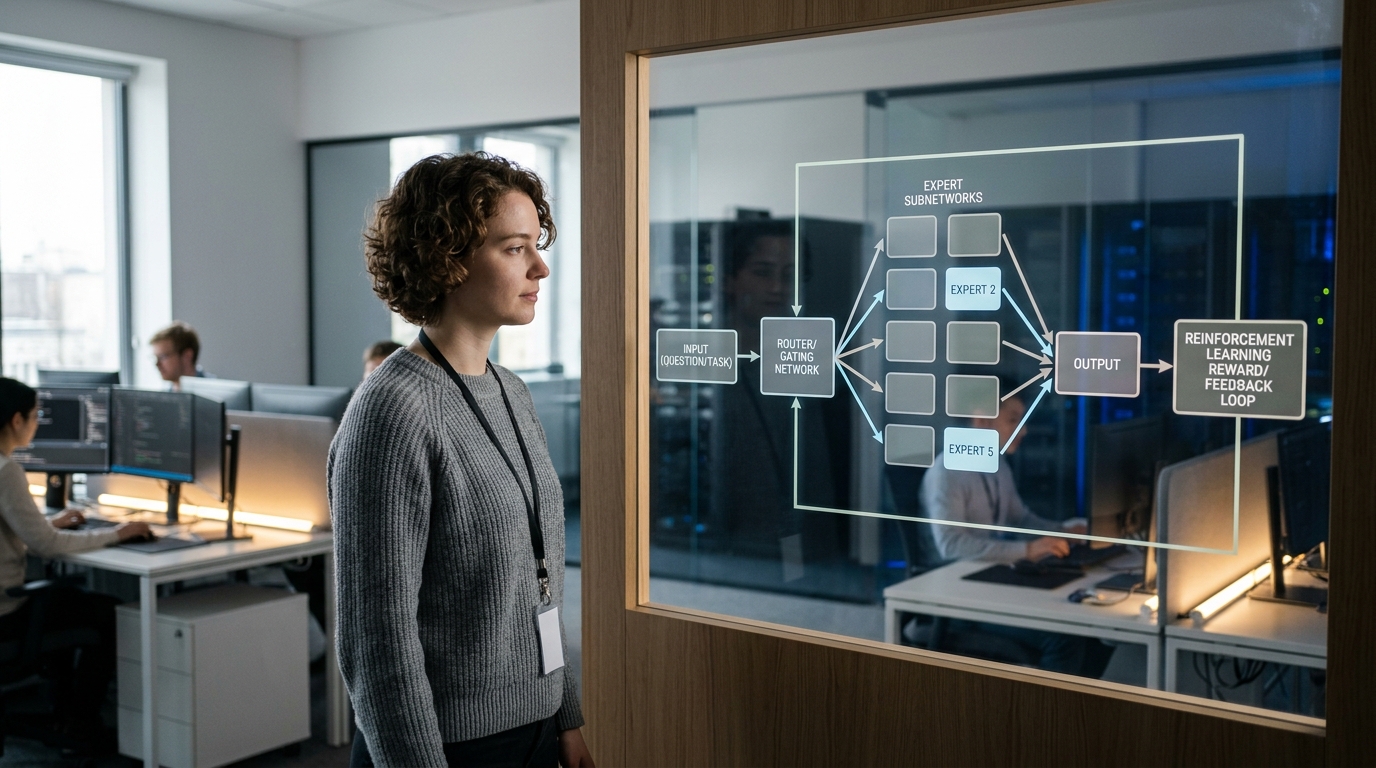
DeepSeek 靠两步走:先用海量文本预训练打基础,再用强化学习(reinforcement learning,一种让模型通过”试错拿奖励”来自我改进的训练方法)教会它逐步推理。据 IBM 技术分析(2025),DeepSeek-R1 就是在 V3 基础上微调而来,会先生成长长的推理过程,再给出答案。这意味着它擅长数学、代码这类需要”想清楚再回答”的任务。
MoE 混合专家架构是怎么省算力的?
MoE(Mixture of Experts,混合专家)的思路很简单:模型内部养着一群”专家”子网络,每次回答只叫醒相关的几个,而不是全部一起算。好比一家医院,你挂号看眼科,不需要全院医生都来会诊。
这样做的好处是参数总量可以很大,但每次推理真正激活的只是一小部分。算力成本随之大幅下降,这正是 DeepSeek 能用较少显卡跑出高性能的核心原因。
强化学习是怎么训出 R1 的推理能力的?
关键在于给模型的”正确推理”发奖励。训练时不直接喂标准答案,而是让模型自己尝试多种解法,答对的路径获得正反馈,模型逐渐学会拉长思考链条。
据 CSIS 分析(2025),R1 于 2025 年 1 月 20 日发布,是让 DeepSeek 在全球竞争中站稳脚跟的关键一步。到 2026 年,官网推出的 DeepSeek-V4.1-Flash 更把这套机制扩展到多模态视觉理解。
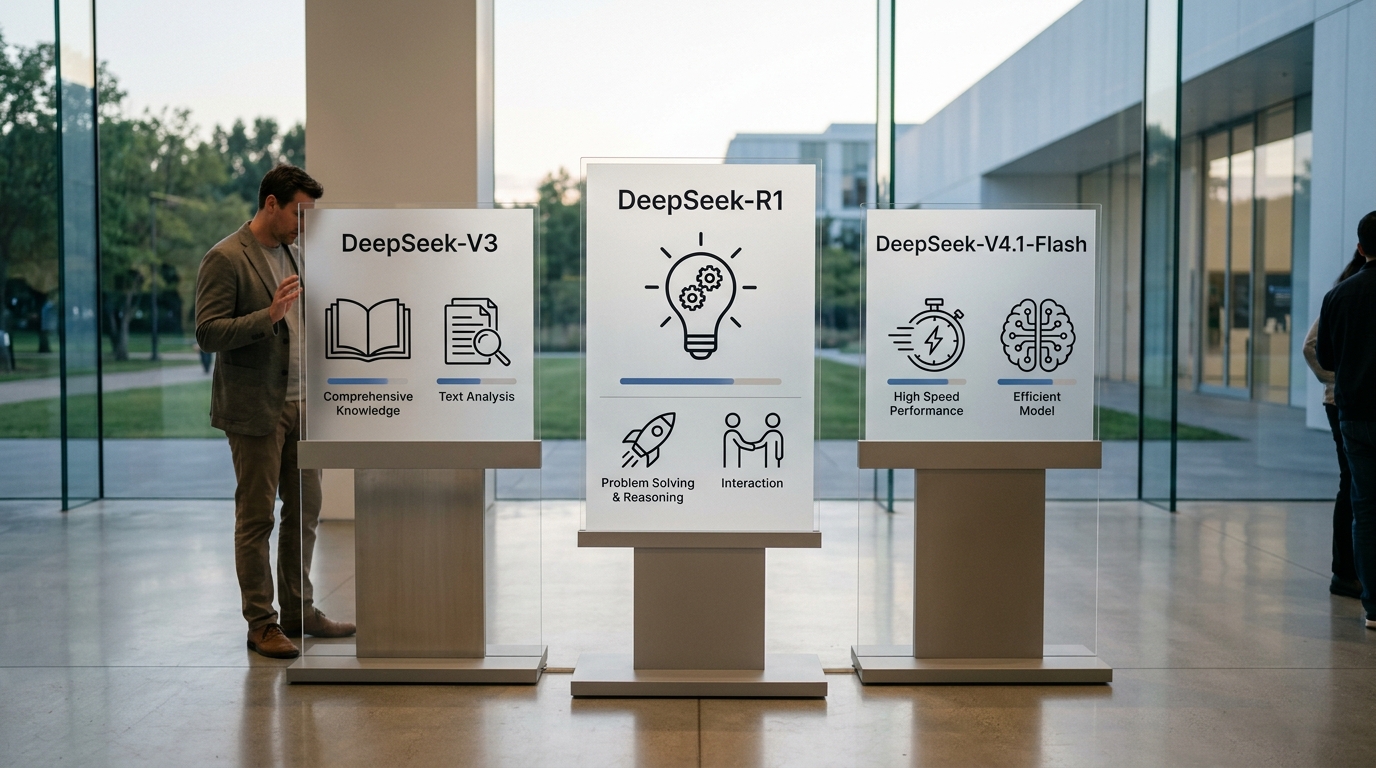
DeepSeek-V3和R1等版本有什么区别?该怎么选?
V3 是通用对话模型,反应快、适合日常问答;R1 是推理模型,会先生成一长串逐步思考再给答案,适合数学、代码和逻辑难题。据 IBM 技术分析(2025),R1 正是在 V3 基础上微调而成。选谁看任务:要快选 V3,要准选 R1。
R1 于 2025 年 1 月 20 日发布,被视为 DeepSeek 打入全球 AI 竞争的关键一步。2026 年,官网又推出了 DeepSeek-V4.1-Flash,加入原生多模态视觉理解,能看图回答问题。
各版本分别适合什么任务?
不同版本对应不同活儿。下表帮你快速对号入座。
| 版本 | 擅长任务 | 响应特点 |
|---|---|---|
| V3 | 日常问答、写作、翻译 | 快,不显示思考过程 |
| R1 | 数学、代码调试、逻辑推理 | 慢,显示逐步推理链 |
| V4.1-Flash | 看图、多模态、Agent 任务 | 快,支持视觉输入 |
普通用户和开发者该怎么选?
普通用户直接用网页版聊天窗口,免费、无需配置,切换 V3 或 R1 只需点一个「深度思考」按钮。开发者建议接 API:按调用量计费,能把 R1 的推理链嵌进自己的应用,比如自动写测试用例或核对财务逻辑。DeepSeek 的建议是,先用网页版试出哪个版本答得准,再决定 API 里调哪个模型,省钱又省调试时间。
DeepSeek和ChatGPT、Gemini、Claude哪个更好?
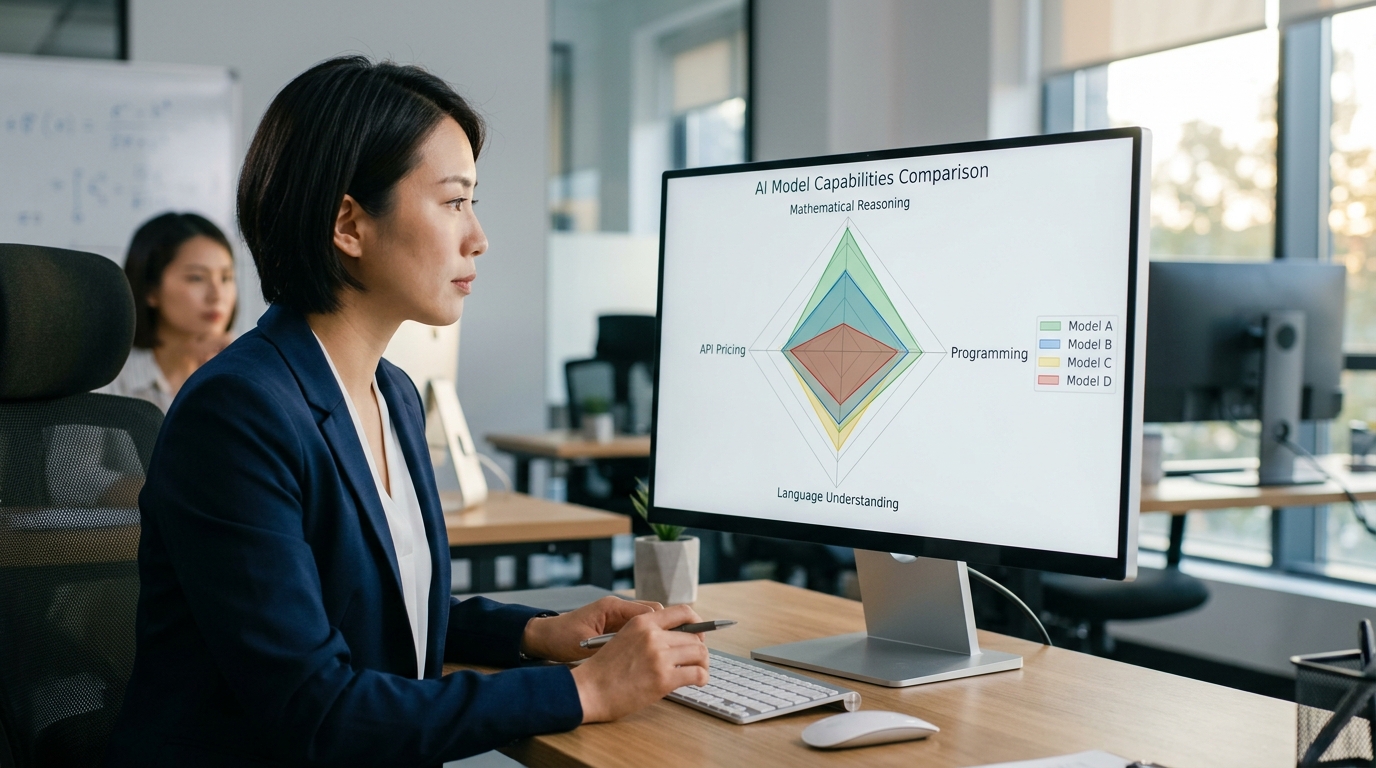
没有”最好”,只有”最合适”。DeepSeek 的核心优势是开源免费和低价 API,在中文理解和数学推理上表现突出;ChatGPT 和 Claude 胜在生态成熟与编程稳定,Gemini 强在超长文本处理。据 TechTarget 报道,DeepSeek-R1 采用开源许可、可免费使用,这是四款里独一份。
⚠️ 常见错误: 把日常问答任务全部丢给 R1 推理模型,导致响应慢、成本高。原因 R1 会先生成长长的推理链条再作答,适合数学、代码等需”想清楚”的难题,而非简单闲聊。修复:快速问答改用 V3 通用模型,仅在多步逻辑任务时切换 R1。
下面按四个真实可比的维度横向对照,帮你按任务选型:
| 维度 | DeepSeek | ChatGPT | Gemini | Claude |
|---|---|---|---|---|
| 数学/逻辑推理 | R1 强,逐步推理 | 强,稳定 | 中上 | 中上 |
| 编程能力 | 强,代码补全好 | 很强,生态最全 | 中 | 很强,长代码 |
| 中文理解 | 母语级,最贴中文语境 | 好 | 好 | 较好 |
| 开源/授权 | 开源可免费商用 | 闭源 | 闭源 | 闭源 |
| API 成本 | 最低档 | 较高 | 中 | 中高 |
谁适合选 DeepSeek?
预算有限、需要私有化部署、或做大量中文任务的团队。因为它开源,你能把模型下载到自己服务器(私有部署,即数据不出公司),这是闭源模型做不到的。
谁不该选?
依赖插件生态、要接大量第三方工具的用户,ChatGPT 的成熟度更高。若你的活儿是超长文档一次性读入,Gemini 的长上下文更省事。
一句话:算数学、写中文、控成本,DeepSeek 值得优先试;要开箱即用的完整生态,选闭源大厂。
DeepSeek能用来做什么?能力边界在哪里?
DeepSeek 最擅长四件事:中英文写作、代码生成、数学推理和结构化资料分析。据 DeepSeek 官网,2026 年发布的 DeepSeek-V4.1-Flash 新增了原生多模态视觉理解能力(能直接”看懂”图片内容)。但它有三条明确红线:会编造事实、拿不到实时信息、超长文档处理会掉链子。用它前,先分清哪些活它能干、哪些活它会翻车。
四大场景里,DeepSeek 各自表现如何?
写作和代码是它的主场,数学靠 R1 推理模型托底,资料分析则要看你喂的数据干不干净。
| 场景 | 推荐模型 | 实测表现 |
|---|---|---|
| 中文写作 | V3 | 行文自然,改稿快 |
| 编程 | R1 | 算法题强,长项目易漏上下文 |
| 数学推理 | R1 | 会写出逐步推导过程 |
| 资料分析 | V3/V4.1 | 表格提取准,图片需多模态版 |
DeepSeek 的能力边界具体在哪?
最常见的翻车是”幻觉”(hallucination,指模型一本正经地编造不存在的事实)。问它某本书的具体页码或某条冷门法条,它可能给你一个看似合理却完全虚构的答案。
- 实时信息缺失:模型训练数据有截止日期,问它今天的股价或昨天的新闻,它答不了。
- 长文档处理:塞进几万字的合同,它容易忘掉开头的条款,前后自相矛盾。
- 专业事实核查:医疗、法律等高风险内容,务必人工复核,别直接采信。
实操建议:把 DeepSeek 当成”高效初稿工具”,而非”最终答案机”。关键数字和引用一定回原始文件二次确认。
用DeepSeek安全吗?数据存在哪、企业能否合规使用?
用官方 App 或网页版时,DeepSeek 的对话数据存储在中国境内的服务器上,这触发了多国监管审查。据 TechTarget(2025),DeepSeek 的资金背景与量化对冲基金 High-Flyer 有关。企业若要合规使用,答案很明确:别用公有云版处理敏感数据,改走私有化部署。
数据到底存在哪、哪些国家封了它?
2025 年多国政府机构以数据安全为由,限制在办公设备上安装 DeepSeek 官方 App。原因是官方隐私政策写明用户输入、设备信息会传回中国境内服务器。金融、医疗、政务这类受监管行业,把客户资料贴进公有云版,可能直接违反本地数据保护法。
企业怎么合规用?私有化部署是关键
DeepSeek 提供 R1 等模型的开源许可,允许免费下载并部署到自己的服务器(据 TechTarget,2025)。这是核心优势:
- 本地私有化部署:把开源权重装在企业内网 GPU 上,数据全程不出公司,绕开跨境传输问题。
- 量化小模型:R1 蒸馏版可在单张消费级显卡跑,中小团队也能落地。
个人怎么识别错误答案?
DeepSeek 会”一本正经地编造”,业内叫幻觉(hallucination)。实操三招:让它给出信息来源并逐一核对;用不同措辞重问同一问题,对比答案是否自相矛盾;涉及数字、法条、医疗建议时,一律回到官方原始文件二次验证。
总结与上手建议
DeepSeek是一款开源、低价的中文强项大模型,最佳定位是”高性价比的推理与写作工具”。据 DeepSeek 官网,2026 年发布的 DeepSeek-V4.1-Flash 已具备原生多模态视觉理解。想省钱、要中文、做数学代码就选它;要成熟生态和数据出境合规则另作打算。
普通用户该怎么快速上手?
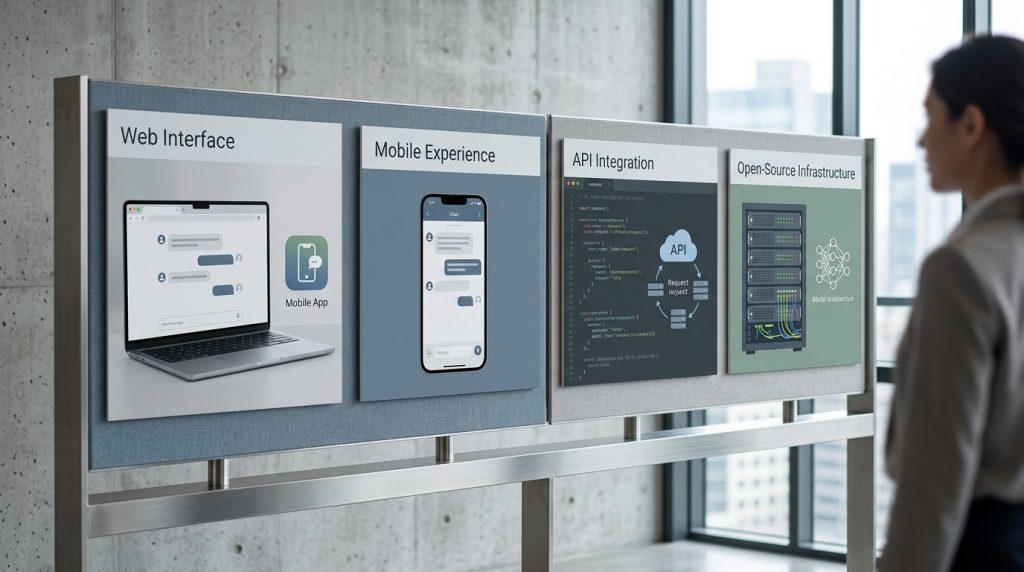
普通用户直接用免费网页版就够了,一句建议:日常问答开 V3,遇到数学题或逻辑难题手动切到 R1 深度思考模式。验证清单三条:
- 查事实:凡是涉及数字、日期、人名的回答,去官方源头核对一遍——它会编造不存在的引用。
- 看时间:追问模型训练数据截止到哪年,避免把过时信息当最新。
- 护隐私:官方 App 数据存中国境内服务器,别输入身份证号、病历等敏感信息。
开发者接入前要验证什么?
开发者一句建议:先用 API 跑通 100 条真实业务样本再决定要不要上生产。据 TechTarget(2025),R1 采用开源许可可免费下载自部署,这是绕开数据出境问题的关键路径。上线前验证清单:
- 压测延迟:R1 输出长推理链,响应比 V3 慢,实时场景要实测 P95 延迟(约 95% 请求的耗时上限)。
- 算成本:按 token 计费,把预估月调用量乘单价,对比自部署的 GPU 成本。
- 验合规:跨境业务优先选本地部署或第三方托管版本,避开官方云端。