DeepSeek AI 能力拆解 5 个表现突出的使用场景
deepseek ai是中国 AI 公司推出的开源大模型系列,主打低成本与高性能,涵盖 R1 推理、V3/V4 通用和 Coder 编程三条产品线。它采用 MoE 混合专家架构,V3 总参数 671B 但每个 token 仅激活 37B,激活比例约 5.5%。价格极低:V4.1-Flash 每百万 tokens 输入仅 US约 $0.14、输出 US约 $0.28,支持最长 100 万 token 上下文,尤其适合预算敏感又要真实性能的团队。
核心要点
- MoE架构让V3总参671B仅激活37B,成本压至小模型级别
- V4.1-Flash百万tokens输入0.14美元,输出0.28美元,性价比极高
- 支持最长100万token上下文,长文档可一次性输入不分段
- R1走强化学习推理链,可分步解题,适合竞赛与工程计算
- 网页版deepseek-app.org免费用,低价API可直接接入产品
关键速览
- 代码生成支持数十种编程语言,可直接输出可运行片段
- 上下文窗口支持长文档一次性输入,减少分段丢失信息
- 数学推理具备分步解题能力,适合竞赛题与工程计算
- 中英双语互译流畅,专业术语准确率高于通用翻译工具
- API 调用成本低,适合高频批量任务的规模化部署
DeepSeek AI 是什么 一句话讲清它的定位
DeepSeek AI 是中国 AI 公司推出的大模型系列,主打低成本、高性能和开源策略,涵盖 R1 推理模型、V3/V4 通用模型和 Coder 编程模型三条产品线。它在 2025 年 1 月因移动聊天应用和 DeepSeek-R1 模型发布获得国际关注,官方入口是 deepseek-app.org。这意味着你既能免费用网页版聊天,也能按低价调用 API 接入自己的产品。
它的核心竞争力藏在架构里
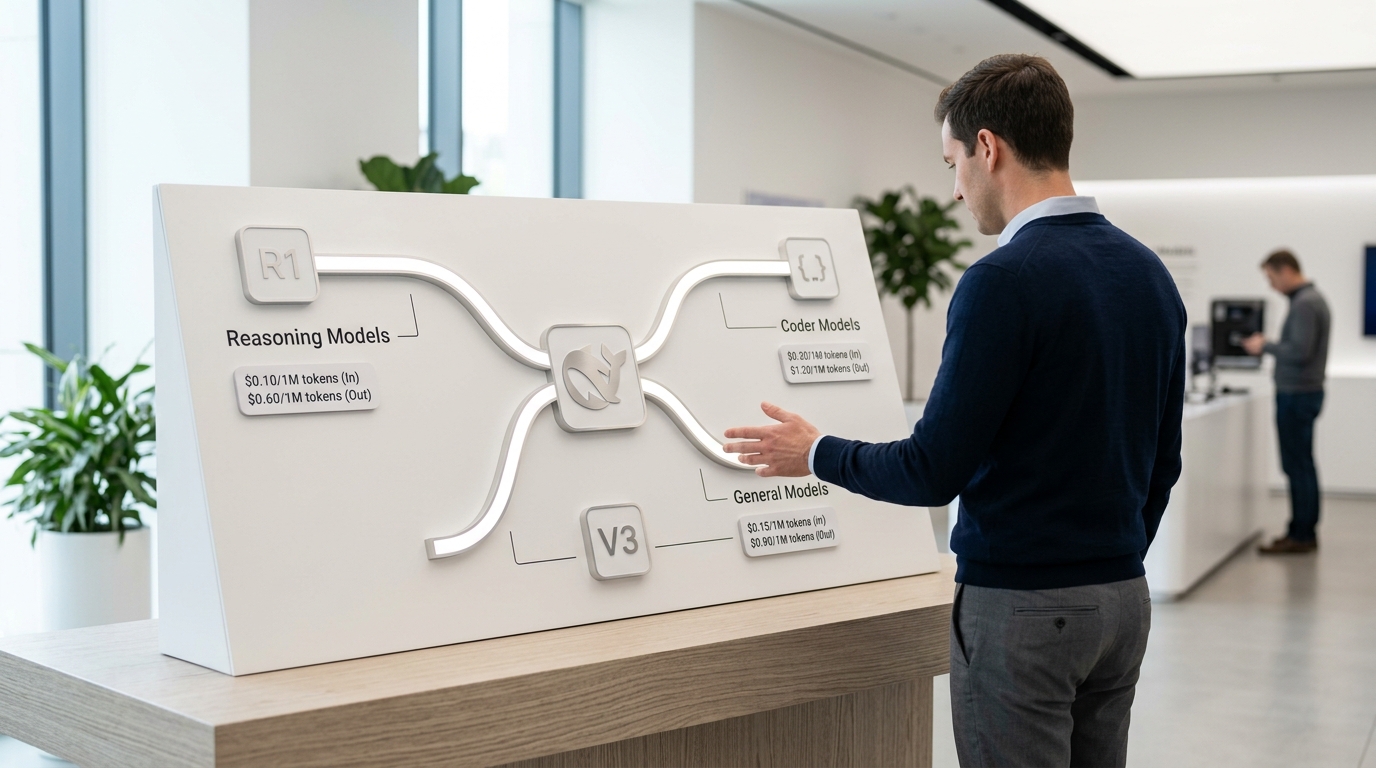
DeepSeek 用的是 MoE(Mixture-of-Experts,混合专家模型,把大模型拆成很多”专家”,每次只唤醒需要的那几个,省算力)。以 DeepSeek-V3 为例,总参数 671B,但每个 token 只激活 37B。这就是它能把价格压这么低的技术底气。
价格有多低?
据 DeepSeek 官方平台页,V4.1-Flash 每 100 万 tokens 输入仅 US约 $0.14、输出 US约 $0.28,还支持最长 100 万 token 上下文和原生多模态视觉理解。
一句话记住它:一个开源、便宜、推理能力强的中国大模型家族,尤其适合预算敏感又要真实性能的团队。
DeepSeek 的多模型架构由哪些部分组成
DeepSeek AI 的架构核心是 MoE(Mixture-of-Experts,混合专家模型),把一个大模型拆成很多”专家”子网络。以 DeepSeek-V3 为例,它总共有 6710 亿参数,但处理每个 token 时只激活 370 亿。这意味着算力只花在真正需要的专家上,训练和推理成本因此能压到密集模型的几分之一。
V3 的 6710 亿参数为什么只激活 370 亿?
MoE 的秘诀在于”按需调用”。模型里有一个路由器(router),它像调度员,只把每个 token 派给最相关的少数几个专家处理。V3 的 6710 亿总参数中,单次仅激活 370 亿,激活比例约 5.5%。因此虽然模型很大,实际算力开销接近一个 370 亿参数的小模型。
2026 年发布的 V4.1-Flash 延续这套设计,主干(backbone)达 5520 亿参数,还支持最长 100 万 token 上下文和原生多模态视觉理解。
R1 和 Coder 分别专精什么?
R1 走强化学习路线,专攻推理链。它不是靠猜答案,而是被训练成一步步”想”出来,先列推理过程,再给结论。2025 年 5 月发布的 R1-0528 还加入了 JSON 输出和函数调用支持。
Coder 则用海量代码数据专项训练,擅长补全和调试。三条产品线共用 MoE 底座,各自微调,这正是 DeepSeek 能把成本压低还保持多面能力的关键。
DeepSeek R1、V3 与 Coder 该怎么选
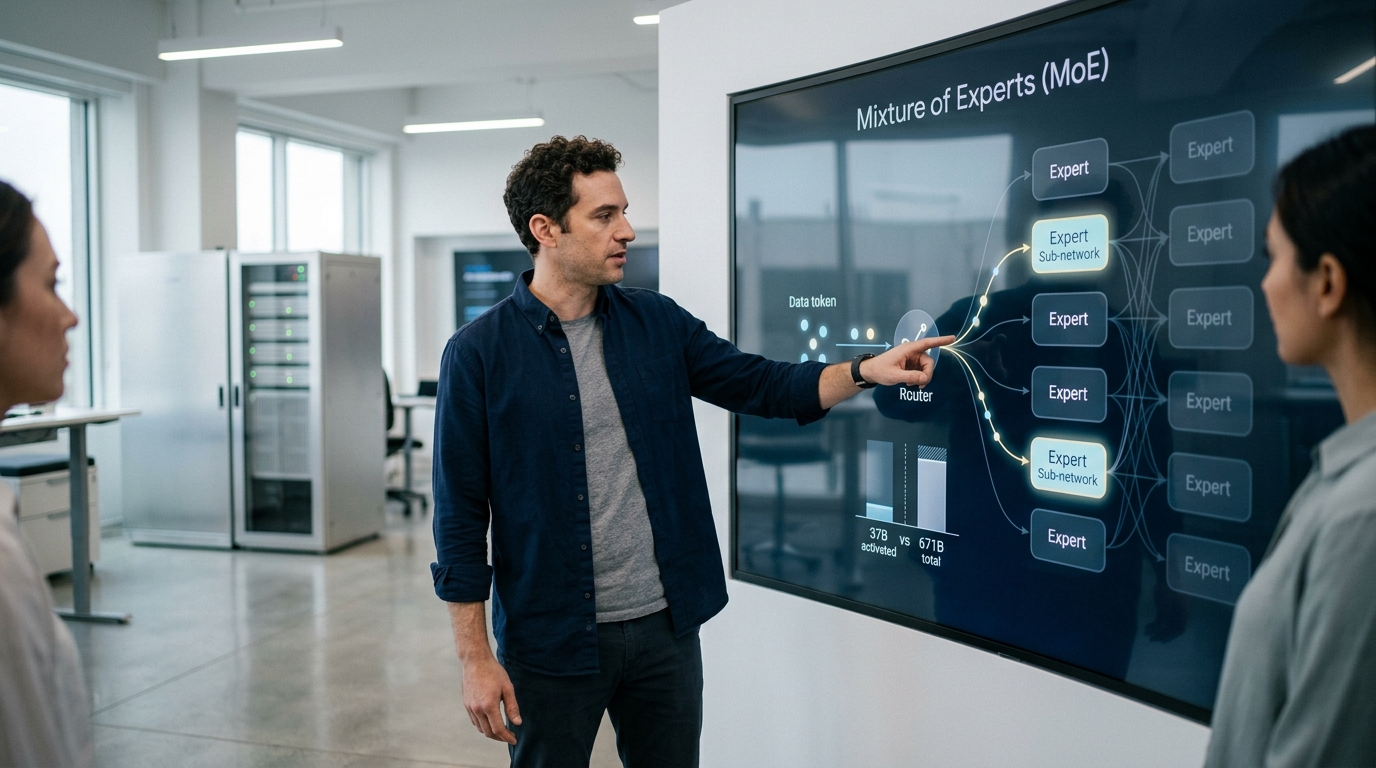
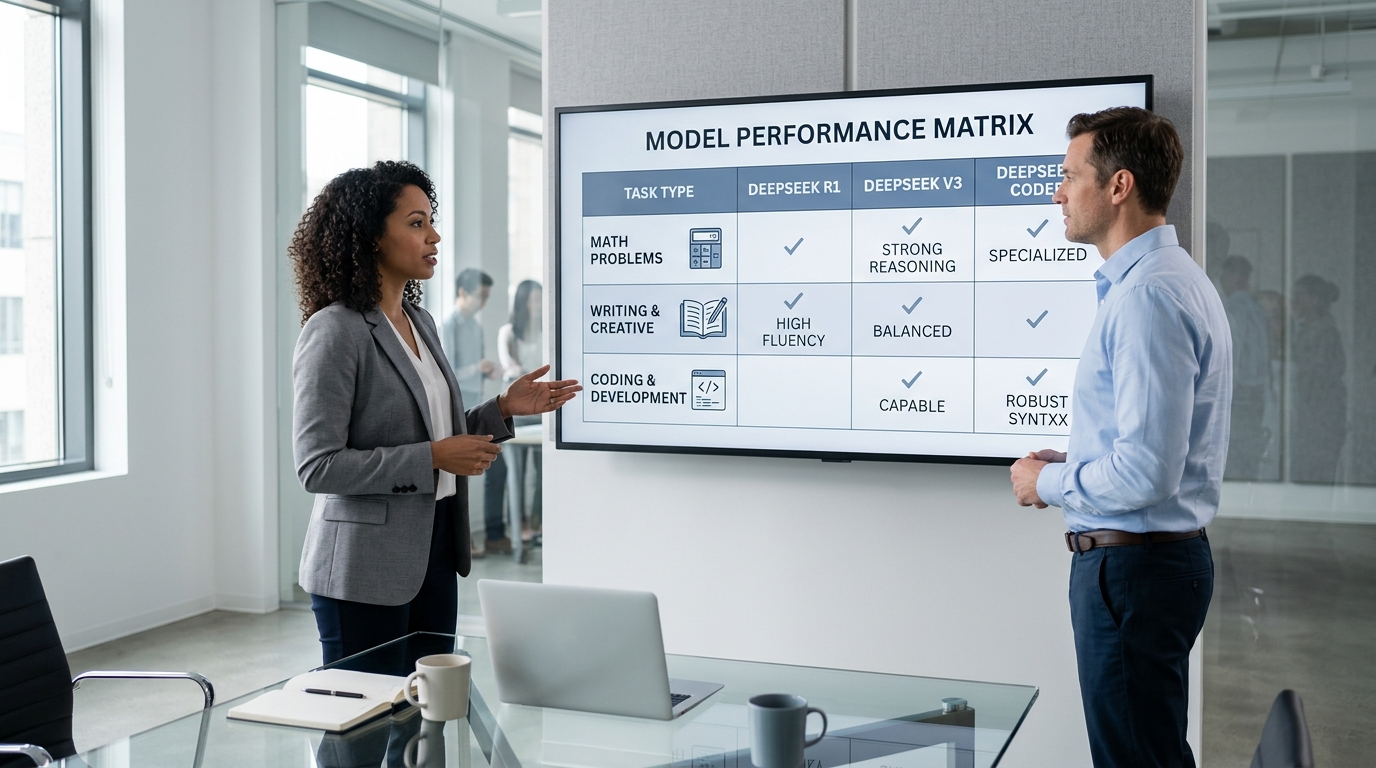
选模型看任务类型:需要多步推理选 R1,日常问答和写作选 V3,写代码和调试选 Coder。DeepSeek-R1-0528 在 2025 年 5 月的更新中新增了 JSON 输出和函数调用,让推理结果更容易接入程序。选错模型不只慢,还多花钱。
三款模型分别擅长什么任务?
R1 是推理模型,回答前会先”想一遍”,把思考过程写出来再给结论。它适合数学证明、逻辑谜题、多条件决策这类需要拆步骤的任务。V3 是通用模型,反应快、成本低,处理翻译、邮件草稿、知识问答最合适。Coder 专门吃过大量代码语料,补全函数、找 bug、解释旧代码的准确率比通用模型高。
| 任务 | 推荐模型 | 原因 |
|---|---|---|
| 数学题、复杂逻辑 | R1 | 输出思维链,逐步推导 |
| 日常问答、写文案 | V3 | 响应快、单价低 |
| 代码补全、调试 | Coder | 代码专训,报错定位准 |
成本上怎么算账?
R1 因为要生成思维链,输出的 token 数往往是 V3 的好几倍,费用自然高。简单问答硬上 R1 就是浪费。DeepSeek 的建议很直接:能用 V3 解决的别调 R1。V3 系列按每百万 token 计费,输入低至 US$0.14,跑高频任务成本可控。
普通用户和开发者如何真正上手 DeepSeek
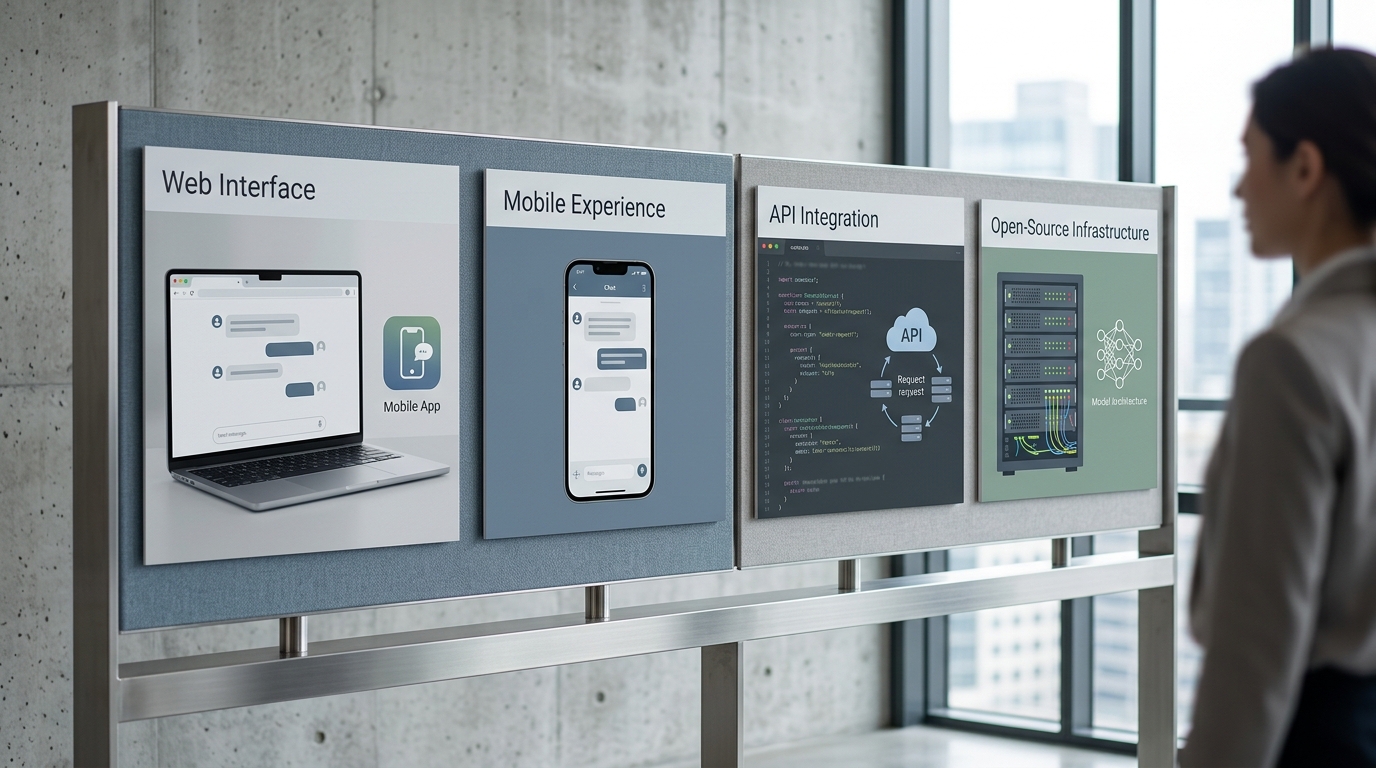
上手 DeepSeek 有四条路径:网页版、手机 App、开放平台 API 和开源权重。零基础用户打开deepseek-app.org就能直接对话,无需注册付费;开发者接 API 按量计费,V4.1-Flash 输入价格为每百万 token US$0.14(2026)。选哪条,取决于你要”聊天”还是”接进程序”。
⚠️ 常见错误:把简单问答也用 R1 推理模型处理,结果又慢又贵。原因 R1 会先生成完整思考链再给结论,为无需推理的任务白白消耗大量 token。修复:日常问答、翻译、写作改用 V3,仅把多步数学、逻辑决策留给 R1。
零基础用户走哪条路最快?
网页版和 App 是门槛最低的两条。打开官网聊天入口,输入问题即可,界面和微信聊天差不多。手机端在应用商店搜 DeepSeek 下载,登录后同一账号数据互通。想用推理模式(多步思考),点开对话框里的”深度思考”开关即可切到 R1。
内容创作者怎么配置更省事?
创作者建议直接用网页版加浏览器插件,把长文喂进去做改写或摘要。V4.1-Flash 支持最长 100 万 token 上下文(2026),相当于一次塞进上百页文档,不用切段。
开发者最短接入路径是什么?
开发者去开放平台注册,拿 API Key,接口兼容 OpenAI 格式,改个 base_url 就能迁移旧代码。要私有部署选开源权重,从Hugging Face下载即可,但 V4.1-Flash 是 552B backbone 的 MoE 模型,需多张高显存 GPU,个人机器跑不动。
DeepSeek 免费额度与 API 计费和 ChatGPT、Gemini 差多少
DeepSeek AI 的 API 是三家里最便宜的。据 DeepSeek 开放平台,V4.1-Flash 每百万 token 输入(cache miss,即没命中缓存)US$0.14、输出 US$0.28。这只有主流大模型旗舰款的零头,同样预算能多跑十几倍的量。
每百万 token 到底差多少钱?
直接看数字最清楚。下表按输入/输出价格排列,价格越低越靠前:
| 模型 | 输入(US$/百万 token) | 输出(US$/百万 token) |
|---|---|---|
| DeepSeek V4.1-Flash | 0.14 | 0.28 |
| DeepSeek V4-Pro | 0.66 | 1.98 |
| ChatGPT旗舰级 | 约 2.50 | 约 10.00 |
| Gemini 旗舰级 | 约 1.25 | 约 5.00 |
光看输出这一栏:V4.1-Flash 的 US$0.28 只是 GPT 旗舰约 US$10 的 3% 左右。做批量翻译、客服问答这类高 token 场景,一个月账单能从上千美元压到几十美元。
缓存命中和夜间折扣怎么省?
命中缓存能再砍价。DeepSeek 对重复输入(cache hit)单独定价,比 cache miss 便宜一大截。实操上,把固定的 system prompt(系统提示词,即每次都发的开场指令)放在请求最前面,就更容易命中缓存。此外平台有夜间折扣时段,跑离线批处理任务放到低价窗口执行,成本还能再降。
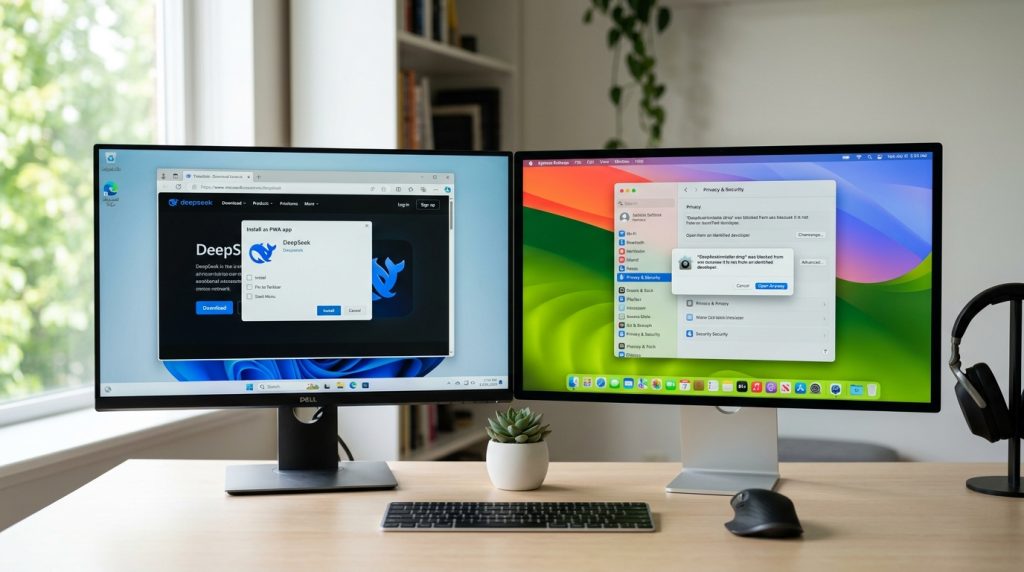
免费用户走另一条路:打开deepseek-app.org网页版无需付费即可对话,适合个人试用;真要跑量再上 API。
用 DeepSeek 前必须知道的数据隐私与监管争议
用 DeepSeek 前要先搞清一件事:默认情况下,你的对话数据存在中国境内的服务器上。DeepSeek AI 自 2025 年 1 月因聊天应用走红后,多个国家政府迅速展开数据合规调查。若你处理的是客户敏感信息或受监管数据,直接用官方网页版风险偏高。
DeepSeek 把数据存在哪里?
DeepSeek 的隐私政策写明,通过官方 App 和网页版输入的内容会传输并存储在中国的服务器。这些数据可能被用于模型训练,除非你手动关闭训练选项。这里有个关键区别:调用 开放平台 API 时,数据处理方式和网页版不同,企业应仔细核对 API 的数据保留条款,别把网页版政策当成 API 政策。
哪些国家禁用或调查了 DeepSeek?
意大利数据保护局(Garante)在 2025 年 1 月末以隐私合规问题为由,要求 DeepSeek 停止在意大利处理数据,随后其 App 从当地应用商店下架。韩国个人信息保护委员会(PIPC)同期启动调查,并暂停了 App 的新用户下载。多国政府机构还禁止公务设备安装该应用。
合规敏感场景该怎么替代?
答案很直接:把模型和数据分开。DeepSeek 采用开源权重策略,你可以下载模型部署在自己的私有服务器或本地机房,数据完全不出内网。这是金融、医疗等受监管行业的可行路径。若必须用云端,就选带明确数据驻留条款的合规部署,避开公共 App。
使用 DeepSeek 时最容易踩的三个坑
用 DeepSeek AI 最常见的三个错误是:把 R1 当日常聊天助手、忽略长文本的上下文上限、把敏感数据直接喂给公开 API。这三类问题反复出现在用户反馈里,前两个拖慢速度、多花钱,第三个则可能违规。避开它们不需要改代码,只需换个用法习惯。
为什么不该把 R1 当通用聊天用?
R1 是推理模型,回答前会生成一长串思考过程(chain-of-thought)。你问”今天天气怎么写祝福语”这种简单问题,它照样先”想”半天,既慢又多算 token。日常问答和写作请直接用 V3 或 V4.1-Flash,把 R1 留给需要多步逻辑的数学题、代码调试和复杂规划。选对模型,响应时间能从十几秒降到一两秒。
长文本上下文到底有多大限制?
别以为能无限往里塞。DeepSeek-V4.1-Flash 支持最长 100 万 token 上下文(2026),听着很大,但你贴超长文档时,模型对开头和结尾记得清、中间容易”读漏”,这是业内说的”lost in the middle”现象。实操建议:长文先拆段、给小标题,把关键指令放在最前和最后。
敏感数据能直接发给公开 API 吗?
不能。公开网页版和 API 的对话会经过 DeepSeek 服务器处理。处理客户身份证、病历、内部财报这类数据前,请先脱敏,或改用开源权重在自己服务器本地部署。这样数据完全不出内网,合规风险降到最低。
总结 如何根据自身需求用好 DeepSeek
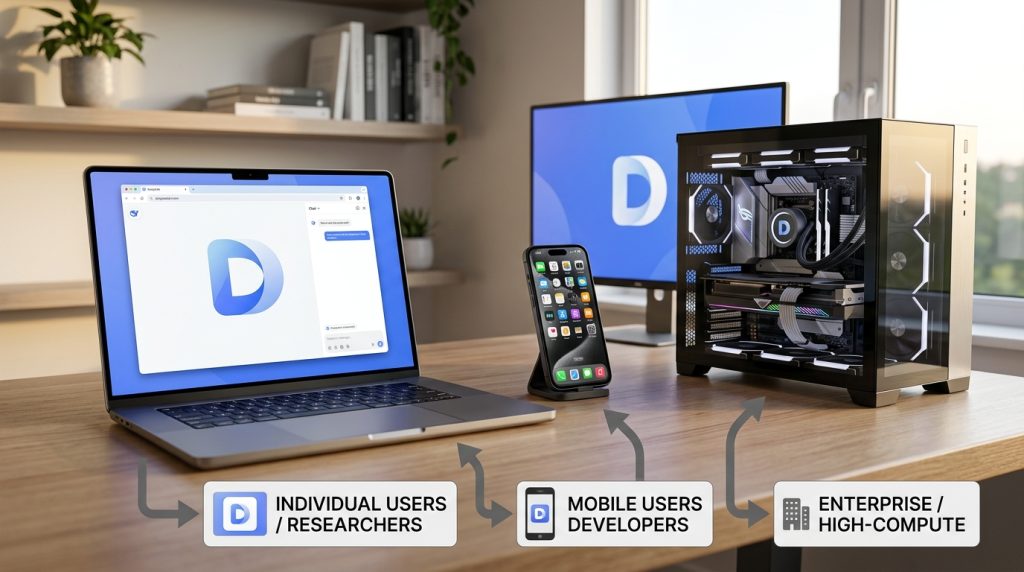
用好 DeepSeek AI 的核心逻辑就一句话:先按任务选模型,再按数据敏感度选部署方式。日常问答和写作用 V3,多步推理用 R1,写代码用 Coder。想上手,直接打开deepseek-app.org免费聊,验证效果后再决定要不要接 API。
不同用户的行动清单不一样,别照搬。
- 零基础个人用户:只用网页版或手机 App,不碰 API。写文案、翻译、查资料够用,一分钱不花。
- 轻度开发者 / 小项目:先在网页版试出可用的提示词,再接开放平台 API。V4.1-Flash 输入每百万 token 仅 US$0.14,跑几千次调用也就几块钱,验证阶段几乎零成本。
- 处理敏感数据的团队:跳过官方云服务,走开源权重本地部署。默认对话数据存在中国境内服务器,受监管数据必须离线跑,才不踩合规红线。
一条实操建议:任何接入前,先用免费网页版做至少 20 次真实任务测试,记录哪些答对、哪些跑偏。这个步骤能帮你提前发现模型短板,省下后期改代码的时间。
DeepSeek 的最大优势是低成本加开源自由,但这不等于适合所有场景。选对模型、算清账、守住数据边界,它就是你手里最划算的一套 AI 工具。