7 个关键维度看 DeepSeek 大模型 架构能力成本全拆解
DeepSeek是一家总部位于中国杭州的 AI 研究公司,由梁文锋于 2023 年 5 月创立,以开源和低成本著称,尤其擅长中文推理与代码生成。它主打三条产品线:V3 做通用对话、R1 做深度推理、Coder 做编程,其中 R1 是 671B 参数的 MoE 模型。约 500 万美元的预训练算力开支和每百万 token 低至 约 $0.14 的 API 定价,使其数学与逻辑基准表现与 GPT-4o、Gemini 打成平手。
核心要点
- DeepSeek 由梁文锋 2023 年 5 月创立于杭州,主攻开源大模型
- R1 为 671B 参数 MoE 模型,专攻数学、逻辑与代码推理
- 预训练算力仅约 500 万美元,靠 MoE 架构省算力
- API 输入每百万 token 低至 约 $0.14,权重开源可本地部署
- 选型看任务:快聊用 V3,难题推理用 R1,编程用 Coder
关键速览
- DeepSeek 成立于 2023 年 5 月,总部位于中国杭州,主攻开源大模型
- 核心架构采用 MoE(混合专家),推理时只激活部分参数,省算力
- 约 500 万美元的预训练算力开支来自架构效率,是其最受关注的技术亮点
- 模型权重开源,可本地部署,API 输入每百万 token 低至 约 $0.14
- R1 的代码与中文推理能力在数学、逻辑基准上与 GPT-4o、Gemini 打成平手
DeepSeek 是什么?一句话讲清它的定位
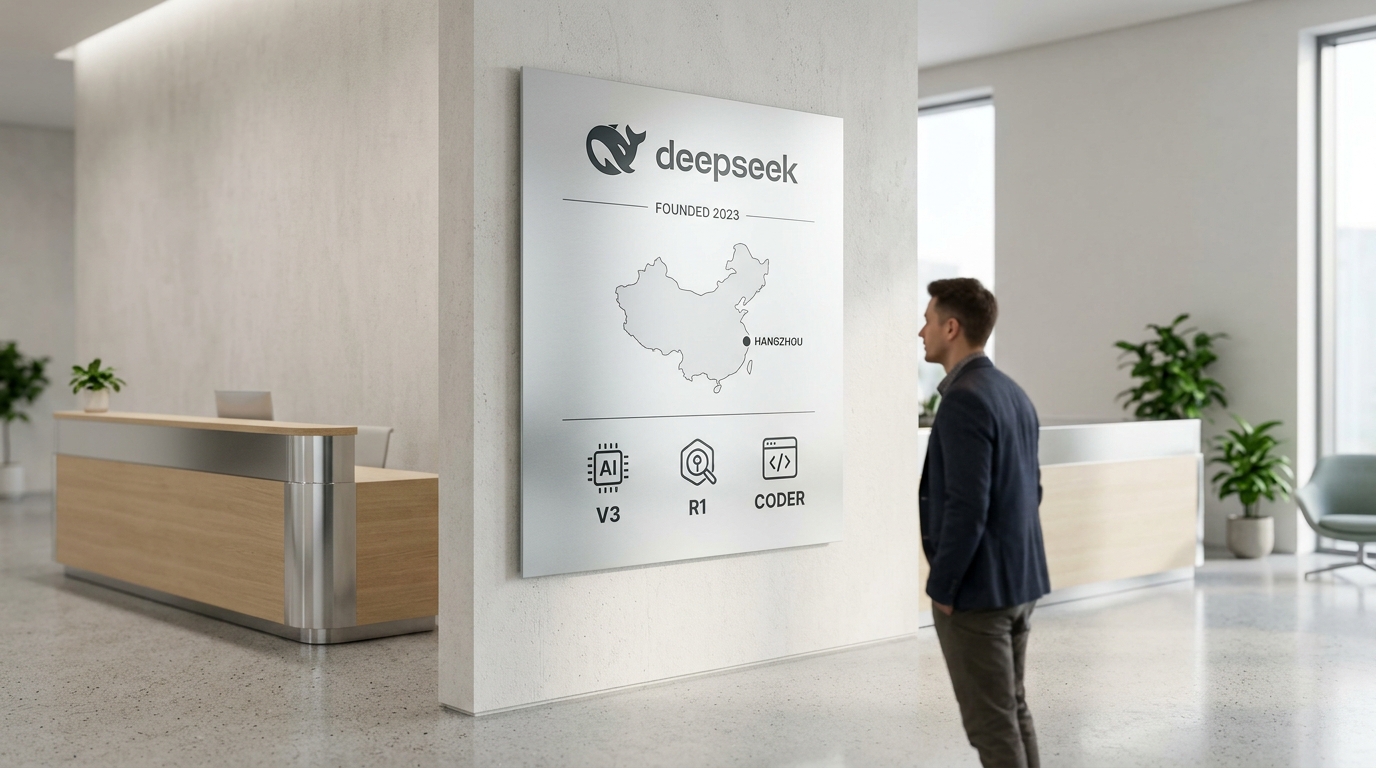
DeepSeek 是一家总部位于中国杭州的 AI 研究公司,由梁文锋于 2023 年 5 月创立、同年 11 月发布首个模型,以开源和低成本著称,尤其擅长中文推理与代码生成。它的定位是做”人人用得起的前沿大模型”,官网自述目标是构建通用人工智能(AGI,指能像人一样处理各类任务的 AI)。它由量化投资机构幻方量化孵化,法定名称为杭州深度求索人工智能基础技术研究有限公司,2025 年员工仅 160 人,用一支百人规模的团队做出与国际头部模型掰手腕的产品,这本身就是它出圈的原因。
真正让 DeepSeek 走进大众视野的是 2025 年 1 月。那个月 DeepSeek-R1 推理模型和移动聊天应用同时发布,迅速引发国际关注,一度冲上多国 App 商店免费榜首。R1 是一款 671B 参数的 MoE(混合专家,指每次只激活部分参数以省算力)推理模型,专攻数学、代码和逻辑推理。
DeepSeek 有哪些模型?V3、R1、Coder 分别适合什么场景
DeepSeek 主力有三条产品线:V3 做通用对话,R1 做深度推理,Coder做编程。其中 DeepSeek-R1 于 2025 年 1 月发布,是一个 671B 参数的 MoE 模型(混合专家,即每次只激活部分参数以省算力),专攻推理、数学与代码。选型看任务:要快聊天选 V3,要推公式、解难题选 R1。
| 模型 | 定位 | 推荐场景 |
|---|---|---|
| V3 | 通用对话 | 日常问答、写作、翻译 |
| R1 | 深度推理 | 数学证明、复杂逻辑、代码调试 |
| Coder | 编程专用 | 代码补全、多语言开发 |
中文用户日常用 V3 足够;遇到需要”想一步再答”的难题,切 R1。R1 由 V3 微调而来,而非从零重训,因此推理更强但每次要先输出思考链,响应更慢。
DeepSeek 的技术架构有什么特别?为什么训练成本这么低
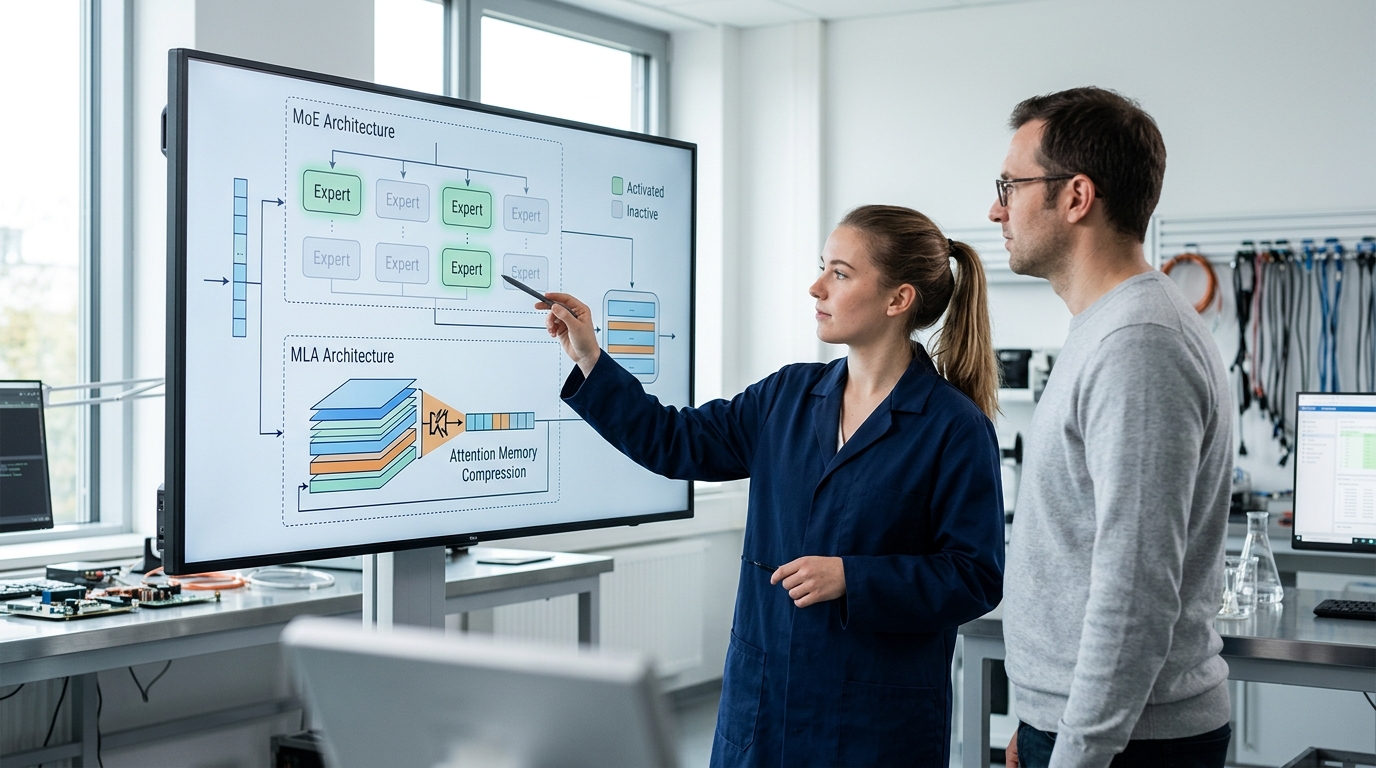
DeepSeek 训练成本低,核心靠三样架构设计:MoE 混合专家(每次只激活部分参数)、多头潜在注意力 MLA(压缩显存占用),以及用强化学习直接训练推理能力。据 IBM 2026 年的分析,DeepSeek-R1 是在 V3 基础上微调得到的推理模型,并非从零重训,这一条就省下大量算力。
业界广泛报道的约 500 万美元训练成本,只算最后一次预训练的 GPU 租用费,不含前期研发、试错和数据成本,因此这个数字真实但不完整。换句话说,真正的低成本来自上面三样架构效率,而非某个”便宜”的采购渠道。
DeepSeek 和 ChatGPT、Gemini 相比谁更强?中文实测对比
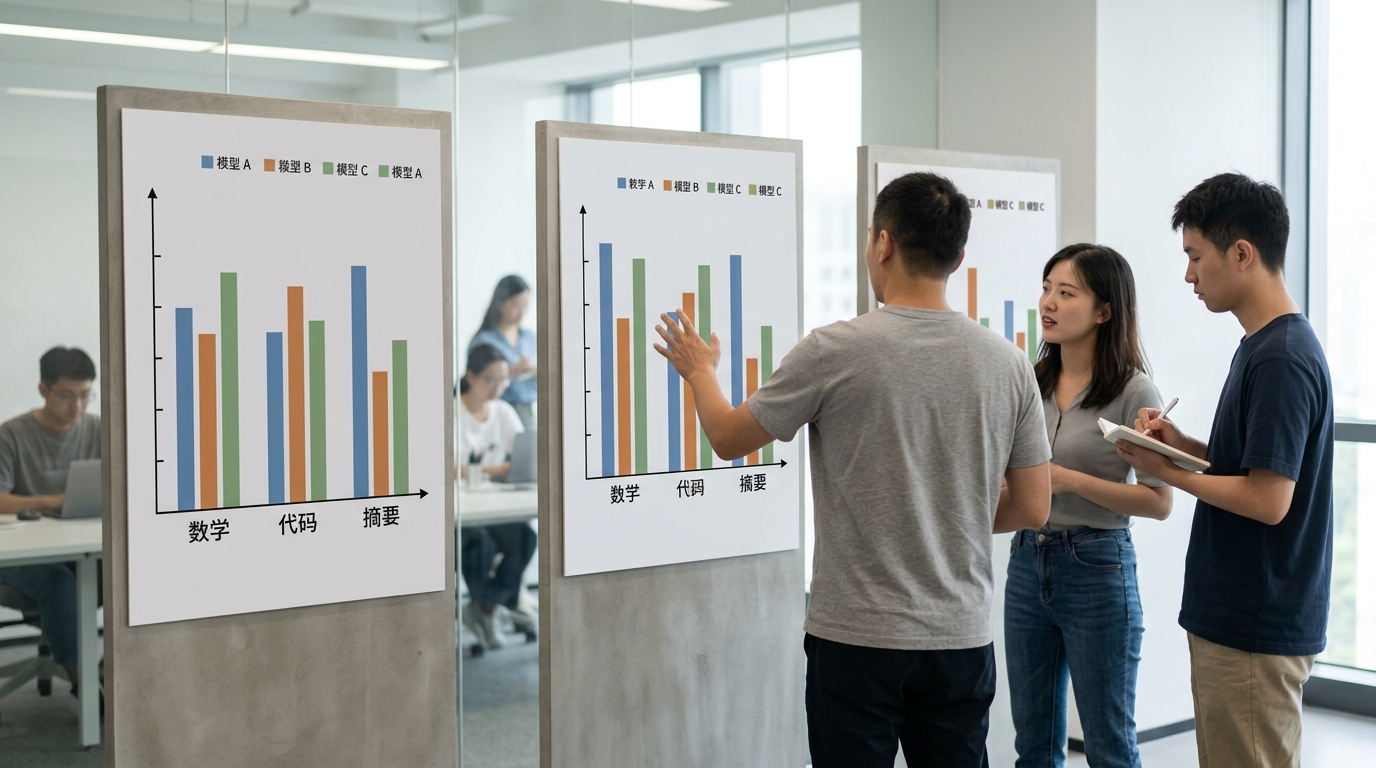
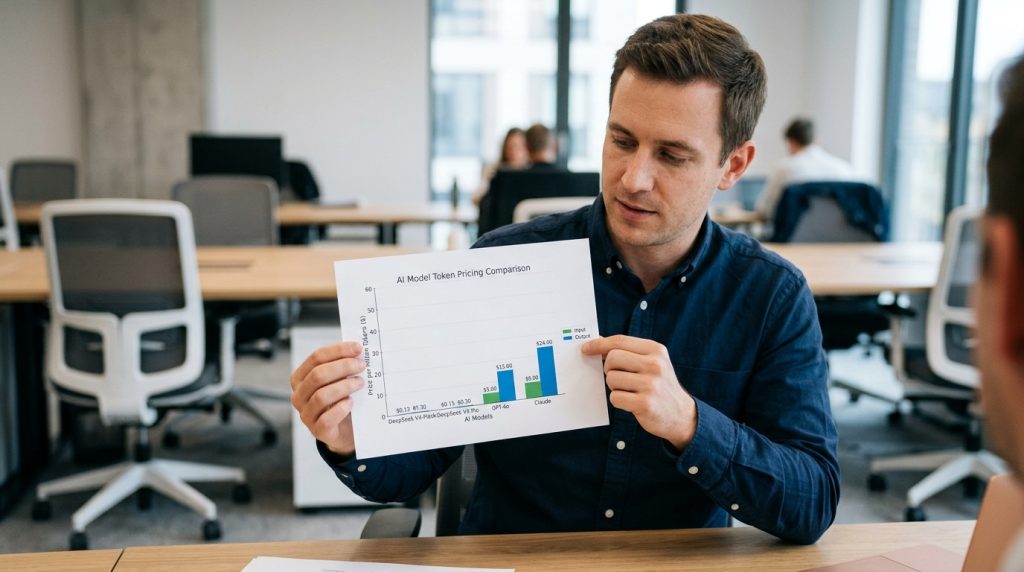
中文数学题和代码生成上,DeepSeek-R1 与ChatGPT、Gemini 打成平手甚至略优,分不出绝对胜负,但价格差距悬殊,这才是选型的分水岭。据 TechRadar 2026 评测,DeepSeek API 每百万 token 输入低至 约 $0.14,远低于主流闭源模型。对预算敏感的开发者,同等能力下便宜一个数量级,就是最直接的选它理由。
⚠️ 常见错误: 把”约 500 万美元训练成本”当作 DeepSeek 全部研发投入。原因是这个数字只算最后一次预训练的 GPU 租用费,不含前期研发、试错和数据成本,真实但不完整。修复:引用时注明这是单次预训练算力开支,低成本真正来自 MoE、MLA 等架构效率。
| 模型 | 输入价(每百万 token) | 输出价 |
|---|---|---|
| DeepSeek V4 Flash | $0.14 | $0.28 |
| DeepSeek V4 Pro | $1.74 | $3.48 |
中文长文摘要场景,R1 会先输出完整推理链再给结论,适合合同、论文这类需要”想清楚再答”、经不起漏读条款的任务。
普通人怎么用上 DeepSeek?网页、App 与 API 三种方式实操
普通人用 DeepSeek 有三条路:网页版和手机 App 都完全免费、无付费订阅层级,只需邮箱或手机号注册;开发者才需调用付费 API。据 TechRadar 2026 年评测,聊天端不设会员墙,API 的 V4 Flash 每百万 token 输入仅 $0.14。日常问答选网页,批量任务才走 API。
网页、App 和 API 分别怎么开始用?
网页最快:打开官网点登录、验证手机号即可对话,右上角可开「深度思考(R1)」和「联网搜索」两个开关。App 在应用商店搜 DeepSeek 下载,登录后与网页数据同步。API 需在开放平台建密钥,填进代码的 base_url,兼容 OpenAI SDK,支持 JSON 输出与函数调用(function calling,即让模型自动调外部工具)。
- 网页版:响应最稳,适合长对话和文件上传
- 手机 App:高峰期偶有排队,适合随手提问
- API:延迟最低、可并发,按量计费无免费额度
中文提问技巧:先给角色和背景,再提具体要求。别写「帮我写文案」,改写成「你是家电客服,用 3 句话回复退货投诉」。复杂题加一句「先列步骤再给答案」,能触发 R1 的推理链,准确率明显提升。
用 DeepSeek 要注意什么?数据隐私、合规与境内外使用差异
用 DeepSeek 最该注意的是数据存储地。DeepSeek 的法定实体位于中国浙江杭州(2025 年员工 160 人),官方服务默认把用户输入存在中国境内服务器。这意味着企业别把客户名单、合同、源码等敏感信息直接投喂,一旦跨境合规审查,风险很高。
境内外访问也不同:
大陆用户直连网页版和 App;海外部分政府机构已限制在办公设备上使用。若要处理机密数据,更稳的做法是下载开源模型自建部署,把数据留在本地,而非走公有 API。
总结:什么样的人最该用 DeepSeek
预算敏感、重视中文、需要写代码或深度推理的人最该用 DeepSeek。据 TechRadar 2026 评测,其 V4 Flash 输入每百万 token 仅 $0.14,且网页版全免费。三类人对号入座即可。
- 预算敏感者:先用免费网页版跑真实任务,确认满意再考虑付费 API 或本地部署,别急着上会员。
- 重视中文者:DeepSeek 擅长中文推理,写作、翻译、长文本理解都顺手。
- 开发者:R1 的 671B MoE 模型专攻数学与代码,支持 function calling,适合搭 agentic 工作流。
企业别把敏感数据投喂境内服务器,如前所述这会带来跨境合规风险。先小样本试,再决定路线。