深度解析 DeepSeek AI 的 5 个核心能力与应用场景
deepseek ai是中国深度求索实验室开发的开源大语言模型系列,官方主站为www.deepseek-app.org,聊天入口 deepseek-app.org,网页对话免费。旗舰 DeepSeek-V3 采用 MoE 架构,总参数 671B,每个 token 仅激活 37B;V4-Flash 输入每百万 tokens 仅 约 $0.14。R1 推理模型会先输出思维链,专攻数学、逻辑与复杂编程任务。
核心要点
- 访问deepseek-app.org网页对话,免费即可上手体验
- 日常问答写作选 V3,复杂推理数学代码切 R1
- R1 会输出思维链,简单任务用它多花几倍 token
- V4-Flash 输入每百万 tokens 仅 0.14 美元,成本极低
- 模型权重开源,中小团队可本地部署不锁云厂商
关键速览
- 官方主站www.deepseek-app.org,聊天入口deepseek-app.org,网页对话免费。
- 核心能力覆盖代码生成、数学推理、长文本理解、多轮对话、中英双语处理。
- 模型权重开源,开发者可本地部署,不必依赖单一云服务商。
- API 按 token 阶梯计费,V4-Flash 输入每百万 tokens 仅 约 $0.14。
- R1 推理模型会先输出思维链,适合数学、逻辑与复杂编程任务。
DeepSeek AI 到底是什么?由哪家实验室打造?
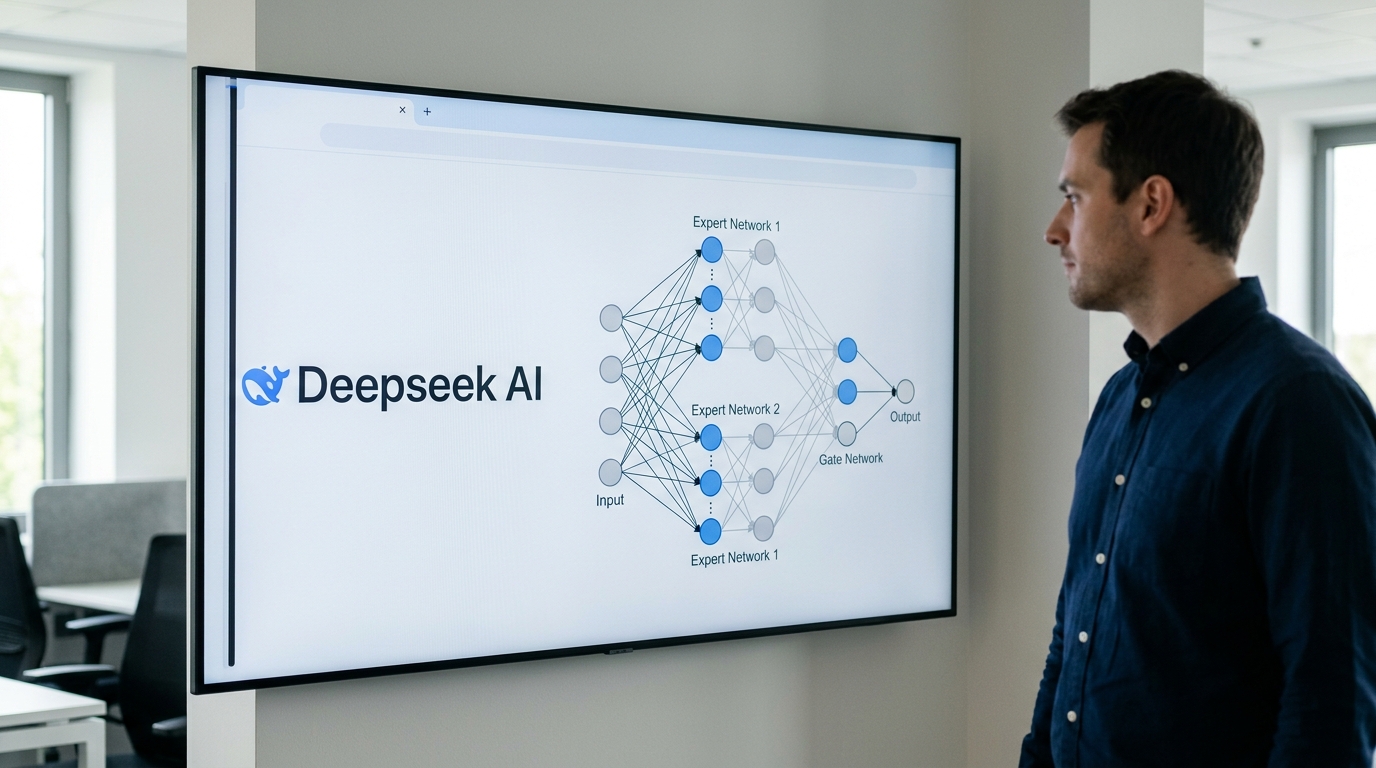
DeepSeek AI 是由中国杭州幻方量化旗下深度求索实验室开发的大语言模型系列。它的核心定位是开源加低成本:其旗舰 DeepSeek-V3 采用混合专家(MoE,即模型只激活部分参数以省算力)架构,总参数 671B,每个token仅激活 37B。官网入口是www.deepseek-app.org。
DeepSeek 在 2025 年凭借移动聊天应用和推理模型 DeepSeek-R1 获得国际关注,官方文档至今公开列出 V3 与 R1 供 API 调用,权重开源可自行部署。这意味着中小团队无需从零训练,只靠下载开源权重就能拿到接近头部水平的模型。
DeepSeek R1 和 V3 有什么区别?分别适合什么场景?
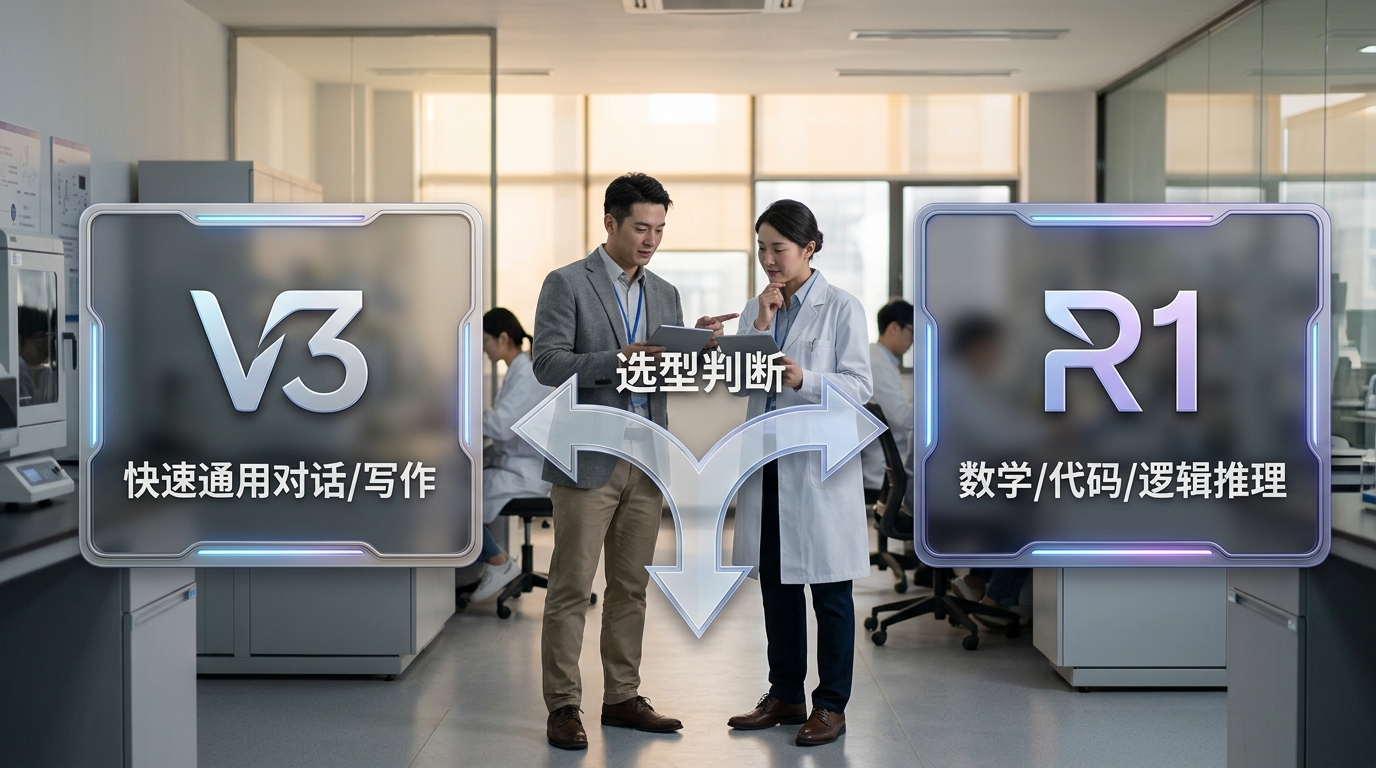
简单记:日常问答、写作用 V3,复杂推理用 R1。V3 是通用对话模型,响应快、成本低;R1 是推理模型,2025 年更新到 R1-0528,会先输出思维链(一步步推导过程)再给答案,适合数学、代码、逻辑题。两者在 DeepSeek 官方 API 里都可直接调用,模型名分别对应 deepseek-chat 与 deepseek-reasoner。
选型的关键是别为简单任务付推理税:
能一句话答清的任务别用 R1,它的思维链会多消耗几倍 token,拖慢速度还多花钱。翻译、改写、客服问答交给 V3;金融建模、算法调试、多步推导才切 R1。
DeepSeek 和 ChatGPT、Claude、通义千问哪个更好?
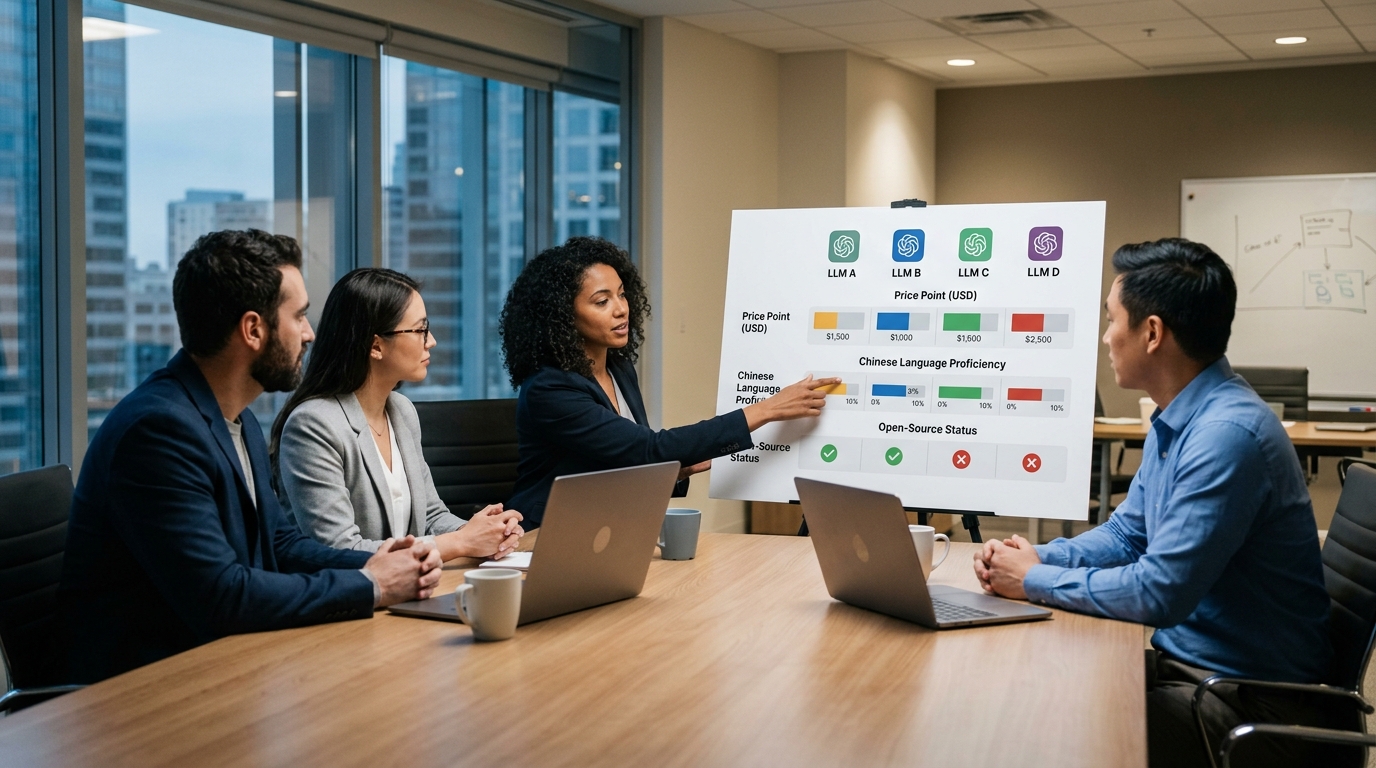
没有单一答案,要看任务:在中文推理和成本上 DeepSeek AI 领先,V4-Flash 输入每百万 tokens 仅 约 $0.14,远低于同档闭源模型;代码和复杂推理靠 R1;但多模态和生态成熟度不及ChatGPT。开源可自部署是它相对三家闭源模型的独有优势。
| 维度 | DeepSeek | ChatGPT | Claude | 通义千问 |
|---|---|---|---|---|
| 输入价($/百万 tokens) | 0.14 | 较高 | 较高 | 中等 |
| 开源可自部署 | 是 | 否 | 否 | 部分 |
| 中文表现 | 强 | 较强 | 中等 | 强 |
| 多模态成熟度 | 弱 | 强 | 中等 | 中等 |
短板要说清:DeepSeek 的图像、语音等多模态能力明显落后。据此分流,追求生态和插件,选 ChatGPT;预算敏感或要私有部署,DeepSeek 更划算。
DeepSeek API 怎么收费?调用成本实测对比是多少?
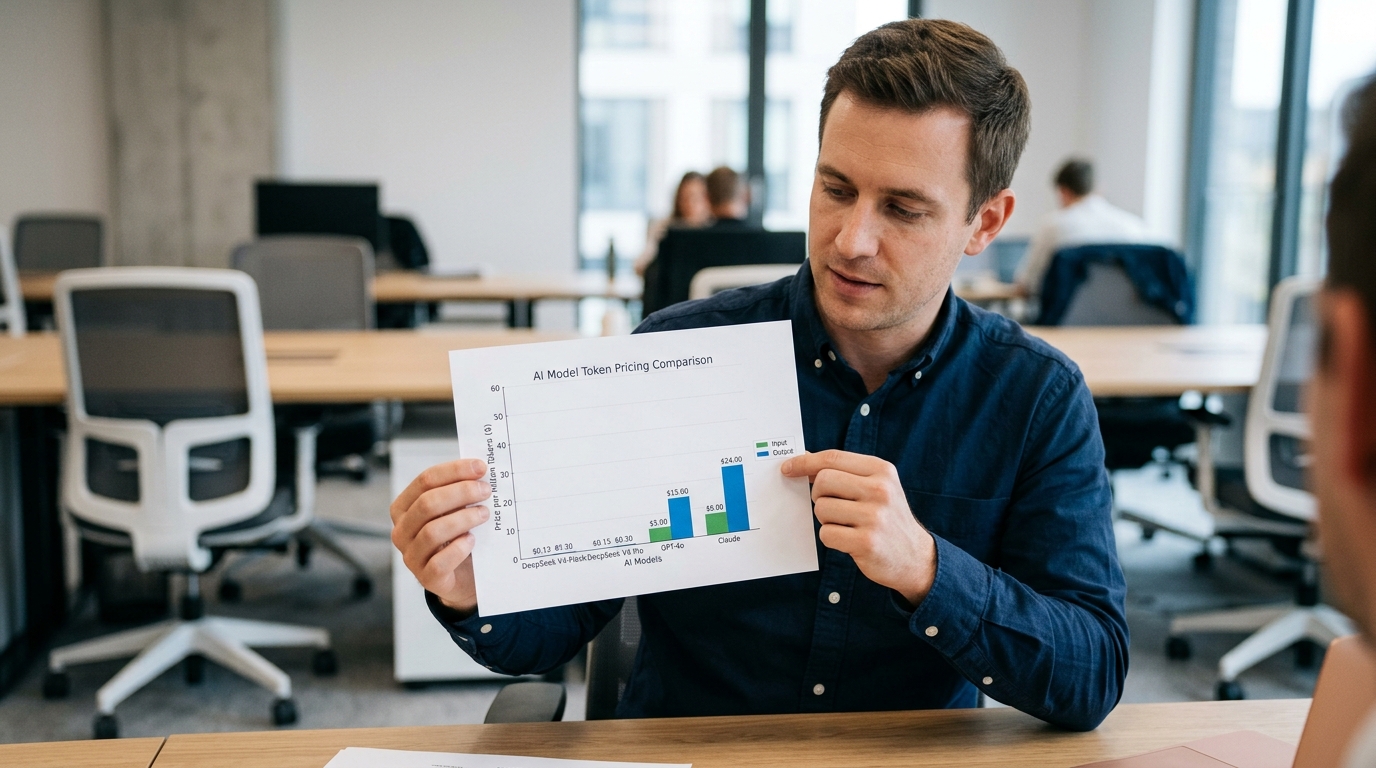
DeepSeek AI 按 Token 阶梯定价:2026 年官方标价显示,V4-Flash 输入每百万 tokens 约 $0.14、输出 $0.28;V4-Pro 输入 $0.435、输出 $0.87。命中缓存(重复的输入内容不重算)的部分还有折扣,反复带同一段长上下文的任务省得最多。
⚠️ 常见错误: 对翻译、改写、客服等简单任务也用 R1 推理模型。原因 R1 会先输出思维链逐步推导,比 V3 多消耗几倍 token,速度更慢、花费更高。修复:日常问答写作用 V3(deepseek-chat),只在数学、算法、多步推导时切 R1(deepseek-reasoner)。
| 模型 | 输入/百万 tokens | 输出/百万 tokens |
|---|---|---|
| V4-Flash | $0.14 | $0.28 |
| V4-Pro | $0.435 | $0.87 |
算一笔账:一个 10 万输入 + 5 万输出的任务,用 V4-Flash 约 $0.028;同规模走 GPT-4o 或 Claude 主力档,费用常高出一个数量级。省成本就选 Flash,复杂推理再切 Pro。
DeepSeek AI 能用来做什么?代码、文本与多模态实战场景
DeepSeek AI 最擅长四类活:代码补全、长文写作、数据分析、文档问答。据 DeepSeek-V3 的 GitHub 仓库,V3 是 671B 总参数的 MoE 模型,处理长上下文时每 token 只激活 37B 参数,所以吞长文档快、成本低。用 R1 跑代码调试,用 V3 批量改写文档,这是最省钱的分工。
具体到场景:
写 SQL 或 Python 补全交给 R1,它会先输出思维链定位逻辑错误;而几万字合同做条款问答,V3 的长上下文更划算。多模态是短板,DeepSeek 目前以文本和代码为主,图像、语音识别能力远不及 ChatGPT,涉及图表识别的任务请另选工具。
国内怎么注册和调用 DeepSeek?数据安全合规要注意什么?
注册 DeepSeek AI 只需两步:访问官方主站www.deepseek-app.org或聊天入口deepseek-app.org,用手机号或邮箱登录即可对话;调 API 则进开发者平台,实名后在控制台生成 API Key,直接填进请求头 Authorization: Bearer 就能跑通,模型名填 deepseek-chat 或 deepseek-reasoner。
企业接入前先做两件合规动作:
一是查数据存储位置,国内业务优先选境内部署或本地私有化,避免跨境传输触碰《数据出境安全评估办法》红线;二是把身份证号、手机号等敏感字段在调用前脱敏(用占位符替换),别把原始个人信息直接送进 API 接口。这样既留了可追溯日志,又降低了泄露风险。
落地 DeepSeek 常见的三个误区与风险点
落地 DeepSeek AI 最常踩的三个坑是:全程用 R1、忽略上下文长度、把敏感数据直接丢公有云。第一个坑最烧钱,2026 年官方标价显示 V4-Pro 输出每百万 tokens $0.87,是 V4-Flash($0.28)的三倍多。规避方法:简单问答走 V4-Flash,只在数学、代码这类复杂推理任务上切 R1。
- 误区一:无脑上 R1:R1 会先输出思维链,token 消耗更大。日常任务用它,账单直接翻 3 倍。
- 误区二:忽视上下文窗口:超长文档一次全塞进去会被截断,答案漏内容。做长文问答时要先切片,再分批检索。
- 误区三:敏感数据进公有云:合同、用户隐私走公有 API 有合规风险。这类数据应走私有化部署或做脱敏处理再调用。
归纳成一条落地顺序:先按任务分流模型省成本,再对敏感场景做本地化。
总结 如何根据需求选对 DeepSeek 版本
选 DeepSeek AI 版本记三句话:日常对话用 V4-Flash,复杂推理用 R1,敏感数据走私有化部署。据 官方 2026 年标价,Flash 输出每百万 tokens 仅 $0.28,Pro 达 $0.87,三倍差价意味着能用 Flash 就别默认拉满。
起步路径很清晰
先在deepseek-app.org免费试用摸清模型脾气,再去开发者平台生成 API Key 接入 Flash,最后按业务量决定是否升级 Pro 或本地部署。合规是硬门槛:涉及用户隐私、金融或医疗数据,直接选私有化,别把明文丢公有云。deepseek 的思路一贯是省算力、压成本,选型时把这条内化成习惯就够了。