7 个关键维度看懂 DeepSeek 的能力边界与优势
DeepSeek 是一家中国 AI 研究公司,专注开发开源前沿大语言模型,由量化机构幻方量化于 2023 年孵化。其 V3 模型采用混合专家(MoE)架构,总参数达 6710 亿,但每个 token 仅激活 370 亿,单次推理算力开销约为稠密模型的二十分之一。产品线分为 V3 通用对话与 R1 逻辑推理两条线,API 调用成本远低于同级闭源模型。
核心要点
- V3 总参 6710 亿但每 token 仅激活 370 亿,省九成算力
- 选型分工:V3 走通用对话,R1 专攻数学逻辑推理
- R1 数学能力接近 o1,开源可查且价格仅几分之一
- 高频批量调用优先选 DeepSeek,API 成本远低于闭源
- 需实时联网或复杂长文本记忆时,另选工具补短板
关键速览
- DeepSeek 官方定位为 AI 研究公司,主攻前沿大语言模型开发
- 推理模型走「思维链」路线,擅长数学、逻辑与多步骤代码任务
- API 调用成本远低于同级闭源模型,适合高频批量场景
- 中文语料训练充分,中英双语理解能力是核心优势之一
- 实时联网、事实时效性、复杂长文本记忆仍是明显短板
DeepSeek 是什么?为什么被称为中国 AI 大模型挑战者?
DeepSeek 是一家定位为 AI 研究公司的中国团队,专注开发开源前沿大语言模型(LLM,即能理解和生成文字的大型 AI 系统)。它成立于 2023 年,由量化投资机构幻方量化(High-Flyer)孵化并资助,这一背景让它有算力和资金去做长期基础研究,而非快速变现的消费级产品。
它被视为挑战者,靠的是硬指标而非营销
V3 模型拥有 6710 亿总参数,但每个 token 只激活 370 亿参数,这种”混合专家”架构让它在保持大脑容量的同时省下大量算力。产品线一分为二:V3 负责通用对话,R1 专攻逻辑推理,两条线覆盖了从日常问答到数学证明的主流场景。
DeepSeek 的工作原理是怎样的?低成本训练如何实现?
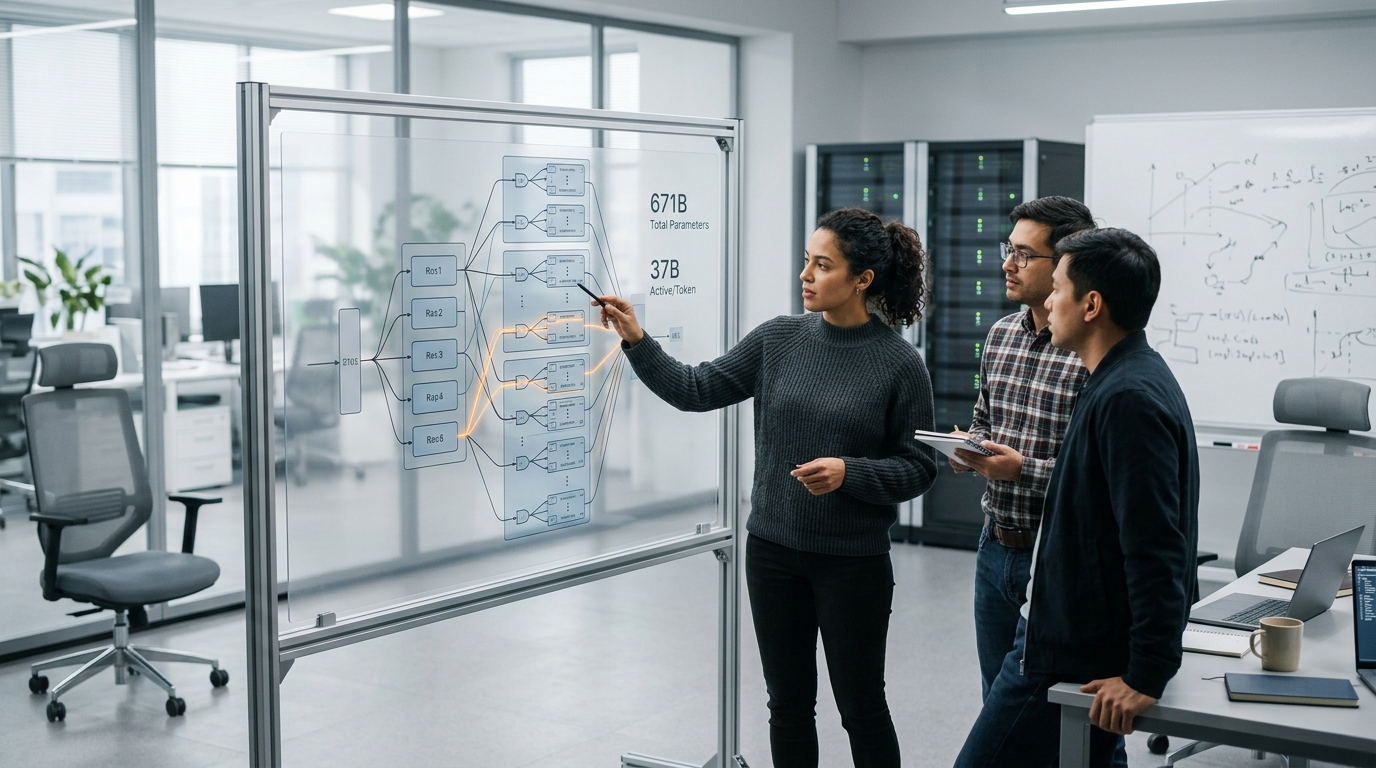
DeepSeek 靠 MoE(混合专家)架构省钱:模型有海量参数,但每次只激活一小部分。V3 的 GitHub 仓库说明,该模型共 6710 亿参数,但每个 token 只激活 370 亿,相当于养了一屋子专家,每次只请最对口的几位干活,单次推理的算力开销只有稠密模型的约二十分之一。
省钱不止靠 MoE
配合 MLA(多头潜在注意力,一种把注意力键值压缩后再存储的机制),显存占用进一步降低,长上下文推理时尤其明显。两项技术叠加,DeepSeek 才能用远低于同级模型的成本逼近顶尖水平。
DeepSeek R1 推理模型与 OpenAI o1 逐题实测谁更强?
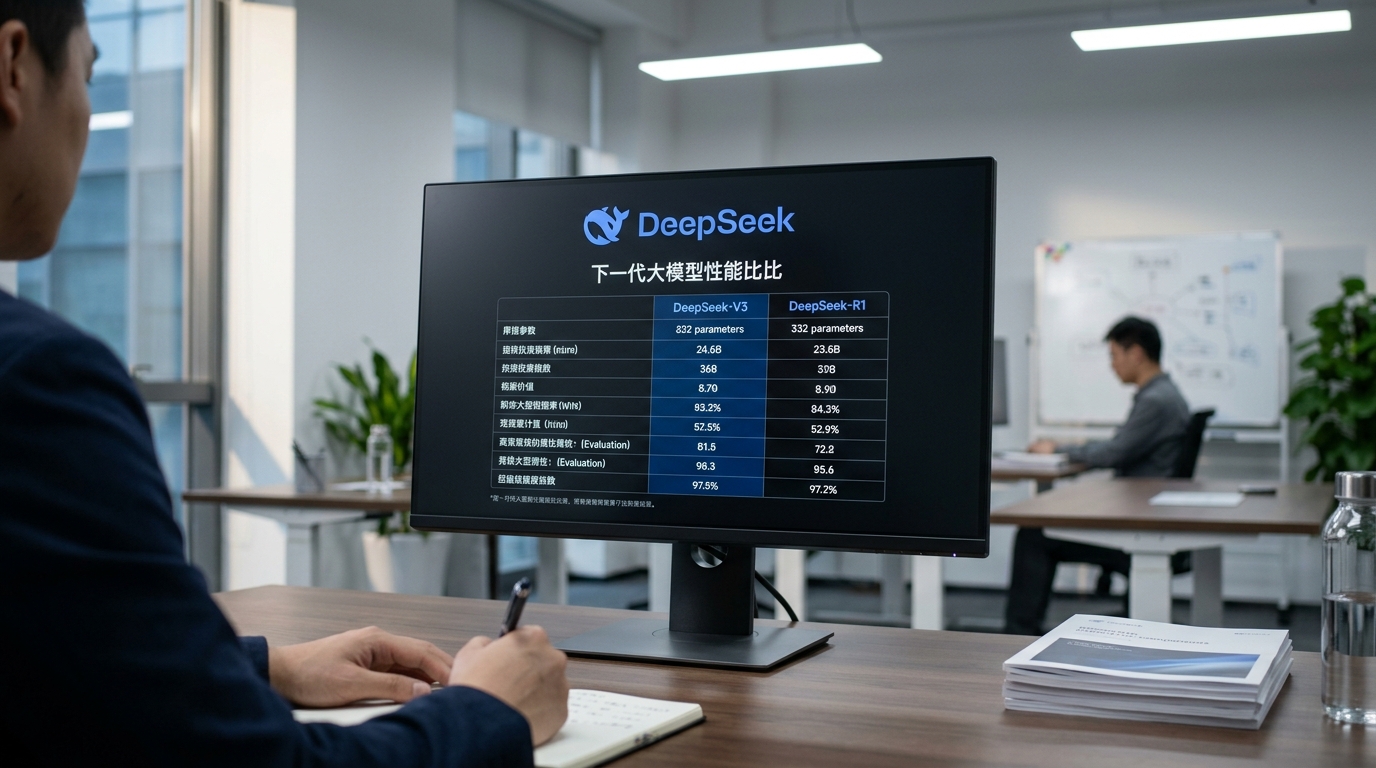
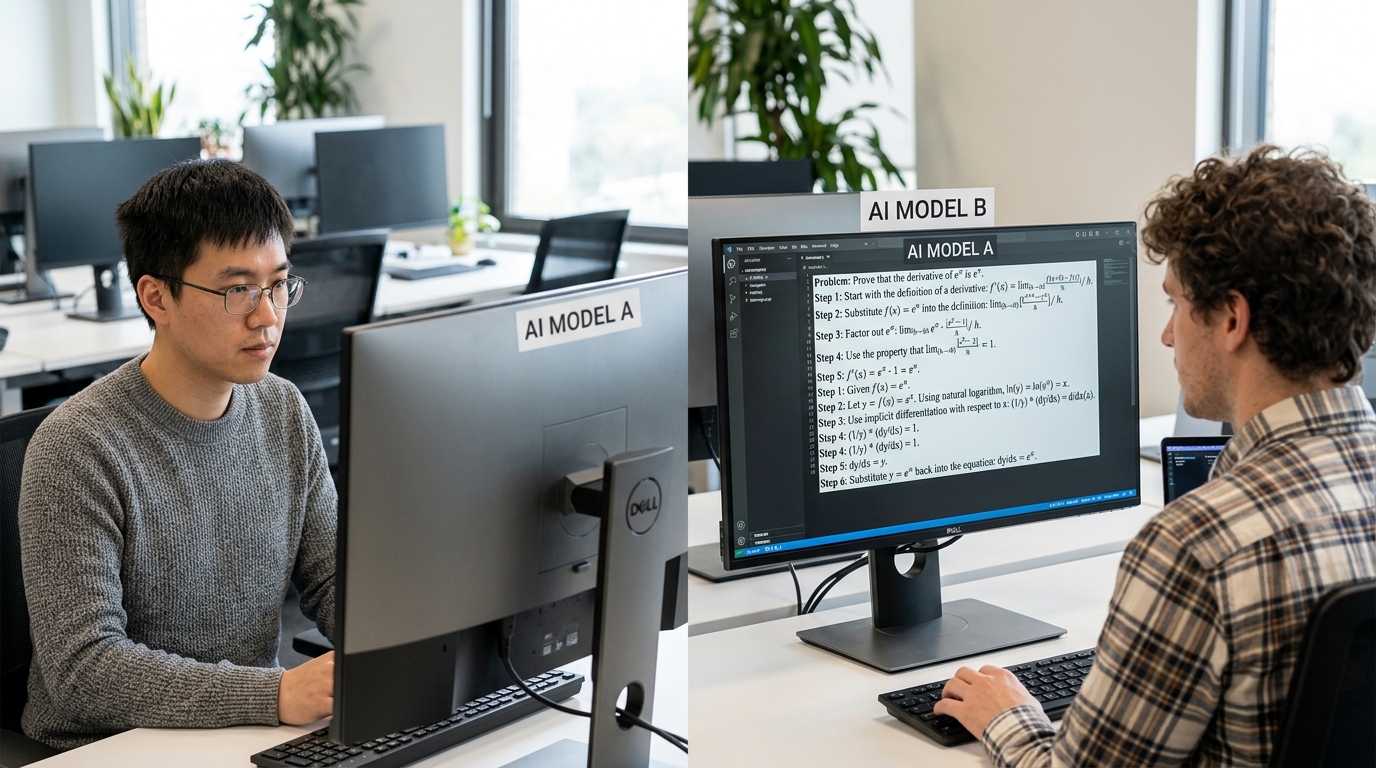
DeepSeek R1 与 OpenAI o1 在数学、逻辑、代码三类题上互有胜负:R1 在数学竞赛题上正确率接近 o1,且思维链(模型逐步推理的文字过程)完整可读、开源可查;o1 在需要连续多轮调试的复杂代码任务上略稳。
R1-0528 于 2025 年 5 月发布,支持 JSON 输出与函数调用,便于把推理结果直接接入程序。对多数用户,R1 的开源与低价意味着能用更小成本拿到接近 o1 的推理效果,差距不大,但预算差好几倍。
DeepSeek 与 ChatGPT、Claude、Gemini 在中文和代码上表现如何?
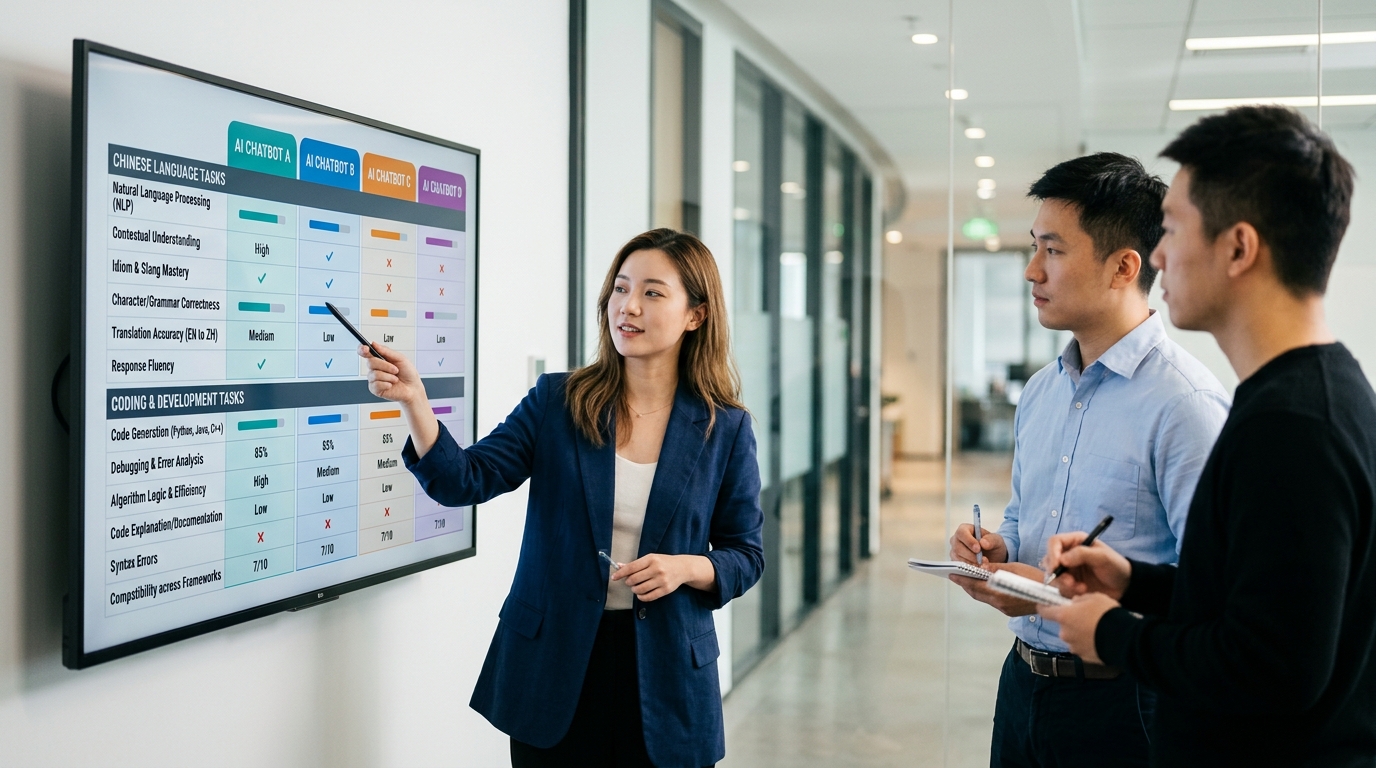
四家各有胜场:DeepSeek 在中文理解和成本上占优,Claude 在长文写作更稳,ChatGPT 与 Gemini 在多模态和生态上领先。具体到中文与代码这两项,DeepSeek 的代码生成能与三家打平,而中文理解领先,加上 DeepSeek-V3.1 的 API 每百万 token 输入仅 0.56 美元(2026),价格显著低于同级闭源模型,中文场景高频调用时选它最省钱。
⚠️ 常见错误: 把 DeepSeek 当搜索引擎查实时信息,如问今天股价或最新新闻。原因:R1-0528 默认不联网,会用旧训练数据编造看似合理却错误的答案(幻觉)。修复:时效性问题改用联网工具,DeepSeek 只做代码、中文改写与结构化分析。
| 模型 | 中文理解 | 代码生成 | 百万token价 |
|---|---|---|---|
| DeepSeek | 强 | 强 | 0.56 美元 |
| Claude | 中 | 强 | 较高 |
| ChatGPT | 中 | 强 | 较高 |
| Gemini | 中 | 中 | 较高 |
DeepSeek 能做什么、不能做什么?常见误用案例有哪些?
DeepSeek 擅长代码补全、中文文本改写和结构化数据分析,但不擅长提供实时信息、也会产生幻觉(编造看似合理却错误的内容)。据 TechTarget 2026 年的说明,DeepSeek-R1-0528 支持 JSON 输出与函数调用(function calling),适合接入自动化流程;但它不联网,答不出今天的股价或新闻。
最常见的误用正源于此:
让它当搜索引擎查”最新政策”,结果被编造的法条坑到。正确做法是把要点粘进提示词,让它做整理而非检索。长文档处理时也要警惕,即便 V4.1-Flash 支持百万 token 上下文,中段信息仍可能被漏掉,关键条款务必人工复核。
如何注册使用 DeepSeek API?开源许可证和数据隐私有哪些限制?
注册 DeepSeek 分两条路:网页版deepseek-app.org用手机或邮箱注册即可免费聊天;API 需在开放平台创建密钥,按量付费。TechTarget 2026 年数据显示,DeepSeek-V3.1 每百万 token 输入 0.56 美元、输出 1.68 美元,远低于同级闭源模型。开源权重采用宽松许可,可商用,但数据存于中国境内,企业需评估合规风险。
合规风险有两种解法:
模型权重开源可自部署,请求全程留在内网,能绕开数据出境顾虑;但若直接调用官方 API,请求会经中国服务器,欧盟或政府客户往往因此转向本地部署。
总结与如何选择适合你的 DeepSeek 使用方式
选DeepSeek版本,先看三件事:预算、场景、隐私。网页版免费、适合日常问答;API 便宜(V3.1 每百万 token 输入仅 0.56 美元,2026 年数据)、适合开发者集成;本地部署最安全、适合处理敏感数据。三者对应下面三类人:
- 零预算、想试水的普通用户:直接用免费网页版deepseek-app.org,做中文改写、代码补全够用。
- 开发者、需批量调用:走 API,按量付费,支持 JSON 输出和函数调用,方便接入自己的系统。
- 企业、数据不能出内网:下载开源权重本地部署,蒸馏版普通显卡就能跑,规避隐私风险。
不适合谁?
需要实时新闻、股价的用户别指望DeepSeek,它不联网,还会产生幻觉(编造错误内容)。先小范围试用,再决定要不要迁移生产环境。